엔비디아 블랙웰 기반 'GPT-6 아스트라 울트라패스트' 공개
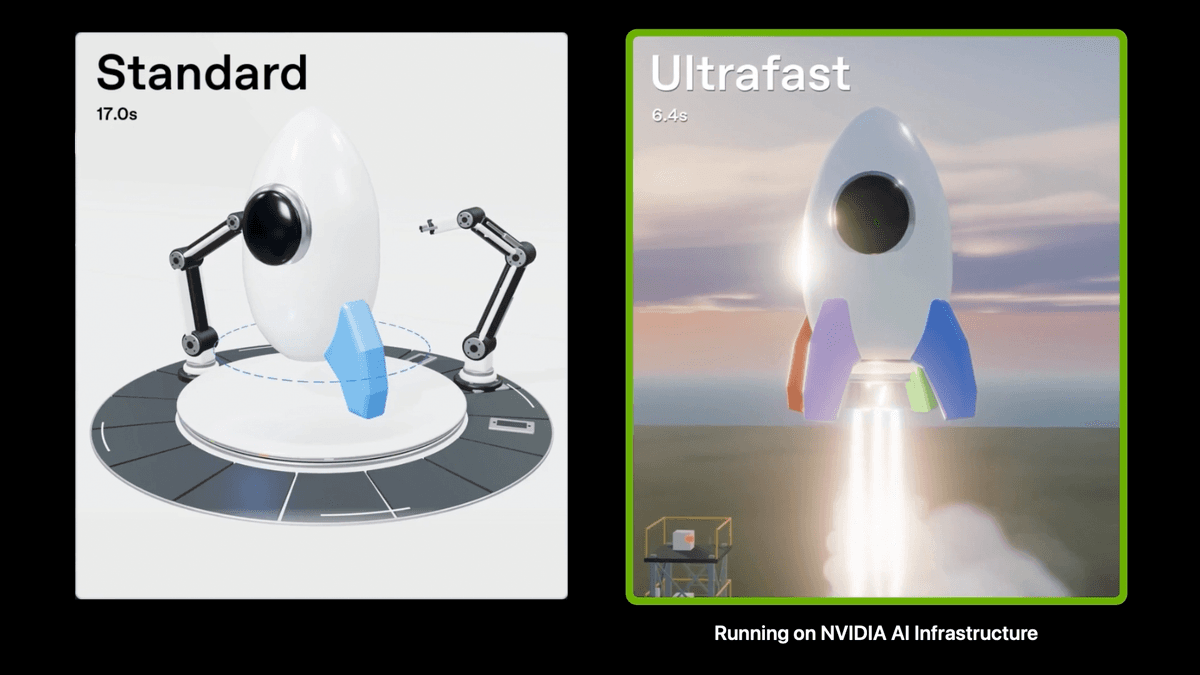
엔비디아와 오픈AI는 차세대 인프라인 블랙웰(Blackwell) GPU 아키텍처를 기반으로 추론 속도를 대폭 개선한 서비스 티어 'GPT-6 아스트라 울트라패스트(Astra Ultrafast)'를 공식 출시했다고 밝혔다. 이번 서비스는 별도의 경량화 소형 모델을 새로 학습시킨 것이 아니라, 기존 플래그십 모델인 GPT-6 아스트라를 유지하면서 하드웨어 맞춤형 연산 최적화를 적용한 형태다.
오픈AI는 자체 모델을 활용해 엔비디아 블랙웰 및 차세대 루빈(Rubin) GPU 환경에 특화된 고성능 추론 커널을 자동 프로그래밍하고 최적화했다고 설명했다. 신규 티어는 오픈AI 응답 API(Responses API)와 웹소켓 환경에서 서비스 티어 파라미터를 지정해 호출할 수 있으며, 아마존 베드록(Amazon Bedrock) 등 주요 클라우드 플랫폼에서도 순차적으로 지원이 시작되었다.
초당 300토큰의 속도 향상과 전체 파이프라인의 한계
엔비디아와 오픈AI는 울트라패스트 티어가 표준 모드 대비 토큰 생성 속도를 최대 8배 향상시킨다고 강조했다. 개발 환경인 코덱스(Codex) 내부 측정 시 초당 약 300토큰(tps) 수준의 생성이 가능하며, 범용 API 호출 기준으로는 최대 6배의 속도 개선이 안내된다. 이러한 속도 개선은 모델이 긴 코드를 일방적으로 작성하거나 실시간 대화 반응성을 극대화해야 하는 대화형 애플리케이션에서 체감 효과를 낸다.
그러나 이 수치는 순수 '출력 토큰 생성(generation)' 단계에 한정된 개선이라는 점을 명확히 인식해야 한다. 프롬프트를 해석하는 초기 응답 시간(TTFT)이나 네트워크 전송 지연은 동일하게 유지된다. 특히 에이전트 워크플로에서 상당 비중을 차지하는 외부 툴 호출, 코드 컴파일, 테스트 실행 대기 시간은 하드웨어 가속의 영향을 받지 않는다. 따라서 전체 작업 완료 시간(End-to-End) 기준 단축률은 기업 홍보 수치인 8배에 크게 미치지 못할 수 있다.
표준 대비 6배 인상된 가격 체계와 까다로운 접근 조건
강화된 성능만큼 비용 부담도 크게 늘었다. 오픈AI 공식 가격 정책에 따르면 울트라패스트 API의 이용료는 100만 토큰당 입력 60달러, 출력 300달러로 표준 모드(입력 10달러, 출력 50달러) 대비 정확히 6배 높게 책정되었다. 긴 문맥 출력 시에는 100만 토큰당 최대 450달러까지 비용이 치솟는다.
일반 웹 인터페이스에서도 이용 조건이 엄격히 제한된다. 챗GPT 플러스 등 일반 유료 사용자나 무료 사용자에게는 제공되지 않으며, 월 500달러를 지불하는 '프로 500' 플랜 가입자와 엔터프라이즈 및 에듀(Edu) 워크스페이스에만 열린다. 엔터프라이즈 환경에서도 관리자가 콘솔에서 직접 활성화해야 사용할 수 있다. 크레딧 소진율 역시 표준 대비 6배이며, 기본 제공되는 구독 할당량에서 차감할 때는 8배의 가중치가 적용된다.
코딩 에이전트 도입 시 실무적 비용 대 편익 계산
개발 실무 관점에서 울트라패스트 티어 도입은 철저한 비용 대비 편익 분석이 선행되어야 한다. 코드 작성, 린트 검사, 단위 테스트, 결과 검증이 촘촘하게 맞물린 자율 코딩 루프에서는 토큰 출력 병목이 해소될 때 개발자의 작업 컨텍스트 전환을 줄여주는 실질적 이점이 발생한다. 고숙련 소프트웨어 엔지니어의 시간당 인건비가 API 호출 증분 비용을 초과하는 대규모 프로젝트라면 6배의 가격 인상을 감수할 가치가 있다.
반면, 복잡한 데이터베이스 쿼리를 대기하거나 웹 검색 등 외부 I/O 의존도가 높은 자동화 업무에서는 출력 속도 가속의 실익이 급격히 낮아진다. 전체 실행 시간 중 토큰 생성이 차지하는 비중이 적다면 기하급수적으로 늘어난 청구서만 마주하게 된다. 실무 파이프라인 구축 시에는 모든 단계에 일괄 적용하기보다, 신속한 피드백이 결정적인 특정 추론 루프에만 조건부로 울트라패스트 파라미터를 활성화하는 아키텍처 설계가 바람직하다.
데이터 거버넌스 제약과 미공개 벤치마크 검증 과제
엔터프라이즈 기업이 도입을 검토할 때 주의해야 할 또 다른 장벽은 데이터 규제와 지역 제한이다. 현재 울트라패스트 티어는 미국 내 데이터 처리(US Data Residency) 및 글로벌 라우팅만 지원한다. 유럽연합(EU)의 일반데이터보호규정(GDPR)이나 역내 데이터 보관 의무를 준수해야 하는 다국적 기업의 경우 현시점에서 시스템에 통합하기 어렵다.
기술적 실증 자료의 한계도 분명하다. 엔비디아와 오픈AI는 초당 300토큰 도출 당시의 배치 크기, 동시 접속자 수(Concurrency), 입출력 토큰 길이 등 구체적인 부하 환경을 공개하지 않았다. 다수의 동시 요청이 몰리는 대규모 상용 서비스 환경에서도 최대 8배의 처리 속도가 균일하게 유지되는지는 독립적인 실측 검증이 필요하다. 아울러 지원 예정으로 언급된 GPT-6.1 Sol 기반의 울트라패스트 출시 시점과 세부 요금도 향후 추가 공지를 확인해야 할 미확정 영역이다.
출처
NVIDIA Blog의 원출처와 본문에 표시한 참고자료를 바탕으로 한국어로 재구성했습니다. ‘ARCH.B 분석’은 자료를 읽고 덧붙인 편집 해석입니다.
How NVIDIA GPUs Help Accelerate OpenAI’s GPT-6 Astra Ultrafast (새 창)