독립형 웹 포털로 일반 공개된 신스ID 디텍터
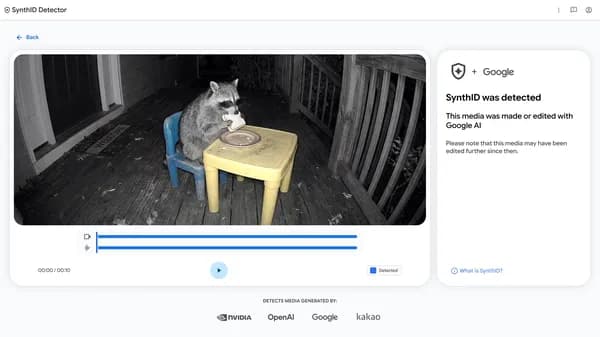
구글 딥마인드가 비가시적(Imperceptible) 워터마크 기술인 'SynthID'를 기반으로 온라인 미디어의 AI 생성 여부를 판별할 수 있는 독립형 전용 웹 포털 '신스ID 디텍터(synthid.com)'를 전 세계에 정식 배포했다. 2025년 5월 언론인과 팩트체커, 연구자 등 전문가 집단에 한정해 제공하던 초기 버전을 대중 누구나 접근할 수 있도록 일반 공개로 전환한 것이다.
이번에 공개된 서비스는 이미지(JPG, PNG, HEIC, GIF), 비디오(MP4, MOV, WEBM), 오디오(MP3, WAV, FLAC) 포맷 검증을 지원한다. 구글 계정을 포함해 오픈AI나 애플 계정으로 로그인하면 누구나 무료로 이용할 수 있다. 다만 과거 텍스트 워터마킹 연구와 달리 이번 웹 포털에서는 텍스트 검출이 제외되었으며, 서비스 초기 웹 인터페이스는 영어로만 제공된다.
경쟁사 끌어안은 크로스 플랫폼 검증 생태계
구글 측 발표에 따르면 신스ID 디텍터는 제미나이(Gemini), 이마젠(Imagen), 비오(Veo), 리리아(Lyria) 등 구글 자체 모델뿐만 아니라 외부 파트너사의 생성 모델까지 판별 범위에 포함했다. 현재 오픈AI(OpenAI), 엔비디아(NVIDIA), 카카오(Kakao)의 생성 모델이 SynthID 생태계에 합류해 탐지 대상에 적용되어 있다.
애플(Apple)의 생성 모델 역시 조만간(soon) 지원 목록에 추가될 예정이다. 구글은 2023년 기술 공개 이후 1,800억 개 이상의 이미지 및 비디오, 24만 년 분량의 오디오에 SynthID 워터마크가 삽입되었다고 밝혔다. 아울러 크롬 브라우저와 제미나이 앱, 검색 등에 연계된 자체 검증 처리량도 하루 100만 건 이상을 기록하고 있다고 설명했다.
글로벌 규제 대응과 파편화된 표준의 통합 전략
구글이 전용 검증 포털을 개방하고 경쟁사들과 연합 전선을 구축한 배경에는 글로벌 인공지능 규제 강화가 자리 잡고 있다. 유럽연합(EU) AI 법(AI Act)과 미국의 행정명령 등 주요국에서 딥페이크 및 허위 조작 정보 방지를 위한 출처 표기 의무화를 구체화하면서, 빅테크 기업들은 기술적 이행 방안을 증명해야 하는 과제를 안게 되었다.
기존 C2PA 메타데이터 방식은 편집이나 플랫폼 업로드 과정에서 메타데이터가 손쉽게 유실된다는 약점이 있었다. 반면 SynthID는 미디어 데이터 픽셀이나 주파수 자체에 비가시적 패턴을 새긴다. 구글은 이 기술을 자사 독점에 머무르게 하지 않고 오픈AI, 엔비디아 등 유력 경쟁사에 개방함으로써 사실상의 업계 검증 표준으로 자리매김하려는 전략을 구사하고 있다.
범용 감지기 아냐… 확인된 한계와 쿼리 제약
기업 홍보 문구와 달리 신스ID 디텍터는 모든 AI 생성물을 가려내는 '범용 AI 감지기'가 아니라는 점에 유의해야 한다. 미드저니(Midjourney), 메타(Meta), 스테이블 디퓨전(Stable Diffusion) 등 해당 기술을 도입하지 않은 모델에서 생성된 미디어는 이 플랫폼에서 전혀 감지되지 않는다. 이로 인해 판별 결과가 '인간 제작'을 보증하는 의미로 오인될 위험이 있다.
또한 일상적 압축이나 크롭에는 견디더라도, 의도적인 워터마크 제거(Stripping) 공격이나 구조적 재인코딩이 가해질 경우 신호가 훼손될 수 있다. 더불어 검사 결과 역시 세부 수정 영역을 밝히기보다 단순 생성·편집 여부만 알려준다. 구글은 적대적 탐지 회피 분석을 차단하기 위해 계정당 하루 약 10회의 쿼리 제한을 적용해, 대량의 기업용 자동화 검수 도구로는 즉시 활용하기 어렵다.
실무자가 유의해야 할 미확정 요소와 활용 가이드
미디어 검증과 사실 확인 실무를 담당하는 조직은 신스ID 디텍터의 한계를 명확히 인지하고 다층적 검증 파이프라인의 일부로만 활용해야 한다. 단일 도구의 '비감지' 판정만으로 미디어의 진위 여부를 단정해서는 안 되며, 전통적인 출처 역추적 및 메타데이터 분석과 병행하는 교차 검증 절차가 필수적이다.
아울러 실무 도입 전 미확정 요소도 짚고 넘어가야 한다. 애플의 Image Playground 등 세부 지원 기능과 실제 연동 시점은 발표문에서 구체적 일자 없이 '조만간'으로만 언급되었다. 텍스트 검출 기능의 포털 탑재 여부와 한국어 UI 지원 일정 역시 공지되지 않았으므로, 글로벌 표준 안착 여부를 면밀히 모니터링할 필요가 있다.
출처
Google Blog의 원출처와 본문에 표시한 참고자료를 바탕으로 한국어로 재구성했습니다. ‘ARCH.B 분석’은 자료를 읽고 덧붙인 편집 해석입니다.
We're making it easier to identify AI-generated content globally. (새 창)