추천 모델 통신 병목을 해결하기 위한 온패키지 네트워크 설계
메타는 2026년 8월 자사 엔지니어링 블로그를 통해 심층 추천 및 랭킹 모델(DLRM) 학습에 특화된 자체 AI 가속기 'MTIA 300'의 통신 하드웨어 및 소프트웨어 아키텍처를 상세히 공개했다. 메타의 설명에 따르면, 대규모 언어 모델(LLM)과 달리 추천 모델은 전체 파라미터의 99% 이상이 거대한 임베딩 테이블에 집중되어 있어 수백 개 가속기 간 빈번한 AllReduce, AllToAll, AllGather 집합 통신이 핵심 병목으로 작용한다.
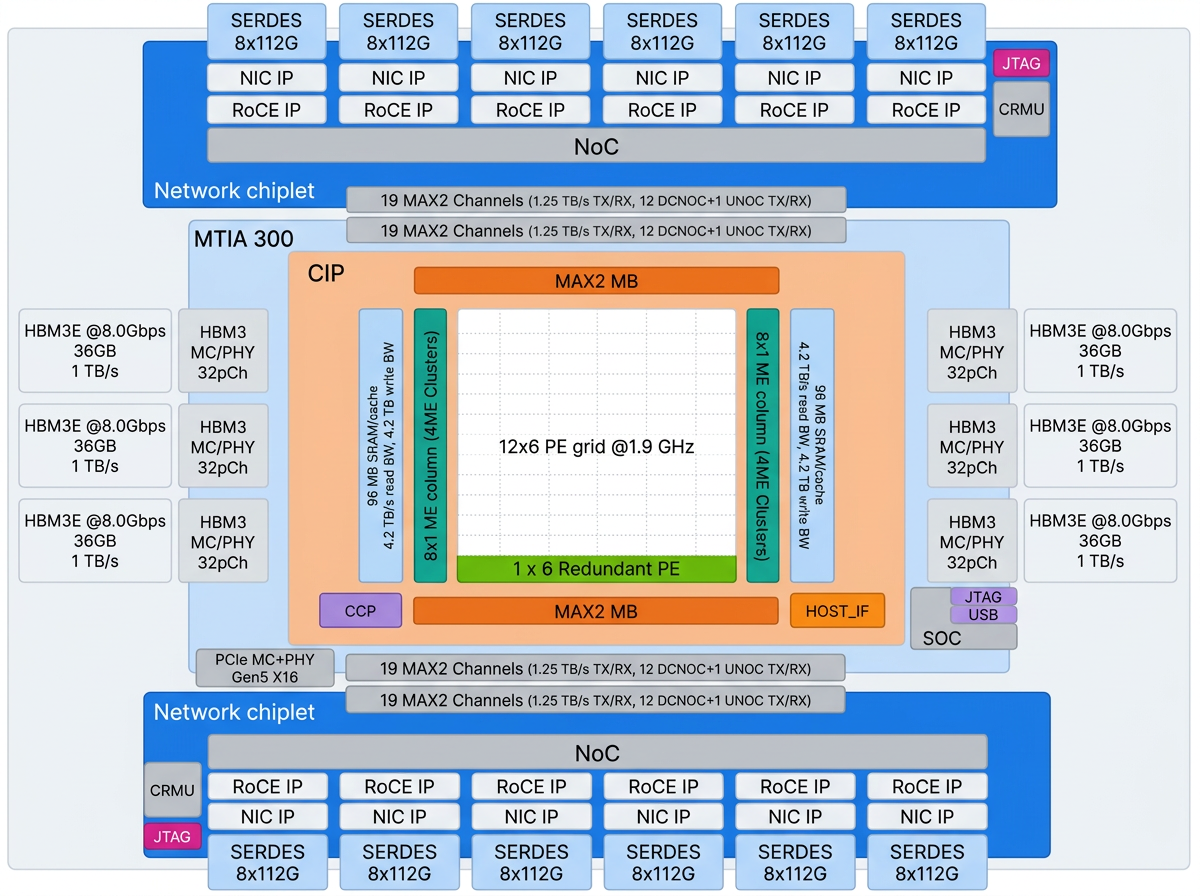
MTIA 300은 TSMC CoWoS 기반 2.5D 멀티 칩렛 구조를 적용해 네트워크 인터페이스를 칩 패키지 내부에 통합했다. 칩렛당 6개씩 총 12개의 커스텀 800Gbps RDMA NIC(이더넷/RoCE 기반)가 탑재된 2개의 네트워크 칩렛을 패키징하여, PCIe 버스를 거치지 않고 직접 연결되는 총 1.2TB/s의 네트워크 I/O 대역폭을 확보했다. 이 12개 NIC는 소프트웨어 제어를 통해 16노드 랙 내부 통신(최대 1TB/s)과 랙 간 스케일아웃 통신(200GB/s)으로 대역폭을 유연하게 분할할 수 있다.
독립 메시지 엔진과 컴파일 기반 통신(HCCL)의 연계 구조
MTIA 300은 연산 자원과 통신 자원을 물리적으로 격리하는 구조를 채택했다. 연산을 담당하는 12×6 그리드(총 72개)의 처리 요소(PE)와 별개로, 16개의 독립 메시지 엔진(ME)이 칩 내부에 배치되었다. 각 ME는 제어용 RISC-V 코어, 전용 NIC 인터페이스, 사이클당 128바이트를 처리하는 근접 메모리 연산(NMC) 블록으로 구성된다. HBM3E와 캐시 인근에 배치된 NMC 블록들은 총 2.8TB/s 이상의 리덕션 처리량을 생성해 메인 연산 그리드를 거치지 않고 라인 레이트 수준으로 AllReduce와 ReduceScatter를 완료한다.
소프트웨어 계층에서는 전용 통신 라이브러리인 HCCL이 하드웨어와 공동 설계되었다. HCCL은 호스트 CPU가 런타임에 개입하는 기존 방식 대신 통신 집합 연산을 서브그래프 형태의 작업 큐 엔트리로 컴파일해 216GB HBM3E에 저장하고, ME가 이를 자율적으로 순차 실행하도록 지원한다. 또한 작업 요청 쓰기 행위 자체가 도어벨 역할을 수행하는 '익스프레스 도어벨' 메커니즘을 적용해 작업당 약 800ns의 지연 시간을 줄였다.
통신 오프로딩이 입증한 성능 분리와 워크로드 적합성
엔비디아 GPU 환경에서는 NCCL과 같은 집합 통신 라이브러리가 통신 실행 시 스트리밍 멀티프로세서(SM) 자원을 점유하므로, 대규모 행렬 곱셈(GEMM) 연산과 통신이 겹칠 경우 통상 20% 이상의 연산 처리량 저하가 발생한다. 반면 MTIA 300은 독립된 ME와 NMC 블록이 통신 및 집합 리덕션을 전담하면서 동시 실행 시 연산 성능 저하 폭을 0.5% 미만으로 억제했다.
메타는 40개 가속기 클러스터에서 1,500억 개 파라미터를 가진 실제 서비스용 추천 모델을 구동했을 때 동급 GPU 클러스터 대비 통신 시간이 3.9배 단축되었으며 랙 내부 통신 대역폭이 940GB/s에 달했다고 발표했다. 호스트 CPU와 가속기를 1:1 비율로 배치하고 216GB의 고용량 HBM3E를 확보함으로써 임베딩 분산 연산 시 발생하는 빈번한 네트워크 오버헤드를 패키지 차원에서 효과적으로 흡수한 결과로 분석된다.
범용 연산 한계와 작은 메시지 처리의 제약 조건
메타의 자체 평가 결과가 모든 AI 인프라 환경에서 범용 GPU 대비 절대적인 우위를 의미하는 것은 아니다. ISCA 2026 학술대회에서 발표된 논문 데이터에 따르면, MTIA 300은 대형 메시지 및 추천 모델 파라미터 분산에 특화된 반면 작은 메시지 크기 환경에서는 엔비디아 H100과 NCCL 조합이 여전히 MTIA 300 및 HCCL보다 뛰어난 지연 시간 성능을 보였다. 메타 연구진 역시 초기 소프트웨어 스택이 대형 메시지 연산에 우선 최적화되었음을 명시하고 있다.
또한 MTIA 300은 피크 부동소수점 연산 성능(FLOPS)을 상대적으로 낮추고 통신 대역폭에 집중한 설계 특성을 지닌다. 이에 따라 산술 집약도가 400 이상인 순수 연산 중심 환경(H100 연산 효율 63% 대비 MTIA 300 59%)이나 대규모 LLM 사전 학습처럼 집약적인 GEMM 연산이 지배적인 영역에서는 H100 대비 처리 효율이 낮다. 따라서 MTIA 300의 효용은 추천 모델 및 대규모 메모리 I/O 중심 추론 환경으로 제한해 평가해야 한다.
내부 인프라 전용 운용 현황과 인프라 실무 검토 과제
MTIA 300은 메타 데이터센터 내부 프로덕션 워크로드 전용으로 설계 및 배치된 ASIC이며, 외부 클라우드 서비스 제공이나 상용 칩 단독 판매는 계획되어 있지 않다. 실리콘 설계와 네트워크 패키징 전반은 브로드컴(Broadcom)과의 기술 파트너십을 통해 진행되었으나, 상세 제조 공정 노드나 칩 다이 면적, 유닛당 생산 원가 등 하드웨어 비용 지표는 공개되지 않았다.
외부 엔지니어링 팀의 관점에서 MTIA 300 사례는 추천 시스템처럼 통신 병목이 극심한 대규모 도메인 워크로드에서 소프트웨어 최적화만으로는 네트워크 지연을 극복하기 어렵다는 점을 시사한다. 범용 클러스터를 운용하는 조직이라면 하드웨어 교체 대신 PyTorch `torch.compile` 통합 및 사전 그래프 컴파일 기법, 비동기 통신 오프로드 패턴을 기존 통신 파이프라인에 선별 적용해 통신-연산 경합을 완화하는 방안을 우선 모색할 필요가 있다.
출처
Meta Engineering의 원출처와 본문에 표시한 참고자료를 바탕으로 한국어로 재구성했습니다. ‘ARCH.B 분석’은 자료를 읽고 덧붙인 편집 해석입니다.
MTIA 300: Meta’s First Training Chip with Built-in NICs and Communication-Offloading Engines (새 창)