월간 실험 290건 돌파와 조직 병목 현상의 대두
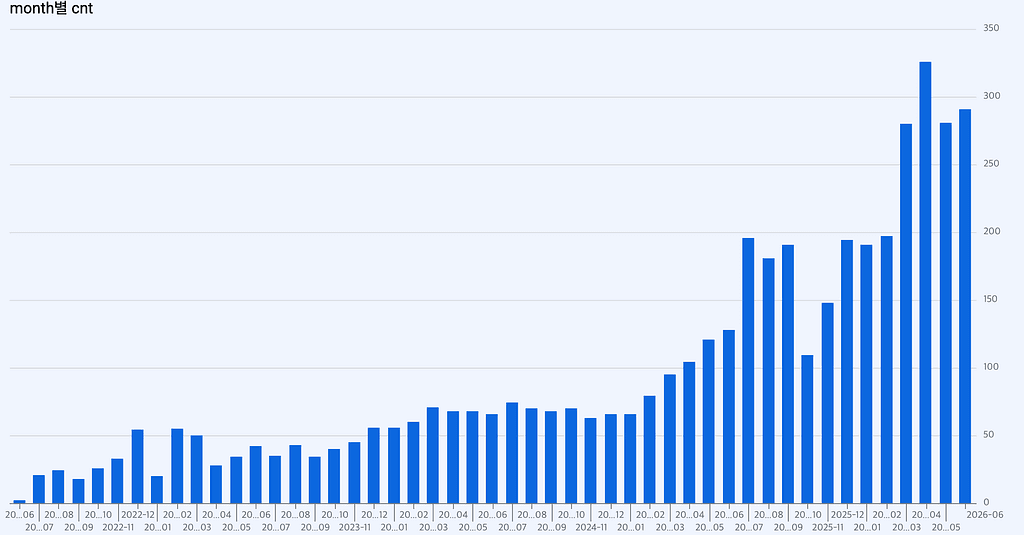
당근 테크 조직 내 데이터 가치화팀은 기술 블로그를 통해 사내 A/B 테스트 운영 플랫폼인 '실험플랫폼'의 아키텍처 개편 내용을 공개했습니다. 발표에 따르면 당근의 월간 진행 실험 수는 플랫폼 구축 초기(2023년 7월) 20개 수준에서 2026년 8월 기준 약 290개로 14배 이상 증가했습니다. 누적 실험 수는 350여 개에서 4,600여 개로 늘어났으며, 실험 오너 역시 80여 명에서 280여 명으로 확대됐습니다. 실험이 적용되는 활성 도메인도 중고거래, 검색, 피드, 커뮤니티, 동네생활, 광고, 알바, 중고차 등 60여 개 영역으로 넓어졌습니다.
조직과 실험 규모가 커지면서 당근은 두 가지 운영 문제에 직면했다고 밝혔습니다. 첫째는 실험 사이클의 지연이었습니다. 주당 수십 건의 실험이 진행되는 과정에서 지표 정의와 플랫폼 등록에만 1~2시간이 걸렸고, 데이터 가치화팀과의 반복적인 검토 핑퐁으로 인해 서비스팀의 가설 검증 주기가 끊기는 현상이 발생했습니다. 둘째는 동일 지면 내 실험 간 상호작용 간섭이었습니다. 같은 화면에서 복수의 UI 실험이 동시에 노출되면서 변수 간 간섭이 생겨 단일 실험의 인과 추론 토대가 훼손되고 사용자 경험이 저해되는 문제가 나타났습니다.
지표 등록 프로세스의 코드 프리 UI 전환
당근 데이터 가치화팀은 첫 번째 병목이었던 지표 정의 단계를 코드 관리 방식에서 실험플랫폼 UI 기반 셀프서브 체계로 전환했습니다. 기존에는 지표 하나를 등록하기 위해 깃허브(GitHub) 데이터 파이프라인 저장소에 지표 정의(metrics.yaml), 유저 행동 정의(subject_events.yaml), 실제 SQL 쿼리(events/*.sql) 3종의 파일을 작성해야 했습니다. 이후 PR 등록, CI 검사 통과, 테스트 Airflow 확인, 데이터 가치화팀의 코드 리뷰 및 머지 절차를 거쳐 실험플랫폼에 반영되기까지 1~2시간 이상이 소요됐습니다.
개편된 시스템에서는 이벤트 선택, 대상 행동(subject event) 정의, 집계 방식(count/ratio/sum) 설정을 플랫폼 UI 내 한 화면에서 수행할 수 있도록 구성했습니다. 작성된 지표는 버튼 클릭 한 번으로 테스트 쿼리를 실행해 결과를 검증할 수 있으며, 검증 통과 즉시 실험에 반영됩니다. 당근 측은 이를 통해 비엔지니어 직군인 기획자(PM)와 데이터 분석가(DA)의 도구 진입장벽을 낮추고, 데이터 가치화팀의 사전 리뷰 단계를 제거해 소요 시간을 수 분 단위로 단축했다고 설명했습니다.
슬롯 분할과 직교 레이어를 활용한 상호배제 그룹 구현
동일 지면 내 다중 실험 충돌 문제를 해소하기 위해 당근은 '상호배제 그룹'을 구현했습니다. 이는 사용자 트래픽을 1부터 10,000까지의 고유 슬롯으로 나누고, 사용자 식별자(User ID)의 해시 값을 기반으로 특정 슬롯에 고정 배분하는 방식입니다. 상호 간섭이 우려되는 실험들에는 서로 다른 슬롯 구간을 할당하여 단일 사용자가 한 시점에 오직 하나의 실험에만 노출되도록 강제합니다.
또한 다수의 실험을 효율적으로 운영하기 위해 슬롯 상단에 '레이어' 개념을 도입했습니다. 특정 도메인의 경우 holdout 집단에 10%, 전용 실험(A 레이어)에 10%의 전용 슬롯을 배정하고, 남은 80%의 슬롯 위에서 서로 다른 목적의 실험군(B 레이어와 C 레이어)을 상호 직교(orthogonal)하게 겹쳐 실행하도록 구조화했습니다. 옵티마이즐리(Optimizely)나 스탯시그(Statsig) 등 글로벌 실험 도구와 동일한 트래픽 분할 원리를 차용함으로써 서비스 서버의 개별 하드코딩 없이도 충돌을 방지하고 트래픽 활용도를 유지할 수 있도록 설계했습니다.
트래픽 분할에 따른 통계적 검정력 저하와 운영 한계
상호배제 그룹 기능은 간섭 없는 깔끔한 인과 추론 환경을 제공하지만, 통계적 관점에서는 명확한 기회비용을 유발합니다. 트래픽 슬롯을 N개의 실험이 분할해 사용할 경우, 개별 실험에 배정되는 표본 크기는 전체 트래픽의 N분의 1로 급감하게 됩니다. 표본 수가 줄어들면 실험의 통계적 검정력(Statistical Power)이 저하되어, 실제 서비스 변경으로 인한 성과 차이가 존재하더라도 이를 유의미한 수치로 검출하지 못할 위험이 커집니다.
이러한 이유로 당근 역시 전사 모든 실험에 상호배제를 일괄 적용하는 방식을 지양하고, 동일 화면 노출 등 간섭이 명확한 실험군에만 한정해 배타 그룹을 적용하는 선별적 운영 정책을 택했습니다. 당근 측은 줄어든 표본에 따른 분산을 통제하기 위해 사전 실험 데이터를 활용하는 CUPED 기법 도입을 예고했으나, 실제 프로덕션 환경에서 검정력이 얼마나 보정되었는지에 대한 구체적인 측정 수치는 후속 발표 과제로 남아 있습니다.
셀프서브 거버넌스 관리와 자동화 확장 과제
지표 등록 단계에서 데이터 엔지니어의 수동 코드 리뷰를 생략한 것은 개발 병목을 획기적으로 낮췄지만, 장기적으로는 지표 정의의 일관성과 거버넌스 유지라는 새로운 관리 과제를 동반합니다. 도메인 조직이 자체적으로 지표를 양산할 경우 유사하거나 중복된 지표가 생성되어 지표 사일로 현상이 나타날 수 있으므로, 플랫폼 내부의 지표 명명 규칙 및 데이터 품질을 점검하는 백그라운드 관리 체계가 뒷받침되어야 합니다.
한편 당근은 실험 사이클의 남은 반복 작업을 줄이기 위해 'Experiment MCP'를 구축하고 LLM을 활용한 자동화 연계를 시도하고 있습니다. 다만 현재까지 공개된 자료 기준으로는 자연어를 통한 실험 지표 및 상태 조회가 우선 지원되는 단계로 파악되며, 실험 설계 문서 작성과 지표 자동 등록까지 LLM 에이전트가 프로덕션 수준에서 완전 자율적으로 수행하는지에 대해서는 명확한 도입 범위와 정량 데이터 확인이 요구됩니다.
출처
당근 기술 블로그의 원출처와 본문에 표시한 참고자료를 바탕으로 한국어로 재구성했습니다. ‘ARCH.B 분석’은 자료를 읽고 덧붙인 편집 해석입니다.
실험을 더 편하게 설계할 수 있게: 당근 실험플랫폼 이야기 (새 창)