


본 모델에 붙이는 실험용 초안 모델
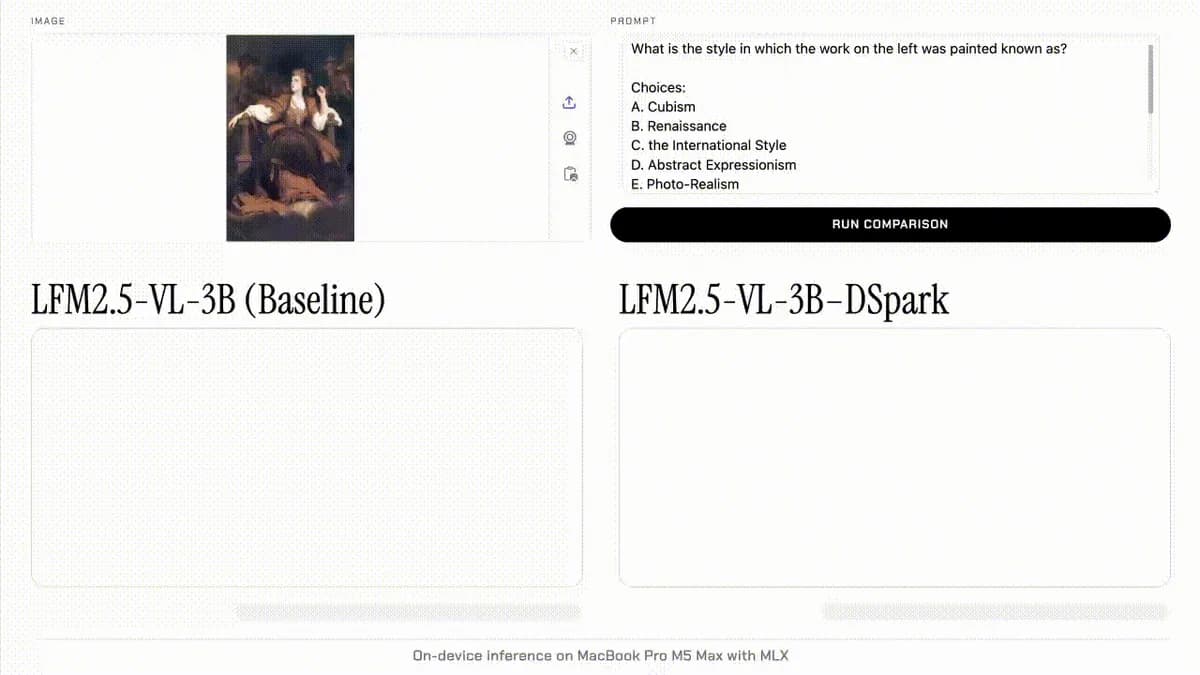
Liquid AI는 9월 24일 시각언어 모델 LFM2.5-VL-3B를 위한 실험용 DSpark 모델을 공개했다. 약 2억 8,000만 매개변수의 가벼운 초안 모델이 후보 토큰을 만들고 원래 모델이 검증하는 추측 디코딩 방식이다. 회사는 배포하는 매개변수 수가 약 8.9% 늘어난다고 설명했다. 이 비율은 매개변수 수에 관한 값이며 전체 실행 메모리나 전력 소비가 정확히 같은 비율로 늘어난다는 측정은 아니다. 모델 카드도 정해진 목표 모델과 짝지어 사용하도록 안내한다. 새 초안 모델을 단독 시각언어 모델이나 모든 기존 모델에 그대로 연결할 수 있는 일반 가속기로 해석할 근거는 없다.
토큰을 검증해 원래 출력 경로를 유지
초안 모델은 목표 모델의 일부 층에서 나온 내부 표현을 받아 여러 토큰을 제안한다. 시각 입력도 그 단계에서는 내부 벡터로 표현돼 같은 추측 방식에 사용할 수 있다는 설명이다. 공식 모델 카드는 탐욕적 디코딩에서 목표 모델이 모든 후보를 검증하므로 목표 모델만 실행한 출력과 같다고 안내한다. 같은 샘플링 조건에서는 출력 분포를 유지하는 방식이라는 회사의 설명도 있다. 이것은 가속할 때 원래 모델의 출력 특성을 보존하려는 알고리즘의 조건이다. 목표 모델의 사실 오류를 수정하거나 새로운 시각 이해 능력을 학습했다는 뜻은 아니다. 품질 유지라는 표현을 모든 질문에 정확한 답을 보장한다는 말로 넓히지 않았다.
최대 수치가 나온 장치와 실험 설정
공식 모델 카드의 비교 기준은 같은 목표 모델을 DSpark 없이 실행한 경우다. MLX-VLM을 쓴 M5 Max에서는 과제별 디코딩이 2.30~3.13배, 전체 과정은 1.56~2.62배 개선됐다고 회사는 보고했다. H100 80GB 한 장과 SGLang의 실험은 디코딩 2.04~2.66배, 전체 과정 1.64~2.27배였다. 이미지 인코더와 언어 부분 모두 16비트로 처리했고 배치 크기 1, 온도 0을 사용했다. 애플 실험은 FP16과 블록8, H100은 BF16과 블록9라는 조건도 다르다. 따라서 최대3.13배는 특정 장치와 과제의 토큰 생성 단계 수치이며 모든 장치의 전체 응답 시간이 같은 비율로 줄어든다는 결과가 아니다.
이미지 처리와 입력 계산이 남기는 한계
시각언어 모델은 답을 생성하기 전에 이미지를 인코더로 처리하고 시각 토큰과 텍스트 입력을 계산해야 한다. 회사의 상세 글은 DSpark가 디코딩만 가속하며 이미지 인코딩과 입력 처리 단계는 바꾸지 않는다고 명시한다. 이 단계의 비중이 큰 작업에서는 생성이 빨라져도 첫 토큰을 받기까지의 대기나 전체 처리 시간이 덜 줄어든다. 실험의 생성 단계와 전체 과정 수치가 다른 이유를 이해하는 데 중요한 조건이다. 짧은 답과 큰 이미지, 긴 입력을 사용하는 작업은 각각 전체 시간의 구성이 다를 수 있다. 디코딩 최대치를 실제 앱의 모든 작업 속도로 대입하는 대신 어떤 단계가 시간을 차지하는지 보는 해석이 필요하다.
지원 도구와 배포 조건을 함께 확인
발표는 llama.cpp·MLX-VLM·SGLang 지원과 Safetensors·GGUF 배포를 안내한다. 공식 카드에는 DSpark를 지원하는 버전과 목표 모델에 맞는 체크포인트를 사용할 조건이 적혀 있다. 현재 MLX-VLM의 DSpark 경로는 탐욕적 샘플링을 사용해 온도0으로 설정하도록 안내한다. 회사 글의 일반적인 샘플링 설명을 모든 구현에서 같은 옵션을 지원한다는 뜻으로 읽을 수는 없다. 또한 공개한 실험은 양자화 모델의 가속을 범위에 포함하지 않았다. 가중치를 내려받을 수 있다는 사실과 자신이 쓰는 런타임·정밀도·메모리 조건에서 같은 이득을 얻는 것은 별도로 확인할 사항이다.
추가 계산의 이득을 실제 과제에서 판단
후보 토큰을 여러 개 만들고 검증할 때 받아들여지는 수가 많으면 본 모델을 반복 실행하는 비용을 줄일 수 있다. 다만 초안을 만들고 검증하는 추가 작업도 있어 하드웨어와 실행 설정이 결과에 영향을 준다. 회사는 온도를 높이면 후보 수용이 줄어 처리량 이득도 낮아졌다고 설명했다. 동시 요청이 많아지는 실험에서는 이득이 유지됐지만 차이가 좁아지는 경향을 보고했다. 이는 최대 속도 향상만으로 서버 처리 용량이나 사용 비용을 일률적으로 계산할 수 없다는 의미다. 이번 공개는 지정된 작은 시각언어 모델의 추론 경로를 개선한 실험이며 실제 도입 평가는 사용하는 이미지·출력 길이와 동시 요청 조건에서 이뤄져야 한다.
출처
Hugging Face의 원출처와 본문에 표시한 참고자료를 바탕으로 한국어로 재구성했습니다. ‘ARCH.B 분석’은 자료를 읽고 덧붙인 편집 해석입니다.
Accelerating vision-language models with LFM2.5-VL-DSpark (새 창)

