글로벌 리더보드와 현업 성능의 괴리, 자체 기준 수립의 배경
비바리퍼블리카(토스) LLM Modeling 팀은 2026년 9월 16일 기술 블로그를 통해 자체 LLM 평가 프레임워크인 'Toss Benchmark' 구축기를 발표했습니다. 토스는 사내 여러 업무 영역에서 거대 언어 모델 도입을 검토·적용하고 있으나, 공개 글로벌 리더보드에서 고득점을 기록한 모델이 실제 토스의 서비스 파이프라인에서는 기대한 만큼의 성능을 내지 못하는 문제를 겪었습니다. 글로벌 리더보드는 주로 영어 기반의 범용 시험 위주로 구성되어 있어, 한국어 환경과 토스 특유의 업무 규칙을 처리하는 역량을 온전히 대변하지 못했기 때문입니다.
또한 기업 내부의 한정된 GPU 자원에서 최적의 서빙 모델을 선별하고, 사내에서 연구·개발 중인 'Toss Foundation 모델'의 학습 및 개선 목표를 정량화하기 위한 현실적인 기준이 필요했습니다. 토스 측은 공개된 범용 벤치마크의 점수만으로는 실제 현업에서 요구되는 저지연 운영 조건과 도메인 처리 역량을 가늠하기 어렵다고 판단하여, 한국어 범용 평가와 서비스 지시 준수, 도메인 지식을 종합적으로 검증하는 자체 체계를 설계하게 되었다고 배경을 밝혔습니다.
언어와 추론 설정 변경에 따른 후보 모델 간 성능 순위 역전
Toss Benchmark의 실험 결과에 따르면, 평가 언어를 영어에서 한국어로 바꾸거나 추론(Reasoning) 과정을 비활성화하는 것만으로도 모델 간 서열이 완전히 뒤바뀌었습니다. 수학 벤치마크 번역본 평가에서 영어 기준 81.74점으로 1위였던 gemma-4-26B-A4B-it은 한국어에서 72.43점으로 떨어지며 2위로 내려앉았고, 영어 79.74점이던 Qwen3.6-27B가 한국어 73.15점으로 1위에 올랐습니다. 코딩 영역에서도 영문 1위(69.40점)였던 Qwen3.5-122B-A10B가 한국어에서는 53.73점으로 하락하며 Qwen3.6-27B(55.60점)에 밀렸습니다.
운영 환경의 비용 절감과 응답 속도 확보를 위해 추론 생성을 비활성화(Non-reasoning)했을 때의 격차는 더욱 컸습니다. 코딩 태스크 기준 GLM-5.1은 추론 모드 해제 시 78.7점에서 48.1점으로 무려 30.6점 하락했고, Kimi-K2.6 역시 26.4점 떨어졌습니다. 반면 gemma-4-26B-A4B-it의 하락 폭은 6.0점(84.0점→78.0점)에 불과했습니다. 추론 모드에서 앞서던 모델이라도 빠른 응답이 필요한 비추론 운영 조건에서는 다른 모델보다 성능이 뒤처질 수 있음이 정량적으로 입증되었습니다.
실무 연동의 핵심 축: Toss IFBench와 도메인 지식 체계
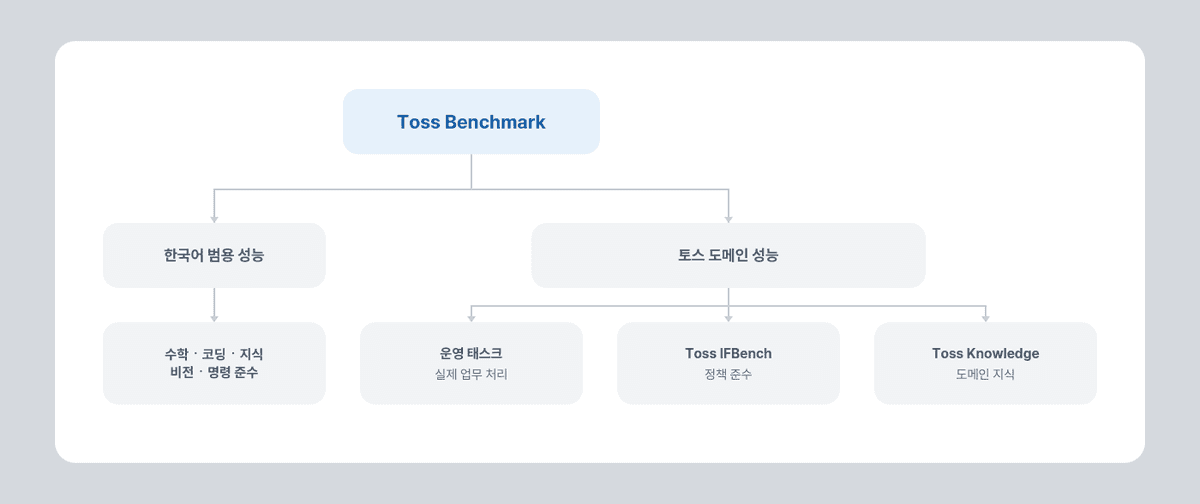
토스는 현업 성능과의 정합성을 확보하기 위해 평가 체계를 한국어 범용, Toss IFBench, Toss Knowledge 및 운영 태스크의 3단계로 분리했습니다. Toss IFBench는 서비스 프롬프트 내 세부 규칙을 지키는 역량을 측정하며, 정해진 JSON 포맷이나 단위를 맞추는 '형식 지시'와 조건 변경 시 판정을 바꾸는 '판단 지시'로 나누어 규칙 준수 능력을 채점합니다. Toss Knowledge는 커머스 영역을 우선 구축하여 브랜드·스펙·용어 이해 등 5개 축의 4지선다형 문항으로 평가하며 향후 광고·금융·페이 영역으로 확장을 계획하고 있습니다.
사내 11개 모델을 대상으로 진행한 상관관계 분석 결과는 벤치마크 설계의 필요성을 뚜렷하게 보여줍니다. 글로벌 종합 지표(AAII)와 토스 사내 운영 성능 간 스피어만 상관계수는 +0.02(피어슨 +0.17)로 사실상 무관했습니다. 반면 Toss IFBench 형식 지시는 스피어만 +0.71, 피어슨 +0.87로 매우 높은 양의 상관관계를 기록했습니다. Toss Knowledge 역시 상품 검수(스피어만 +0.81), 상품 그룹화(+0.72) 등에서 강한 상관성을 보여 사내 'GenAI Portal' 모델 추천 기준으로 채택되었습니다.
파라미터 지식 평가의 실효성 논란과 자체 모델 정보 부재
Toss Benchmark가 제시한 실증 분석은 현업 중심 평가의 중요성을 부각하지만, 방법론적 측면에서는 몇 가지 기술적 한계와 비판이 제기됩니다. 주요 쟁점 중 하나는 Toss Knowledge의 객관식 평가 방식입니다. 외부 엔지니어링 관점에서는 수시로 변하는 이커머스 상품 규격이나 업계 용어를 모델 내부 파라미터(Parametric Knowledge) 암기에 의존하는 것은 한계가 있으며, 검색 증강 생성(RAG)이나 에이전트 도구 호출(Tool Calling)로 대응해야 실질적인 환각을 방지할 수 있다는 지적이 나옵니다.
이에 대해 토스 측은 대규모 트래픽 환경에서 모든 요청에 RAG와 도구 호출을 수행하면 지연 시간과 토큰 비용이 급증하므로, 모델이 추가 외부 자원 없이 자체 해결할 수 있는 범위를 파악하기 위한 실용적 보조 지표라고 해명했습니다. 한편, 벤치마크 수립의 주요 목적 중 하나로 제시된 사내 'Toss Foundation 모델'은 파라미터 크기, 기본 아키텍처, 학습 데이터 규모 등 핵심 정보가 일절 공개되지 않았습니다. 또한 세부 실험마다 투입된 비교 모델 구성이 달라 통제된 단일 비교군 기반의 검증인지에 대한 지속적인 확인이 필요합니다.
엔터프라이즈 AI 도입을 위한 실무적 시사점과 구축 방향
토스의 이번 사례는 엔터프라이즈 환경에서 상용 또는 오픈소스 LLM을 도입할 때 공개 리더보드 점수에만 매몰되어서는 안 된다는 점을 명확히 시사합니다. 영어 원문과 무제한 추론 모드를 전제로 측정한 글로벌 지표는 현업의 한국어 처리 능력, 응답 지연 제약, 정형화된 JSON 출력 요구 사항을 반영하지 못합니다. 실제 운영 태스크와 AAII 지표의 상관관계가 전무했다는 사실은 기업마다 자사 고유의 검증 틀을 갖추는 것이 필수적임을 보여줍니다.
따라서 기업 실무진은 모델을 검토할 때 글로벌 순위에 의존하기보다, 자사 서비스의 프롬프트 제약과 운영 설정을 반영한 맞춤형 지시 준수(Instruction-Following) 검증 체계를 선제적으로 수립해야 합니다. 추론 On/Off 설정에 따른 성능 하락 폭을 실측하고 서비스 도메인 규칙을 준수하는지 사전에 테스트하는 것만이, 한정된 GPU 인프라 자원 안에서 서빙 비용을 통제하고 비즈니스 안정성을 담보하는 가장 현실적인 엔지니어링 접근법입니다.
출처
토스테크의 원출처와 본문에 표시한 참고자료를 바탕으로 한국어로 재구성했습니다. ‘ARCH.B 분석’은 자료를 읽고 덧붙인 편집 해석입니다.
리더보드 1등 LLM, 토스에서도 1등일까? - Toss Benchmark 구축기 (새 창)