Meta, 에이전트 특화 '뮤즈 원더' 제품군 공개…오픈소스 탈피와 선별 배포 전략 분석
Meta가 장기 작업 처리 역량을 강화한 프런티어 에이전트 모델 'Muse Wonder'와 'Muse Wonder Full'을 발표했다. 과거 Llama의 오픈 가중치 정책을 버리고 독점 API 및 자사 구독 소프트웨어 중심의 상용 모델 체제로 전환했으며, 최상위 모델은 API에서 배제해 자사 유료 도구 가입을 유도하는 사업적 락인 전략을 구체화했다.


Meta가 장기 작업 처리 역량을 강화한 프런티어 에이전트 모델 'Muse Wonder'와 'Muse Wonder Full'을 발표했다. 과거 Llama의 오픈 가중치 정책을 버리고 독점 API 및 자사 구독 소프트웨어 중심의 상용 모델 체제로 전환했으며, 최상위 모델은 API에서 배제해 자사 유료 도구 가입을 유도하는 사업적 락인 전략을 구체화했다.
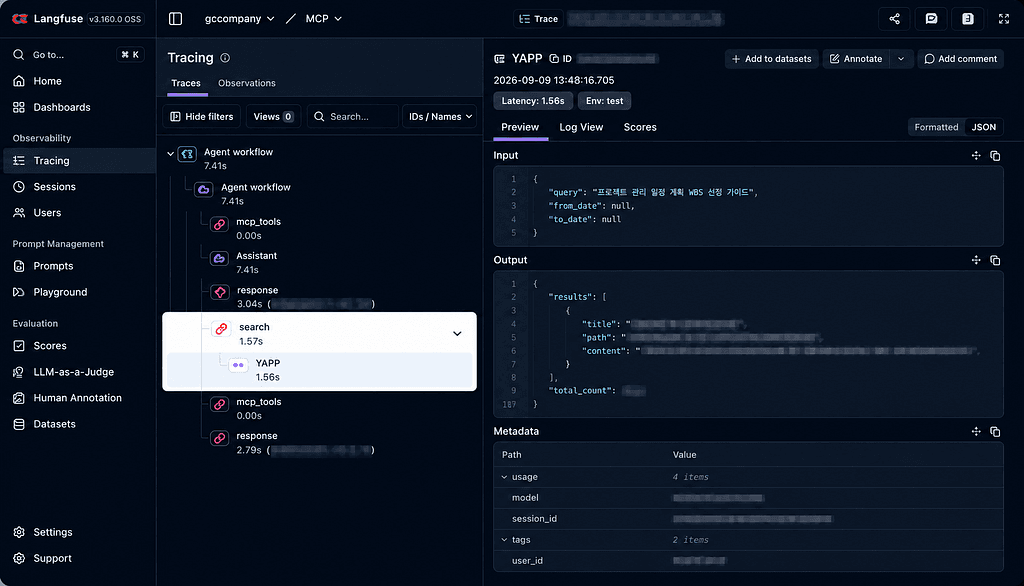
여기어때가 사내 문서 검색을 랭퓨즈로 관측하고 검색 지표와 LLM 채점을 나눠 평가한 사례를 공개했다. MCP 명세와 문서 식별 방식도 개선했다. 내부 평가 결과를 일반 성능으로 확대하지 않고, 변경을 판단할 근거를 만드는 과정에 주목할 만하다.
클라우드플레어가 오디오·영상을 직접 받는 결정 모델 클레프 옴니를 공개하고 클레프 플래시 가격을 낮췄다. 플래시 호스팅의 문맥 한도는 함께 축소됐다. 입력을 선택지별 확률로 바꾸는 도구의 성격과 미디어 토큰, 서빙 성능의 측정 조건을 구분할 필요가 있다.
클라우드플레어가 보안 분석가의 경보 피로를 완화하기 위해 결정론적 정찰 코드와 4대 전문 AI 에이전트를 결합한 '보안 운영 하네스' 아키텍처를 발표했습니다. 단일 LLM의 환각과 범위 이탈 문제를 해결하기 위해 선 정찰 후 추론 방식을 채택했으나, 최종 판단 권한은 여전히 인간 분석가에게 귀속됩니다.
메타가 플랫폼 내 유료 광고를 통해 외부 불법 아동 성착취물로 유도하는 수법을 막기 위해 대규모 언어 모델과 레드팀 AI 에이전트를 도입했습니다. 표면적으로 무해해 보이는 광고 문구와 외부 연결 목적지를 함께 분석하는 체계로의 전환이지만, 글로벌 규제 당국의 압박과 탐사보도가 계기가 되었다는 평가가 나옵니다.
피그마가 2026년 10월 6일 캔버스 기반 인공지능 도구인 피그마 에이전트(Figma Agent)를 정식 출시하고 디자인 시스템 유지보수 자동화 워크플로를 공개했습니다. 문서화, 하드코딩 값 감사, 컴포넌트 일괄 교체 등 반복 실행 작업의 효율을 높여주지만, LLM 특유의 비결정성과 복잡한 제품 맥락 판단의 부재는 실무자가 직접 검증해야 할 과제로 남았습니다.
아랍에미리트 TII가 현대 표준 아랍어를 넘어 현지 구어체와 문화적 맥락을 반영한 'Falcon-Emirati-7B'와 음성·문서 인식 모델군을 발표했습니다. 하이브리드 아키텍처와 합성 데이터를 활용해 방언 생성 능력을 끌어올렸으나, 방언 충실도 한계와 가중치 공개 조건 등 실무 적용 시 점검해야 할 과제도 상존합니다.
클라우드플레어가 유럽 다국어 공개 모델 EuroLLM과 Apertus의 Workers AI 접근 신청을 받고 정부·핵심 인프라를 위한 실습 교육을 발표했다. 국가 AI 주권의 기준으로 모델 선택과 교체 가능성을 제시한다. 언어 지원의 의미와 모델 독립적인 운영이 요구하는 준비를 살펴본다.
멀티버스 컴퓨팅 연구팀이 모델 컨텍스트 프로토콜(MCP) 기반 LLM 에이전트의 '출처 교차 혼동' 문제를 해결하기 위한 사후 사실성 검증 프레임워크 '프로비넌스가드(ProvenanceGuard)'를 공개했습니다. 이 기술은 에이전트 재학습 없이도 생성된 답변의 세부 주장을 개별 도구 출력과 대조해 잘못된 인용을 차단합니다.
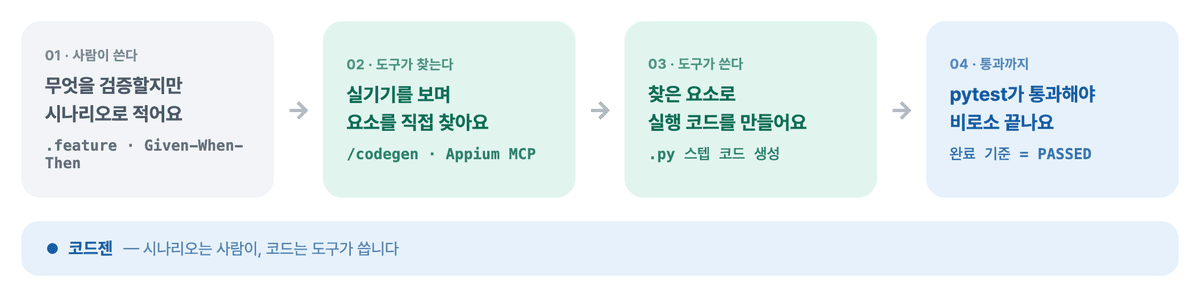
토스 QA Platform 팀이 주간 배포 파이프라인의 스모크 테스트 유지보수 비용을 낮추기 위해 '토스닥터 V2'를 공개했습니다. 한국어 BDD 시나리오를 바탕으로 LLM과 Appium MCP를 연동해 코드를 자동 생성하고, 테스트 실행 중 장애를 실시간으로 치유하며 실패 원인을 스스로 수정하는 구조를 구축했습니다. 다만 완전 자동화의 위험을 방지하기 위해 검증 단계의 유사 매칭을 제한하고 수동 개입 기준을 명확히 분리했습니다.
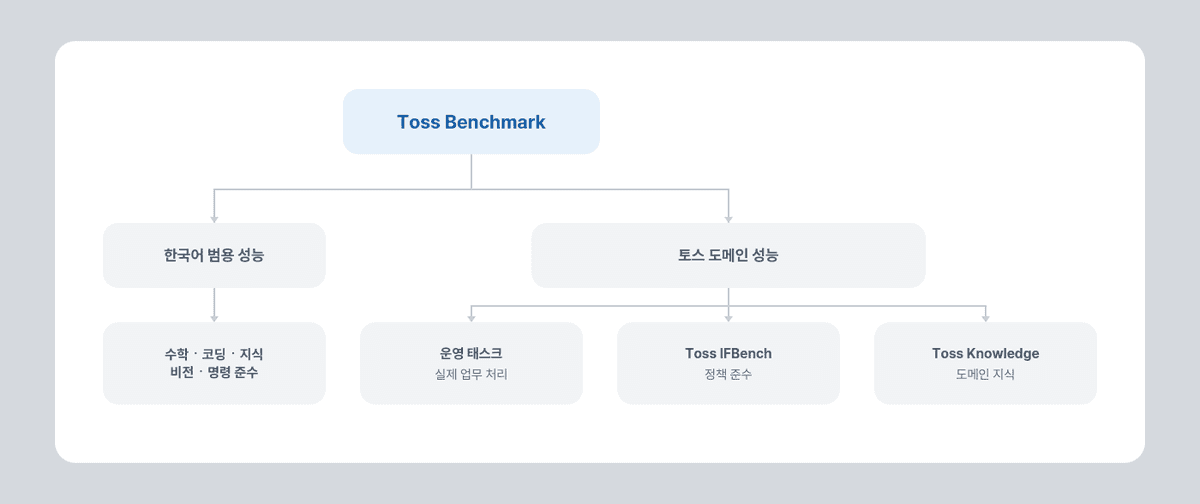
비바리퍼블리카(토스)가 공개 글로벌 리더보드 점수와 현업 환경 간의 괴리를 해소하기 위해 자체 LLM 평가 체계 'Toss Benchmark'를 구축했습니다. 평가 언어와 추론(Reasoning) 설정에 따른 극심한 순위 역전을 검증하고, 지시 준수 및 도메인 지식 지표를 바탕으로 사내 모델 서빙 기준을 정립했습니다.
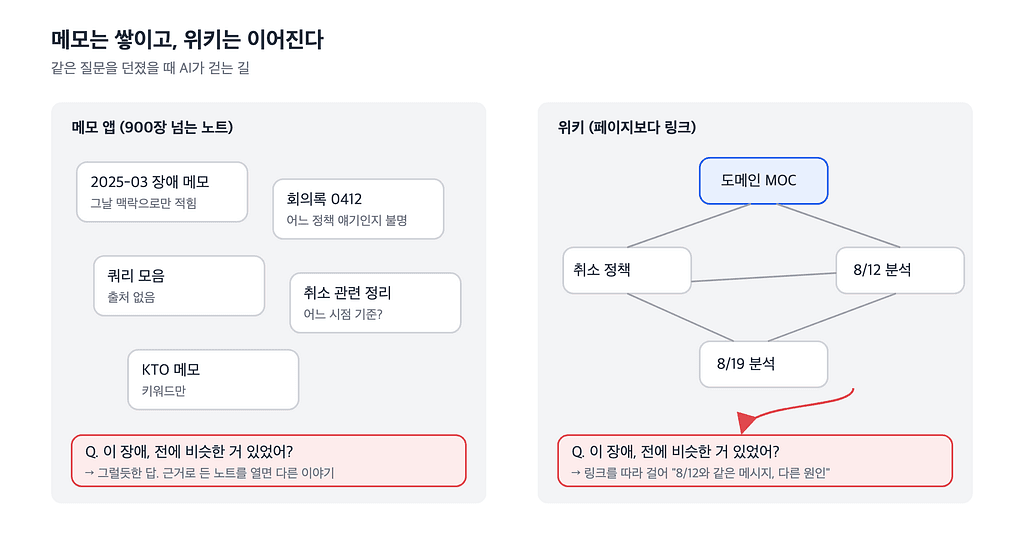
여기어때 유저혜택개발팀 엔지니어가 안드레이 카파시의 LLM 위키 패턴을 업무 환경에 맞춰 변형한 뒤 2달간 운영한 기록을 공개했다. 정적 연구 자료용 설계를 목차(MOC) 계층 추가, 원본의 이동·수정 전면 금지, 코드베이스 우선 검증 규칙으로 보완하여 반복되는 장애의 원인을 식별하는 성과를 냈으나, 정리 비용과 수동 수집 의존성이라는 명확한 한계도 확인됐다.
제록스 스타와 매킨토시 이래 수십 년간 지속된 포인트 앤 클릭 인터페이스가 생성형 인공지능과 거대언어모델(LLM)에 의해 '의도 기반 디자인'으로 전환되고 있습니다. 번거로운 10단계 조작 대신 사용자의 고차원적 목표를 포착해 백그라운드에서 실행하는 기술적 변화와 그에 따른 디자인 과제를 짚어봅니다.
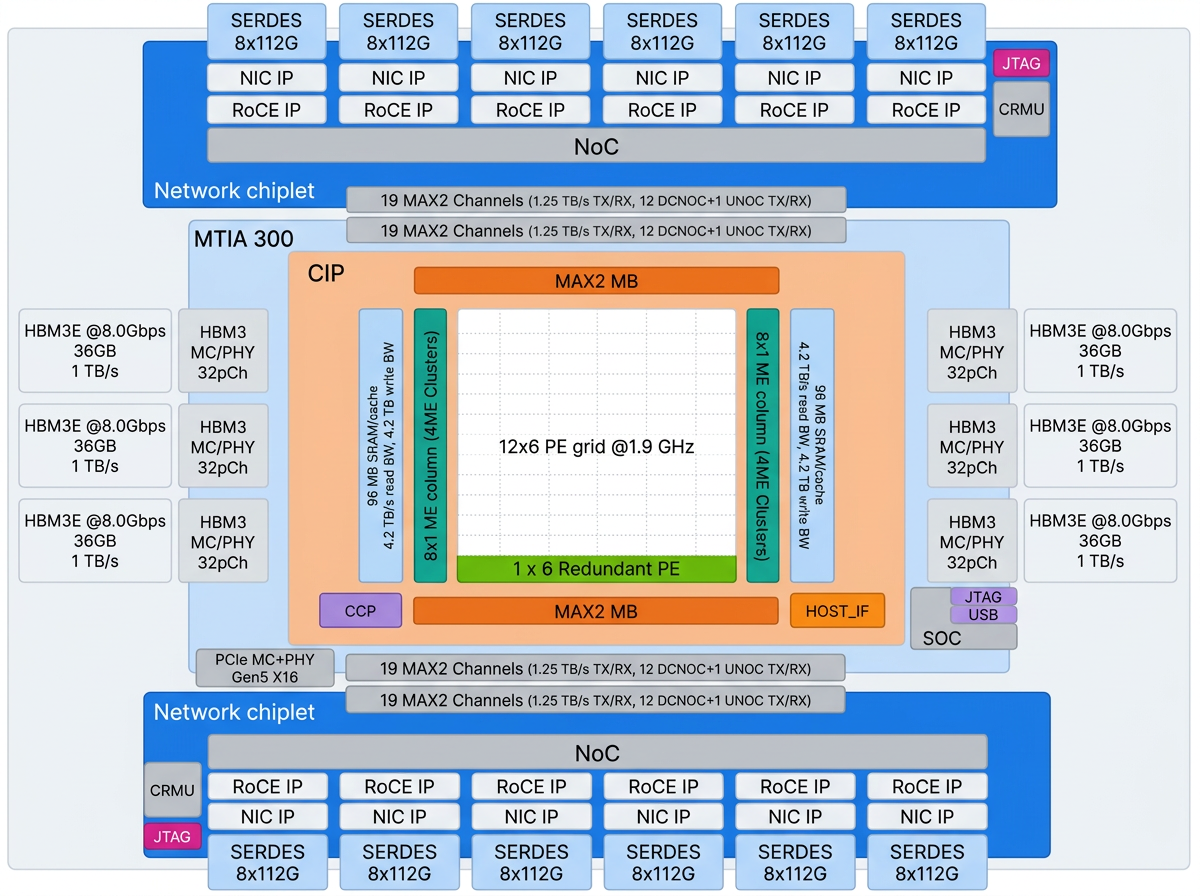
메타가 대규모 추천 모델 학습을 겨냥해 12개 커스텀 800Gbps RDMA NIC를 칩 패키지에 내장하고 연산과 통신을 물리적으로 분리한 3세대 AI 가속기 'MTIA 300'의 상세 설계를 공개했다. 통신 부하를 하드웨어로 오프로드해 자원 경합을 해소했으나 연산 집약적 LLM에서는 범용 GPU 대비 한계도 뚜렷하다.
토스증권이 LLM 운영에서 프리픽스 캐시, 출력 제한과 처리 여유를 확인한 사례를 공개했다. 요청 수와 평균 지연만으로는 보이지 않는 문제를 토큰 지표와 개별 로그로 추적하는 방법이다.
Linear가 이슈 관리 전반을 보조하는 Linear Agent의 내부 아키텍처를 공개했습니다. 정해진 경로를 강제하는 대신 시스템 프롬프트, 도구 스키마, 점진적 스킬 로딩으로 행동 경계를 긋고 독자 하네스를 구축해 예측 가능성과 유연성을 동시에 확보한 설계 전략을 분석합니다.
Airbnb는 GraphQL 인프라, 제품 컨텍스트, LLM을 결합하여 새로운 지시문(@generateMock)을 사용해 설득력 있고 타입 안전한 mock 데이터를 생성하고 유지합니다. 이 솔루션은 엔지니어가 수동으로 mock을 작성하고 유지 관리할 필요성을 없애 제품 개발에 집중할 수 있도록 합니다. @generateMock과 @respondWithMock 지시문은 엔지니어가 서버 구현이 완료되기 전에 클라이언트를 구축할 수 있도록 지원하며, 쿼리가 발전함에 따라 mock 데이터가 동기화 상태를 유지하도록 보장합니다.