요청 수만으로 설명하기 어려운 서빙
토스증권의 김민규 머신러닝 엔지니어는 기술블로그에서 LLM을 실행하는 일과 안정적으로 운영하는 일의 차이를 소개했다. 입력과 출력 길이가 크게 달라지는 서비스에서는 초당 요청 수와 전체 응답 시간만으로 부하를 해석하기 어려웠다는 경험이다. 팀은 초당 토큰 처리량과 첫 토큰까지 걸리는 시간인 TTFT 등을 함께 살피는 방향으로 관찰 범위를 넓혔다.
공통 머신러닝 플랫폼에서 그라파나 지표와 키바나의 개별 요청 로그를 연결하고, vLLM·SGLang의 서빙 지표를 대시보드에 반영했다. 발표의 중심은 새 모델 출시나 범용 성능 비교가 아니라 운영 중 발생한 설정·응답 문제를 좁히는 과정이다. 같은 지연이라도 입력 처리, 출력 생성과 잘못된 종료 조건을 나눠 봐야 원인을 찾을 수 있었다.
첫 토큰 지연에서 빠진 캐시를 찾았다
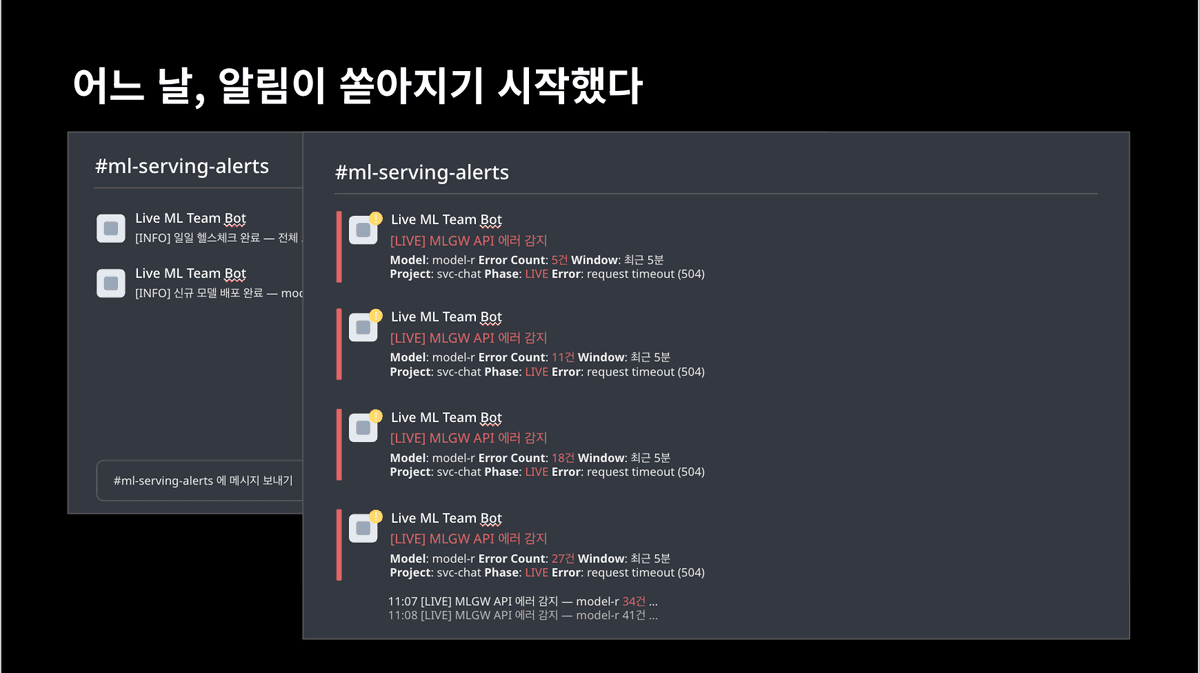
첫 사례는 요청량 증가와 맞물리지 않는 시간 초과였다. 팀은 공통 입력이 있는 요청인데도 프리픽스 캐시 적중 지표가 없거나 낮다는 점을 확인했고, 해당 모델 설정에서 캐싱이 꺼져 있음을 찾아 활성화 후 재배포했다. 회사 설명에 따르면 때로 20초에 가까웠던 TTFT가 이전의 약 10분의 1로 줄고 캐시 적중률은 90%를 넘었다.
프리픽스 캐싱은 앞부분이 같은 요청이 기존 계산의 KV 캐시를 재사용하는 기능이다. vLLM 공식 문서는 이 기능이 입력을 처리하는 프리필 단계의 시간을 줄이며 새 출력 토큰을 만드는 디코딩 시간 자체를 줄이지는 않는다고 설명한다. 따라서 토스증권의 개선 폭은 공통 입력이 반복되는 회사 환경의 결과로 읽어야 하며 모든 LLM 요청의 속도 향상으로 일반화할 수 없다.
응답 이상은 종료 이유를 함께 봤다
다른 사례에서는 첫 토큰 지연의 상위 구간이 조금 늘었지만 그것만으로 문제를 설명하기 어려웠다. 개별 로그를 살펴보니 출력이 길이 제한으로 종료된 요청이 있었고, 추론 구간의 종료 표시가 예상과 다른 응답 영역에 나타났다. 회사는 관련 vLLM 문제와 알려진 우회 방법을 확인해 적용했다고 설명했다. 원문에는 특정 버전과 이슈 번호가 제시되지 않았다.
회사에 따르면 이 조치 뒤 관찰된 오류율은 0.2%에서 0.02%로 줄었다. 또 높은 캐시 적중률과 낮은 KV 캐시 사용량을 함께 보고 동시 처리 수를 높여 시험한 사례도 소개했다. 이런 결과는 관측 지표가 설정을 점검하고 부하 시험의 가설을 세우는 데 쓰였다는 근거다. 특정 설정이면 항상 같은 오류 감소나 처리량이 나온다는 보장은 아니다.
캐시 성공과 서비스 성공을 구분해야 한다
높은 캐시 적중률은 공통 입력의 계산을 잘 재사용했다는 뜻이지 사용자에게 필요한 응답을 완성했다는 뜻은 아니다. 출력 제한으로 답이 잘리거나 추론 내용과 최종 내용이 섞이면 지연이 짧아도 서비스는 실패할 수 있다. 운영 지표를 고를 때 처리 효율과 응답의 완료 조건을 함께 정의해야 한쪽의 개선이 다른 쪽의 문제를 가리지 않는다.
공식 캐싱 문서의 한계는 부하 시험 설계에도 직접 연결된다. 입력을 많이 공유하는 짧은 응답과 매번 다른 입력의 긴 응답은 같은 요청 수라도 부담이 다르다. 대표 입력·출력 길이와 반복 비율을 나눠 시험하면 캐시 효과와 생성 비용을 구분할 수 있다. 단일 평균 처리량보다 서비스가 실제로 받는 요청 구성을 유지하는 것이 도입 판단에 더 도움이 된다.
지표에서 가설을 만들고 로그로 확인한다
이 글이 제시하는 실무 흐름은 지표로 이상을 찾고, 개별 로그에서 이유를 확인한 뒤 설정 변경과 시험으로 가설을 검증하는 과정이다. 예를 들어 캐시 지표가 낮다면 먼저 공통 입력이 있는지, 해당 모델에 기능이 적용됐는지 확인할 수 있다. 길이 제한 종료가 늘었다면 출력 한도와 응답 형식부터 살피는 식으로 조사 범위를 좁힐 수 있다.
다만 원문이 공개하지 않은 모델·하드웨어·버전과 요청 분포를 채워 넣어 재현 가능한 벤치마크처럼 만들 수는 없다. 다른 팀이 가져갈 수 있는 것은 개선 수치 자체보다 관찰과 변경의 연결 방식이다. 배포 전후에 같은 요청군을 비교하고 변경을 되돌릴 조건을 정하면, 용량을 추가할지 설정을 고칠지 결정할 때 더 명확한 근거를 남길 수 있다.
출처
토스테크의 원출처와 본문에 표시한 참고자료를 바탕으로 한국어로 재구성했습니다. ‘ARCH.B 분석’은 자료를 읽고 덧붙인 편집 해석입니다.
LLM 서빙, 띄우는 것과 잘 띄우는 것 사이 (새 창)