인프라 프로비저닝을 위한 벡터 검색 성능과 품질의 정량화
토스증권 Data Infra 팀 장재영 엔지니어는 2026년 10월 기술 블로그를 통해 온프레미스 인프라 환경에서 Milvus 기반 대규모 벡터 검색 서비스를 배포하기 위한 물리 자원 사이징 기준과 최적화 과정을 발표했습니다. 서비스마다 임베딩 모델의 벡터 차원, 검색 품질 목표, 데이터 갱신 빈도가 상이하기 때문에 단순 공개 벤치마크 수치만으로는 실제 서버 도입 규모를 확정하기 어려웠습니다.
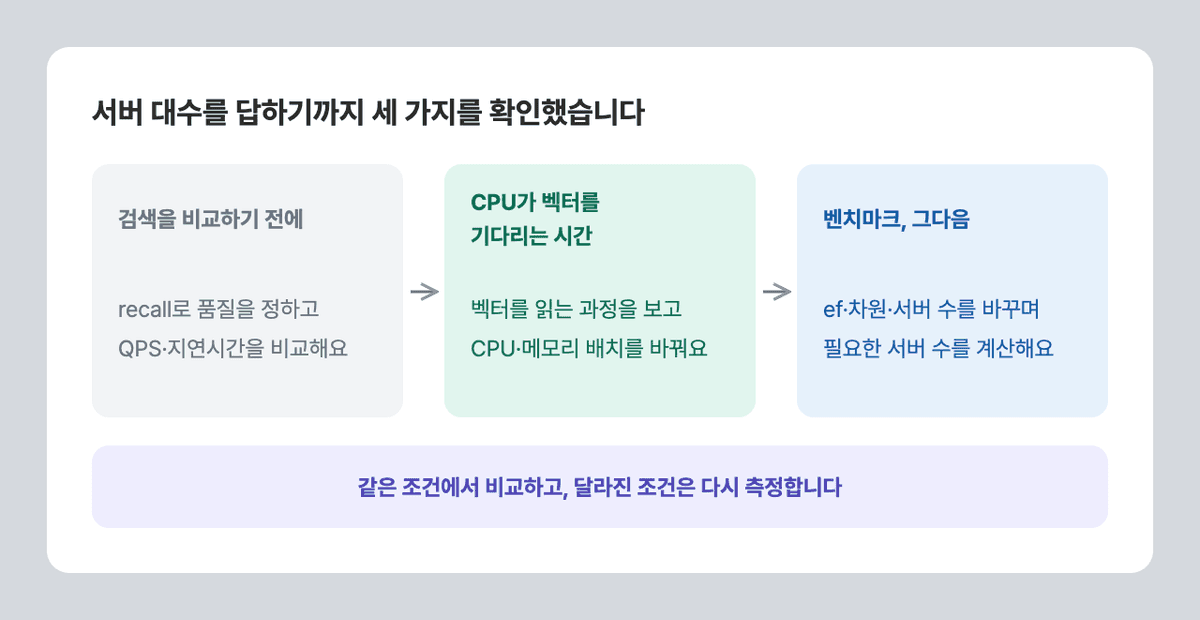
토스증권은 Intel Xeon Silver 4516Y+ 프로세서(2소켓, 서버당 물리 48코어/논리 96코어, 512GB DRAM)를 탑재한 전용 서버 3대를 구성했습니다. 평가 대상으로는 VectorDBBench의 LAION-100M(768차원, 1억 건, float32 기준 300GB 이상) 데이터셋을 사용했습니다. 목표 검색 조건은 상위 10개 결과를 반환하는 top-10 질의에서 전수 비교 정답 집합 대비 재현율(recall@10) 0.95 이상을 유지하면서 300 QPS 이상의 처리량을 안정적으로 확보하는 것으로 설정했습니다.
인덱스 알고리즘 검증과 HNSW_SQ8 채택
토스증권은 메모리 점유율을 낮추면서 요구 처리량을 달성하기 위해 기본 HNSW, DISKANN, IVF_SQ8, HNSW_SQ8 등 4개 인덱스 구성을 실측 비교했습니다. 비압축 HNSW(ef=16)는 재현율 0.950을 만족했으나 레플리카 1개당 약 335GB의 메모리를 소모하고 처리량은 192 QPS에 머물렀습니다. DISKANN(search_list=40)은 0.991의 높은 재현율을 기록했으나 SSD I/O 병목으로 인해 55 QPS에 그쳤고, IVF_SQ8(nprobe=32) 역시 군집 탐색 지연으로 인해 26 QPS로 처리량이 현저히 낮았습니다.
최종적으로 채택된 HNSW_SQ8(ef=48, refine 미적용)은 8비트 스칼라 양자화(Scalar Quantization)를 통해 성분 저장량을 성분당 4바이트에서 1바이트로 줄였습니다. 그 결과 1개 레플리카 기준 메모리 사용량을 약 114GB 수준으로 억제하면서도 recall@10 0.954와 316 QPS를 달성하여 초기 성능 목표를 유일하게 동시 충족했습니다.
NUMA 원격 메모리 병목 규명과 Kubelet 정책 개편
인덱스 최적화 이후에도 동시 요청 수를 10에서 300으로 30배 늘렸을 때 처리량이 357 QPS에서 468 QPS로 31% 증가하는 데 그치는 확장성 한계가 관측되었습니다. 리눅스 perf stat 및 하드웨어 성능 모니터링(PMU) 분석 결과, CPU 사용률은 높았으나 사이클당 명령어 처리 수(IPC)가 0.35~0.38로 비정상적으로 낮게 측정되었습니다. 그래프 기반 ANN 검색 특유의 무작위 메모리 접근 과정에서 기본 쿠버네티스 스케줄러가 2개 소켓에 프로세스를 분산 배치해 원격 소켓 DRAM 접근 비율이 약 50%에 달했던 점이 주요 원인이었습니다.
이에 따라 토스증권은 QueryNode 파드를 단일 NUMA 노드에 정렬하도록 Kubelet 설정을 개편했습니다. cpuManagerPolicy와 memoryManagerPolicy를 Static으로 지정하고, topologyManagerPolicy를 single-numa-node로 설정했습니다. 아울러 시스템 관리 데몬용 코어(reservedSystemCPUs)를 반대편 소켓 코어로 분리하여 QueryNode가 NUMA 0번 노드의 48개 논리 코어와 256GB 메모리를 온전히 점유하도록 배타적 배치를 완료했습니다.
소켓 격리 후 성능 개선 지표와 사이징 산정 규칙
NUMA 정렬 조치 이후 원격 소켓 DRAM 접근 비율은 기존 약 50%에서 0.8%로 급감했습니다. UPI 링크를 경유하는 메모리 지연이 사라지면서 IPC는 0.37에서 0.55로 올랐고, 초당 AVX-512 부동소수점 명령어 Retire 비율도 19.4B에서 24.0B로 24% 향상되었습니다. 이에 따라 3대 합산 동시성 90 기준 QPS는 405에서 572로 41% 증가했으며, 검색 p99 지연시간은 3.94초에서 2.04초로 48% 단축되었습니다.
실측 결과를 기반으로 토스증권은 '필요 서버 수 = max(목표 QPS 기준 필요 서버 대수, 메모리 적재량 기준 필요 서버 대수)'라는 인프라 사이징 공식을 도출했습니다. 탐색 파라미터 ef를 48에서 128로 높일 경우 recall은 0.962로 소폭 상승하지만 노드당 QPS는 190에서 99로 48% 급감하며, 벡터 차원을 2배로 확장하면 처리량이 약 3분의 1 수준으로 줄어든다는 점을 수식 모델에 반영했습니다.
실무 적용 시의 고려사항과 검증 한계
이번 사례는 다중 소켓 온프레미스 환경에서 VectorDB를 컨테이너로 운용할 때 운영체제 및 하드웨어 아키텍처 수준의 정렬이 필수적임을 보여줍니다. 벡터 검색은 캐시 적중률이 낮고 메모리 대역폭 의존도가 높기 때문에, vCPU와 메모리 총량만 맞추는 단순 스케줄링으로는 CPU가 메모리 반환을 대기하는 stall 현상을 피할 수 없습니다.
다만 실무 적용 시에는 토스증권이 명시한 한계점을 고려해야 합니다. 해당 실험은 공개 데이터셋(LAION-100M)과 난수 패딩 기반의 차원 확장을 바탕으로 측정한 수치이므로, 실제 서비스 환경의 벡터 군집도와 분포 패턴에 따라 동일한 파라미터에서도 recall과 처리량이 달라질 수 있습니다. 또한 실시간 데이터 쓰기를 처리하는 StreamingNode와 검색이 병행되는 복합 부하 상황에 대한 영향도는 이번 sealed 세그먼트 전용 측정에 포함되지 않았으므로 프로덕션 배포 전 자체 데이터 기반의 교차 검증이 요구됩니다.
출처
토스테크의 원출처와 본문에 표시한 참고자료를 바탕으로 한국어로 재구성했습니다. ‘ARCH.B 분석’은 자료를 읽고 덧붙인 편집 해석입니다.
CPU 뼛속까지 써먹고, Milvus 사이징 기준을 만들기까지 (새 창)