검색 노드의 규모를 정하기 위한 실험
토스증권 Data Infra 팀 장재영은 온프레미스 환경에서 벡터 검색에 필요한 물리 서버 규모를 가늠한 과정을 공개했다. 실험은 LAION-100M의 768차원 벡터 1억 건을 전용 서버 세 대에 올려 진행했다. 서버당 2소켓 Xeon Silver 4516Y+와 512GB 메모리를 사용했고, 후속 자원 배치 실험의 QueryNode 할당은 48vCPU·256GiB였다. 적재와 인덱스 빌드가 끝난 데이터의 검색이 대상이다. Milvus 2.6 공식 문서도 적재가 끝난 sealed 데이터 검색을 QueryNode, 실시간 growing 데이터 검색을 StreamingNode의 역할로 구분한다. 따라서 이 측정치를 지속적인 적재와 빌드가 섞인 전체 서비스의 용량으로 그대로 적용할 수는 없다.
품질과 처리량의 단위를 먼저 고정
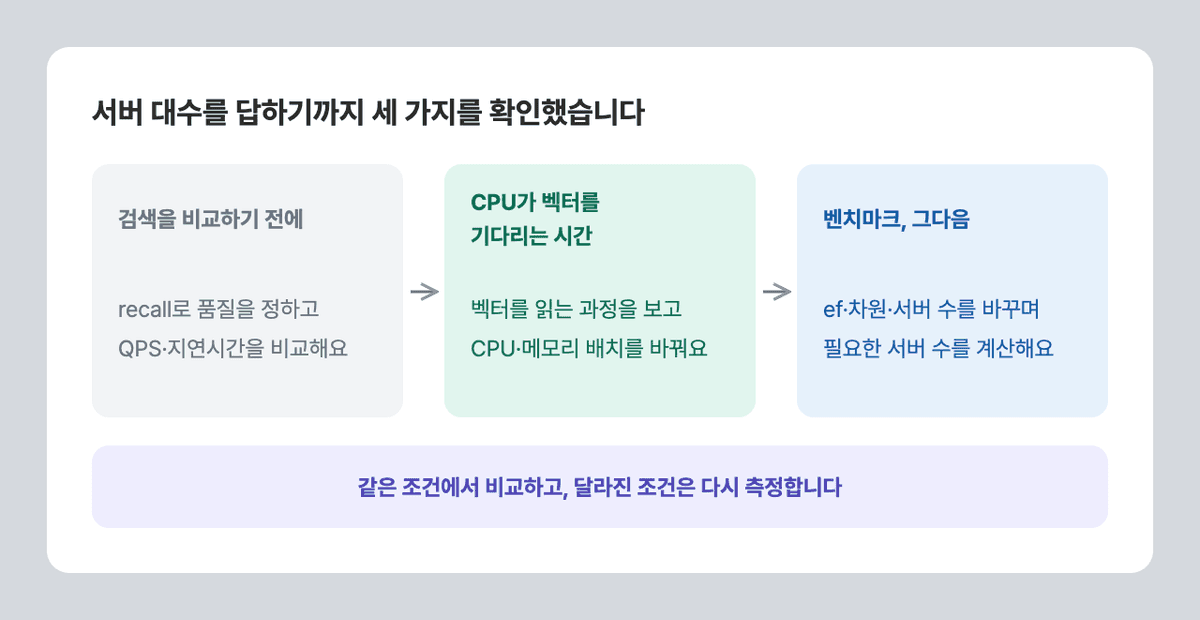
팀은 전수 비교로 구한 가까운 이웃 가운데 ANN 검색이 얼마나 찾아내는지를 recall@10으로 평가하고, 0.95 이상인 조건에서 처리 성능을 비교했다. 이 품질 지표는 임베딩이 사람에게 유용한 의미를 담는지와는 별개다. 또한 글의 QPS는 초당 요청 수인 RPS가 아니라 처리한 질의 벡터 수다. 한 요청에 여러 벡터가 들어갈 수 있어 숫자만 보고 API 요청 용량으로 바꿔 읽으면 안 된다. Milvus 공식 HNSW_SQ 문서의 ef는 검색 후보 탐색 범위를 정하는 값이며, 높이면 일반적으로 정확도와 검색 시간이 함께 늘어난다고 설명한다. 속도 비교에도 같은 품질 기준이 필요한 이유다.
압축된 벡터와 전체 메모리의 차이
사례의 HNSW_SQ8은 별도 인덱스 이름이 아니라 HNSW_SQ에 sq_type: SQ8을 지정하고 refine을 끈 구성이다. 공식 문서는 SQ8이 성분을 8비트로 표현하고, refine은 더 높은 정밀도로 후보 거리를 다시 계산하는 선택적 단계라고 설명한다. float32보다 성분 저장 크기가 줄어도 그래프와 스칼라 필드, 실행 여유 공간까지 같은 비율로 줄지는 않는다. 토스는 해당 실험의 데이터 한 벌을 검색하는 replica당 메모리를 약 114GB로 측정했다. 앞선 인덱스 비교는 검색 파라미터와 자원 할당을 함께 조정한 구성이므로, 그 표를 인덱스 이름만 바꾼 순수 성능 비교로 일반화하지 않았다.
검색 설정과 차원이 바꾸는 노드당 용량
토스가 최적화한 구성에서 ef48은 recall@10 0.954·노드당 190QPS, ef128은 0.962·99QPS였다. 작은 품질 기준 변화도 필요한 처리 자원을 바꿀 수 있다는 사례다. 서버와 동시성을 함께 늘린 측정은 1~3대 범위에서 거의 비례한 처리량을 보였다고 팀은 설명한다. 차원 실험은 원본과 질의 벡터에 작은 난수를 덧붙인 방식이며, 차원이 두 배일 때 처리량이 약 3분의 1로 줄었다. 이는 새 임베딩 모델의 검증 결과가 아니다. 실제 요구사항인 1024차원과 공개 데이터의 768차원도 달라, 서비스 데이터에서 품질·처리량·지연시간을 다시 확인해야 한다고 토스는 밝혔다.
처리량과 메모리 중 더 큰 요구를 기준으로
ARCH.B가 주목하는 것은 한 개의 QPS 수치를 서버 구매 기준으로 쓰지 않는 산정 절차다. 토스의 시뮬레이터는 검색 설정·차원에 따른 노드당 처리량으로 필요한 대수를 추정하고, 데이터와 인덱스를 메모리에 올리는 데 필요한 대수도 계산해 큰 쪽을 선택한다. 처리량을 맞춰도 데이터를 담을 공간이 부족하면 사용할 수 없기 때문이다. 반대로 메모리가 충분한 서버 수가 원하는 응답 속도까지 보장하지는 않는다. 원문은 지연시간 목표와 장애·점검 여유 용량을 별도로 확인한다. 따라서 이 도구의 값은 운영 대수의 자동 정답보다, 서비스 팀의 요구가 자원 비용에 어떤 영향을 주는지 검토할 초기 추정치에 가깝다.
할당량과 실제 배치 조건을 함께 확인
산정한 메모리가 실제로 사용할 배치에 들어가는지도 중요하다. 쿠버네티스 공식 문서는 Static Memory Manager가 리눅스의 Guaranteed Pod에 NUMA 배치 힌트를 제공하며, CPU·Topology Manager 설정과 예약 메모리를 함께 요구한다고 설명한다. single-numa-node 구현은 한 NUMA 노드에 맞는 힌트를 골라 배치 가능성을 판단한다. 공식 정책 문서에 따르면 한 노드에 맞출 수 없으면 Pod 수용이 거절될 수 있다. 그러므로 서버 전체 메모리의 합만 보고 배치 가능하다고 판단하기보다는, 서비스가 실제 쓸 수 있는 NUMA 자원과 시스템 예약분을 확인해야 한다. 원문의 설정 예와 공개 구현은 이러한 조건을 이해하는 근거이며, 특정 회사의 실험 결과를 다른 장비에서 재현한다고 보장하지 않는다.
출처
토스테크의 원출처와 본문에 표시한 참고자료를 바탕으로 한국어로 재구성했습니다. ‘ARCH.B 분석’은 자료를 읽고 덧붙인 편집 해석입니다.
CPU 뼛속까지 써먹고, Milvus 사이징 기준을 만들기까지 (새 창)