
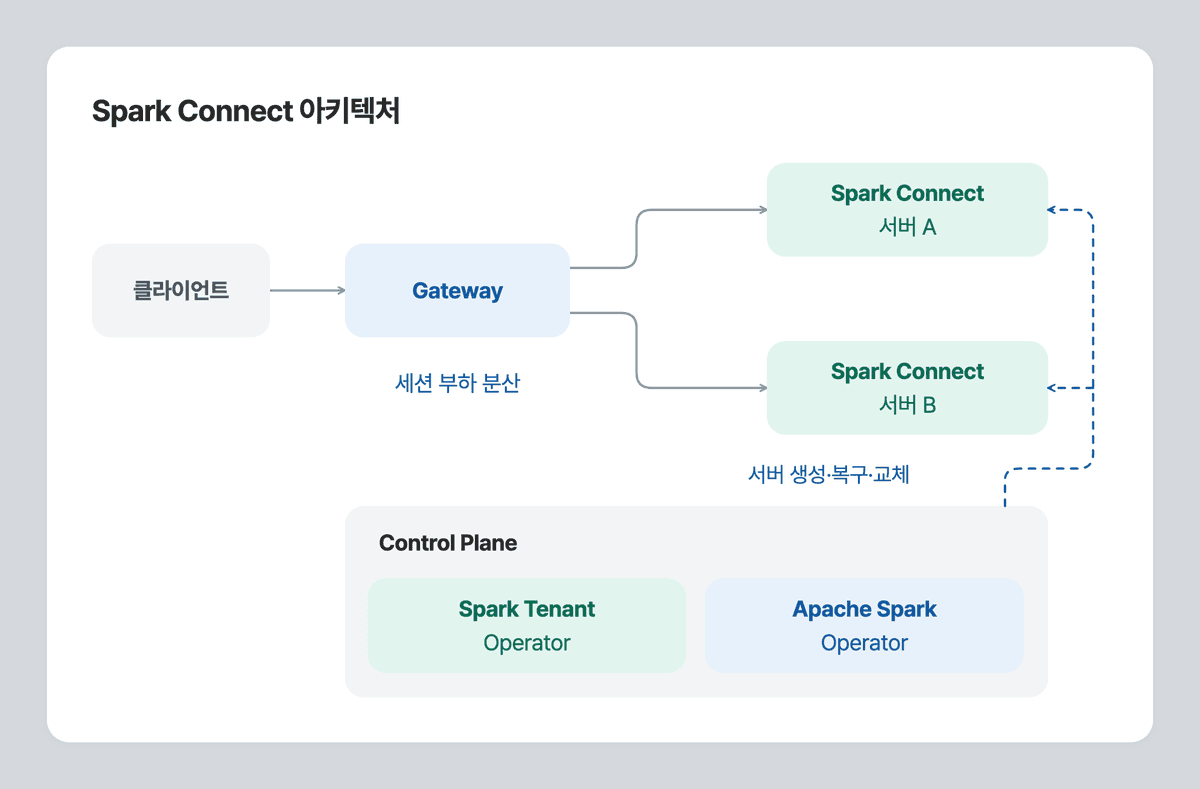
토스증권 Data Infra팀은 10월 14일 복수의 서버로 Spark Connect를 운영하는 제어 계층 설계 사례를 발표했다. 드라이버의 개별 실행과 관측은 Apache Spark Operator에 맡기고, 서버 그룹 전체의 규모와 설정 변경은 자체 Spark Tenant Operator로 나누어 다룬다. 분석 목적 서버와 무거운 파이프라인 전용 서버를 독립된 테넌트로 분리해 자원 경합을 줄이는 방식을 채택했다.
시스템 변경 시 드라이버 기동 실패가 발생하더라도 하위 재시도가 끝난 시점에 정상 서버가 남아 있을 때만 교체를 이어가며, 전멸 시에는 자동 교체를 멈추고 장애로 둔다. 기동 실패를 무조건 새 애플리케이션 생성으로 덮지 않고, 재시도 한도를 우회해 동일한 실패를 끝없이 반복하는 현상을 차단하려는 목적이다. 이는 상위 컨트롤러와 하위 실행 단위의 책임을 분리해 오작동 확산을 방지하는 데 초점을 맞춘다.
새 세대 준비와 기존 서버 drain의 분리
설정이 바뀌면 새 generation을 만들고 목표 수의 서버가 일정 시간 안정적으로 준비된 뒤에야 신규 세션을 전환한다. 기존 세션은 원래 드라이버로 보내며 이전 서버는 신규 세션을 받지 않는 drain 상태로 남긴다. 같은 Application의 재실행 횟수를 나타내는 attempt와 서버 집합의 세대인 generation을 명확히 구분해 관리한다.
다만 세션을 무기한 지켜주는 구조는 아니다. 원문상 drain 기본 제한은 90분이며 그 뒤 남은 세션은 끊길 수 있다. 새 서버가 제한 시간 안에 준비되지 않으면 교체를 취소하고 기존 서버를 유지한다. 업데이트 완료와 이전 서버 정리를 분리해 오래된 세션 하나가 다음 변경 전체를 막지 않도록 했다. 이러한 분리 설계를 통해 새 세대의 정상 안착 여부를 확인하면서도 서비스 중단을 피하도록 유도했다.
준비 검사와 주소 게시의 순환 대기 해소
처음 사용한 Spark UI의 HTTP 검사 경로는 Connect 서버가 뜨기 전에도 다른 페이지로 이동해 성공 판정을 만들었다. 팀은 최대 3초 안에 Connect 포트의 gRPC 연결이 성립하는지 확인하는 exec 검사로 바꿨다. 그래도 실제 쿼리나 세션을 실행하는 검사는 아니므로 Executor 용량까지 보장하지 않는다고 설명했다. 준비 검사의 성격을 명확히 한정함으로써 검사가 보장할 수 있는 범위를 규정했다.
Connect는 SparkContext 초기화 뒤 포트를 열지만 Executor 생성은 초기화 중 시작된다. 정적 자원 할당 환경에서 Executor가 Ready 이전에는 게시되지 않는 드라이버 DNS 주소를 기다리면 초기화와 Ready가 서로를 기다릴 수 있었다. 팀은 Executor가 드라이버 파드 IP로 직접 연결하게 하는 설정으로 우회했다.
별도로 upstream 변경은 Ready 이전 주소 게시와 Executor 생성 전 Ready 대기 생략을 함께 다룬다. 연결할 주소를 찾는 준비와 사용자 요청을 받을 준비를 분리하는 것이다. 원문은 이 설정이 Spark 4.3.0용으로 추가됐고 이전 버전에는 별도 백포트가 필요하다고 명시한다. 설정 이름만 복사해 구버전에도 바로 적용된다고 볼 수 없다.
장기 실행 메모리 관측과 cgroup 안정화
장기 실행에서는 GC 뒤 힙 사용량이 안정적이어도 프로세스·cgroup 메모리가 늘어나는 문제가 관측됐다. 팀은 힙 고정과 사전 할당 조건에 glibc arena 제한을 추가해 비교했다. MALLOC_ARENA_MAX=2를 넣은 72시간 관측에서는 증가가 나타나지 않았다고 보고했으며, 운영에는 코어 수를 고려한 max(4, cores) 정책을 사용했다.
이 결과는 해당 환경의 관측이지 모든 Spark 서버에 같은 숫자를 적용하면 누수가 해결된다는 보장이 아니다. 시험값과 운영값이 다른 이유도 구분해야 한다. 전체 메모리 지표와 JVM이 설명하는 사용량이 다를 때 원인을 더 좁혀 본 과정이 이 사례의 의미다. 네이티브 메모리 할당 패턴까지 포함해 컨테이너 자원 사용을 다각도로 점검해야 함을 보여준다.
서버 수가 복구돼도 세션은 돌아오지 않는다
같은 설정의 서버를 다시 띄우는 복구와 설정을 바꾼 새 서버 집합으로 옮기는 갱신은 성공 기준이 다르다. attempt가 늘어 정상 프로세스가 돌아와도 이전 드라이버 메모리의 세션이 되살아나는 것은 아니다. generation 교체가 끝나도 옛 세션을 정리하는 시간이 따로 남는다.
따라서 운영 화면에서 정상 서버 수 하나만 보면 교체 완료와 사용자 작업 보존을 혼동할 수 있다. 신규 세션의 목적지, 이전 서버의 잔여 세션, drain 제한 시간 도달을 함께 확인해야 한다. 이는 토스증권 사례에서 읽은 운영 기준이며 이 기사에서 서버 교체를 재현해 측정한 결과는 아니다.
| 동작 | 바뀌는 단위 | 남는 조건 |
|---|---|---|
| 재시도 | 같은 Application의 attempt | 이전 세션 복원 아님 |
| 설정 갱신 | 서버 집합의 generation | 새 집합의 준비 확인 |
| 신규 세션 전환 | 새 연결의 목적지 | 기존 세션은 옛 Driver |
| drain 정리 | 이전 서버의 수명 | 기본 제한 뒤 세션 종료 가능 |
쿠버네티스 공식 문서에서 readiness 검사는 컨테이너가 요청을 처리할 준비가 됐는지 판단하는 신호다. 어떤 요청을 검사하느냐가 신호의 의미를 결정한다. 화면 서버가 열렸다는 사실, 연결을 받을 수 있다는 사실, 작업을 끝낼 자원이 있다는 사실을 나눠야 준비 상태가 운영 판단에 유용해진다.
사례를 관통하는 기준은 프로세스가 살아 있는지와 사용자가 하던 일이 유지되는지를 따로 보는 것이다. 드라이버 재시작은 기존 세션을 복원하지 않고, 교체 성공 뒤에도 이전 세션 정리가 남는다. 따라서 정상 서버 수와 진행 동작을 분리해 표시한 설계는 장애 대응자가 무엇을 기다려야 하는지 판단하는 데 도움이 된다.
ARCH.B 의견
프로세스의 생존 여부와 사용자의 세션 연속성을 별개의 축으로 분리해 관측성을 확보한 판단은 분산 데이터 환경의 장애 제어에 유효하다. 드라이버 재시작이 기존 실행 상태나 캐시된 세션을 복원하지 못하는 한계 속에서, 서버 전체의 교체 성공과 개별 세션의 완료 시점을 떼어내 관리하는 방식은 운영 가시성을 크게 높여준다.
다른 조직이 이 구조를 적용하려면 기본 90분으로 제시된 drain 제한 시간과 전면 장애 시의 자동 교체 보류 기준을 작업 성격에 맞게 재정의해야 한다. 분석 테넌트와 배치 파이프라인 테넌트의 실행 특성이 다른 만큼 허용 시간 산정이 선행되어야 하며, 4.3.0 미만 버전을 사용하는 환경이라면 주소 게시 관련 upstream 수정 사항의 백포트 가능 여부와 런타임 호환성을 면밀히 사전 검증해야 한다.