MW당 6,000만 달러 시대의 자본 회수: 생산성·내구성·범용성 공식
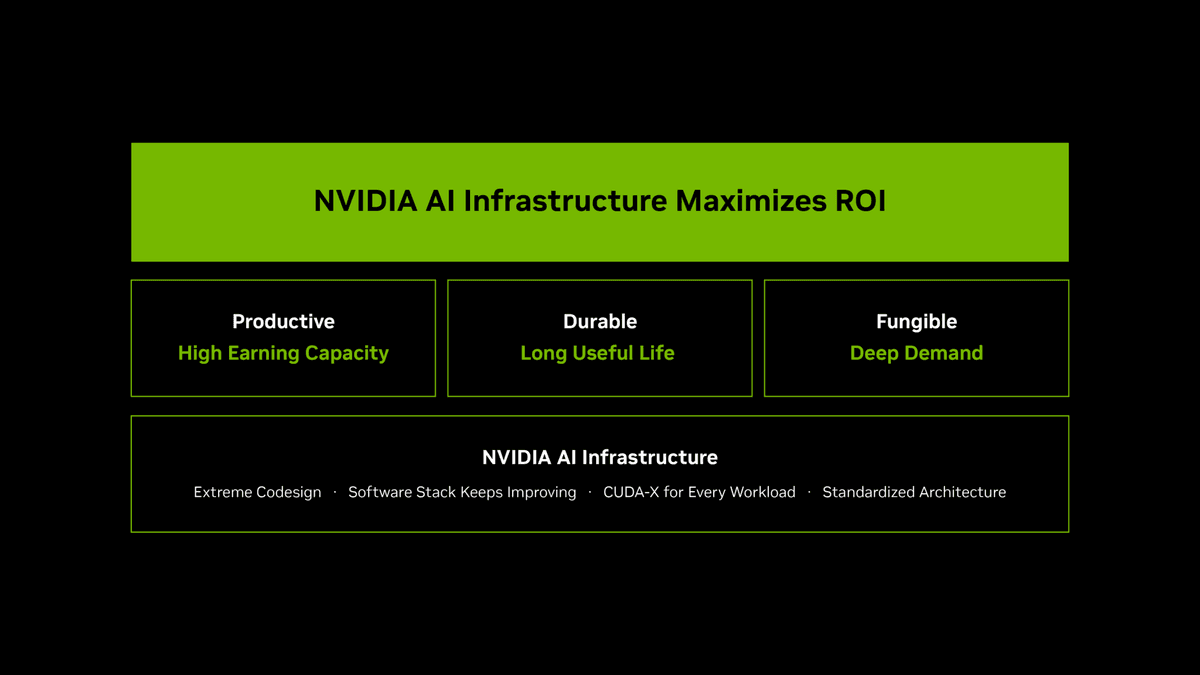
엔비디아는 공식 발표를 통해 인공지능 인프라 구축 단위가 메가와트(MW) 및 기가와트(GW) 급으로 확장되는 환경에서 AI 팩토리 1MW 구축 비용이 약 6,000만 달러(한화 약 800억 원 이상)에 달한다고 밝혔습니다. 대규모 자본 지출(CapEx)이 인프라 확장의 핵심 병목으로 부상함에 따라, 엔비디아는 운영사가 막대한 자본을 회수(ROI)할 수 있는 핵심 기준으로 생산성(Productivity), 내구성(Durability), 범용성(Fungibility)이라는 3대 투자 평가 프레임워크를 제시했습니다.
엔비디아의 설명에 따르면, 전력 공급이 고정된 데이터센터 환경에서는 메가와트당 초당 생성 토큰 수(Tokens/sec/MW)가 시스템의 최대 수익 역량을 결정합니다. 엔비디아는 전체 스택 공동 설계를 통해 전력 한도 내 토큰 생산량을 극대화하고 백만 토큰당 제조 단가를 낮추는 생산성, 새 아키텍처 도입 후에도 기존 장비가 지속적으로 가치를 창출하는 내구성, 그리고 전 세대 하드웨어를 아우르는 CUDA 생태계를 통해 AI 전 주기 및 비-AI 워크로드까지 수용하는 범용성을 결합해야 투자 타당성이 성립한다고 강조했습니다.
베라 루빈 시스템의 성능 개선 주장과 검증된 측정 조건
엔비디아는 차세대 베라 루빈(Vera Rubin) NVL72 시스템의 성능 지표를 공개하며, 기존 GB300 NVL72 대비 MW당 토큰 처리량이 30배 이상 증가하고 백만 토큰당 비용은 최대 45배(1/45 수준) 절감된다는 세미애널리시스(SemiAnalysis)의 AgentX 벤치마크 데이터를 인용했습니다. 토큰 단가가 급격히 낮아지더라도 새로운 응용 사례가 발굴되며 전체 연산 수요는 오히려 확장된다는 설명입니다.
그러나 이 수치는 범용적인 단일 턴 거대언어모델(LLM) 환경 전반에서 동일하게 나타나는 결과가 아닙니다. 해당 결과는 긴 컨텍스트 유지, 다중 도구 호출, KV-캐시 재사용을 특징으로 하는 코딩 에이전트 환경(AgentX) 및 DeepSeek V4 Pro 모델에 신규 저정밀도 포맷인 NVFP4를 적용하고 프리뷰 소프트웨어를 가동한 특정 시뮬레이션 조건에서 도출되었습니다. 따라서 범용 워크로드 전반에서 일률적인 30~45배 성능 도약을 단정하기는 어렵습니다.
구형 A100의 9년 장기 가동 실태: 소프트웨어와 물리적 시설의 복합 요인
엔비디아는 하드웨어의 내구성을 뒷받침하는 대표적 근거로 2020년 5월 출시된 A100 GPU를 지목했습니다. 발표에 따르면 6년이 지난 시점에도 A100은 현역으로 대규모 상용 서비스 중이며, 특화 클라우드 제공업체 코어위브(CoreWeave)는 2020년 도입 물량에 대해 2029년까지 유효한 장기 예약 계약을 체결했습니다. 단일 GPU 세대가 시장에 투입된 지 9년 후까지 상업적 수익을 창출하는 셈입니다.
또한 회계상 감가상각 연수와 물리적 가동 연수의 격차도 구체화되었습니다. 마이크로소프트의 경우 회계 장부상 6년 감가상각 기준이었던 V100 GPU 플릿을 실제 8.4년 동안 가동했습니다. 중고 시장 지표에서도 6년이 경과한 A100은 초기 도입가의 25%에서 최대 40% 안팎의 잔존 가치를 방어하고 있으며, 5년 장기 임대 단가 역시 1개월 단기 임대료의 80% 선을 유지하는 것으로 나타났습니다.
인프라 병목과 냉각 한계가 유도한 구형 하드웨어 수명 연장
엔비디아는 단일 아키텍처 기반의 CUDA 생태계와 지속적인 커널 최적화가 구형 하드웨어의 장기 가동을 견인했다고 강조하지만, 인프라 실무 관점에서는 전력망 확보 실패와 데이터센터 설비 한계라는 물리적 요인이 깊게 관여하고 있습니다. GB200 및 GB300 등 최신 NVL72 랙 시스템은 랙당 120~140kW의 막대한 전력 밀도와 고도화된 직접 액체 냉각(Direct-to-chip Liquid Cooling) 설비를 요구하므로, 전면적인 신규 데이터센터 증설 없이는 즉각적인 대량 배치가 불가능합니다.
반면 랙당 약 6.5kW 수준을 소모하는 레거시 공랭식 DGX A100 인프라는 기존 데이터센터 상면을 개조 없이 점유할 수 있는 현실적 대안입니다. 여기에 글로벌 HBM 공급망의 수급 불균형으로 인해 구형 규격(HBM2E)이라 하더라도 80GB 메모리 용량 자체를 확보하는 것이 중요한 서비스 계층이 존재합니다. 즉, A100의 9년 운용은 순수한 연산 가치 극대화뿐 아니라 데이터센터 전력 공급 제약과 물리적 시설 규격이 빚어낸 불가피한 수명 연장의 성격을 함께 띱니다.
금융 담보 심사와의 괴리: 데이터센터 투자자가 고려해야 할 실무 기준
엔비디아는 시장 조사 기관의 추정치를 바탕으로 H100 시스템의 경제적 수명을 5~6년, 최신 GB300 NVL72 시스템은 9~10년에 달할 것으로 전망하며 GPU를 안정적인 장기 금융 자산으로 위치시켰습니다. 그러나 주요 빅테크 및 하이퍼스케일러의 공식 감가상각 연한은 여전히 5.5~6년 수준에 머물러 있으며, 신형 NVL72의 장기 물리 내구성 및 부품 고장률은 아직 양산 환경에서 실측 검증되지 않은 모델링 단계의 예측치입니다.
더욱이 인프라 자금을 공급하는 실제 금융권(은행 및 사모대출 펀드)의 대출 심사 기준은 훨씬 보수적입니다. 급격한 인공지능 아키텍처 전환과 세대교체 위험을 감안할 때, 금융기관의 GPU 담보 인정 내용연수는 통상 3~4년 수준으로 제한됩니다. 따라서 인프라 운영사는 9~10년에 달하는 장기 회수 가정을 무비판적으로 수용하기보다, 상면 전력 규격과 보수적인 금융 상환 주기를 분리하여 설비 투자 계획을 정밀하게 수립해야 합니다.
출처
NVIDIA Blog의 원출처와 본문에 표시한 참고자료를 바탕으로 한국어로 재구성했습니다. ‘ARCH.B 분석’은 자료를 읽고 덧붙인 편집 해석입니다.
Productive, Durable, Fungible: How NVIDIA AI Factories Maximize Return on Investment (새 창)