비슷한 문서만으로 답하지 못한 문제
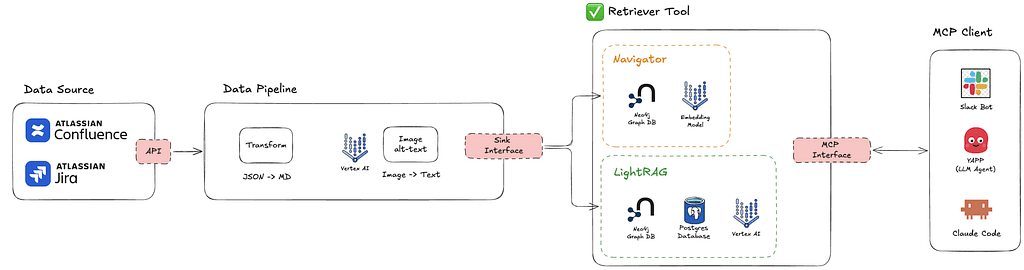
여기어때 공통플랫폼개발팀은 사내 지식 검색 시리즈의 두 번째 글에서 라이트RAG(LightRAG)와 Navigator를 함께 사용한 구조를 설명했다. 가이드와 요청 절차, 과거 이슈에 답의 조각이 흩어져 있어 유사한 청크만 찾는 방식으로는 관계를 이어가기 어려웠다는 것이다. 라이트RAG의 공식 프로젝트도 문서의 개체·관계에 기반한 지식 그래프와 벡터 검색을 결합하는 접근을 제시한다.
기술블로그는 검색 도구가 답변을 대신 작성하게 하지 않고, /query/data로 개체·관계·청크의 근거를 돌려주게 했다고 밝혔다. 최종 답변은 도구를 사용하는 에이전트가 만든다. 검색 서버와 답변 생성을 분리한 선택이므로, 검색 자료가 옳은지와 그 자료를 사용한 답변이 옳은지는 별도로 확인해야 한다.
비동기 처리의 완료를 따로 확인하다
팀이 사용한 업로드 방식에서는 같은 ID의 문서를 다시 보내도 수정본이 갱신되지 않았다고 기술블로그는 설명한다. 팀은 삭제를 요청한 뒤 문서 목록에서 실제로 없어졌는지 확인하고 재업로드하는 절차를 만들었다. 업로드 접수 이후 개체 추출이 호출 한도에 걸려 실패하는 경우도 있어, 실패 문서를 조회해 알리고 재처리하는 점검을 운영했다.
또한 날짜와 이슈 번호 등 불필요한 개체를 줄이고 사내 개념에 맞게 추출 타입과 예시를 바꿨다. 기술블로그는 이 프롬프트 개선 후 내부 검색 정확도가 76%에서 84%로 상승했다고 밝혔다. 이는 팀이 선택한 모델과 문서·평가 기준에서 나온 결과다. 사용 버전이나 인덱싱 설정을 확인하지 않고 현재의 모든 라이트RAG 설치에 같은 갱신 제약과 효과를 적용해서는 안 된다.
문서가 놓인 자리를 보존하는 Navigator
의미가 유사한 B2C와 B2B 게이트웨이의 같은 제목 문서를 구분하기 위해 팀은 Navigator로 Confluence 트리와 Jira 계층을 보존했다. Neo4j에 원본 구조를 옮기고, 검색된 조각에서 부모와 주변 문서로 이동하도록 했다. 헤딩과 문단을 기준으로 문서를 자르되 경로와 직전 조각의 일부 문맥은 임베딩 입력에만 붙여 조회 본문이 반복 정보로 지저분해지는 일을 피했다.
전사 문서 17만 건으로 확대할 때는 저장 키의 인덱스와 분할 적재, 최종 임베딩 텍스트와 모델 이름을 포함한 해시를 사용했다. 내용이 같으면 재처리를 건너뛰고 모델이 바뀌면 다시 임베딩할 수 있게 한 구성이다. 기술블로그는 적재 시간이 약 81% 줄고 메모리 사용률은 40% 감소했다고 설명했으며, 이 역시 해당 내부 개선 전후의 측정값이다.
의미와 구조는 서로 다른 오류를 막는다
ARCH.B의 관점에서 문서 계층을 남기는 선택은 검색 품질을 점수 하나로 설명하기 어려운 이유를 보여준다. 본문이 비슷해도 담당 조직과 시스템이 다르면 적용 가능한 지침이 달라질 수 있다. 같은 제목을 정확히 찾아도 잘못된 부모 아래의 자료를 사용하면 답은 틀린다. 계층 정보는 문서 유사도만으로 확인되지 않는 적용 범위의 근거가 된다.
그렇다고 폴더 위치가 문서의 정확성을 증명하는 것은 아니다. 오래된 가이드나 잘못 연결된 이슈도 있을 수 있으므로 수정 시각과 원본 링크를 함께 확인해야 한다. 검색 결과에서 계층을 보여주는 UI나 도구 응답을 설계할 때도, 위치를 답의 결론으로 삼기보다 어떤 조직과 업무에 해당하는 자료인지 확인하는 문맥으로 쓰는 편이 적절하다.
확장에서는 갱신과 재처리를 같은 단위로 보기
비동기 인덱싱에서 요청 성공과 검색 가능 상태는 다르다. 적재 파이프라인에는 접수된 문서뿐 아니라 완료·실패·재시도 중인 문서가 어떻게 조회되는지까지 남겨야 한다. 삭제 후 재등록은 실패 시 일시적으로 근거가 사라질 수 있으므로, 해당 절차를 도입하는 팀은 재처리 상태와 복구할 원문을 관리할 필요가 있다. 사례의 순서를 그대로 복사하기보다 자신이 쓰는 버전의 갱신 API를 확인해야 한다.
모델 이름을 해시에 넣는 방식은 임베딩 결과의 출처를 문서 변경 관리에 연결한다. 모델을 바꾸면 같은 텍스트도 새 검색 공간에서 다시 처리해야 하기 때문이다. 아카이브에도 청킹 기준과 임베딩 모델, 계층 경로의 구성법을 함께 적으면 과거 검색 결과를 설명하기 쉽다. 이런 운영 정보가 있어야 정확도 향상과 누락 복구가 각각 어떤 변경에서 비롯됐는지 추적할 수 있다.
출처
여기어때 기술블로그의 원출처와 본문에 표시한 참고자료를 바탕으로 한국어로 재구성했습니다. ‘ARCH.B 분석’은 자료를 읽고 덧붙인 편집 해석입니다.
사내 지식으로 Agentic RAG 만들기 (2/3) : 검색을 얹기, LightRAG와 Navigator (새 창)