데이터 출처 변경을 운영 요청으로 검증
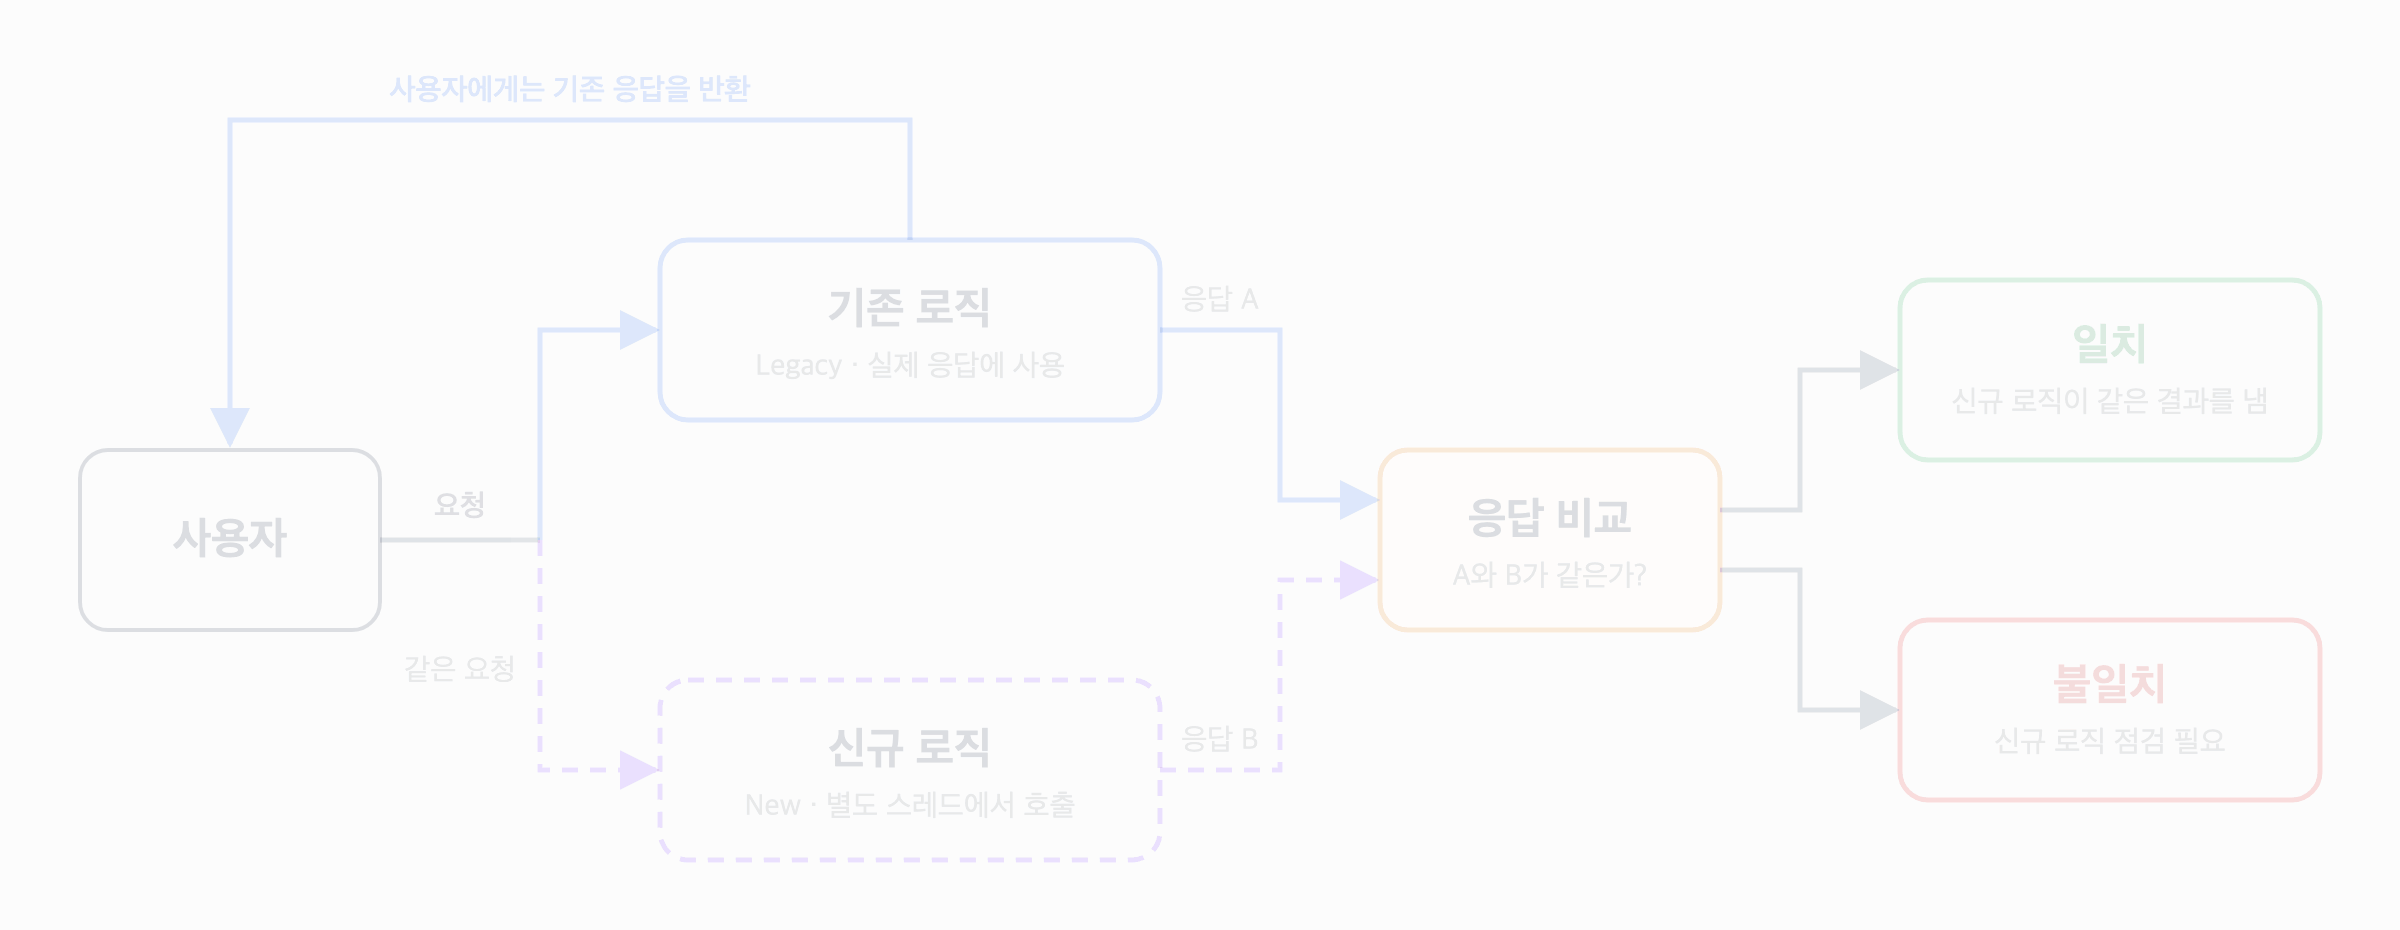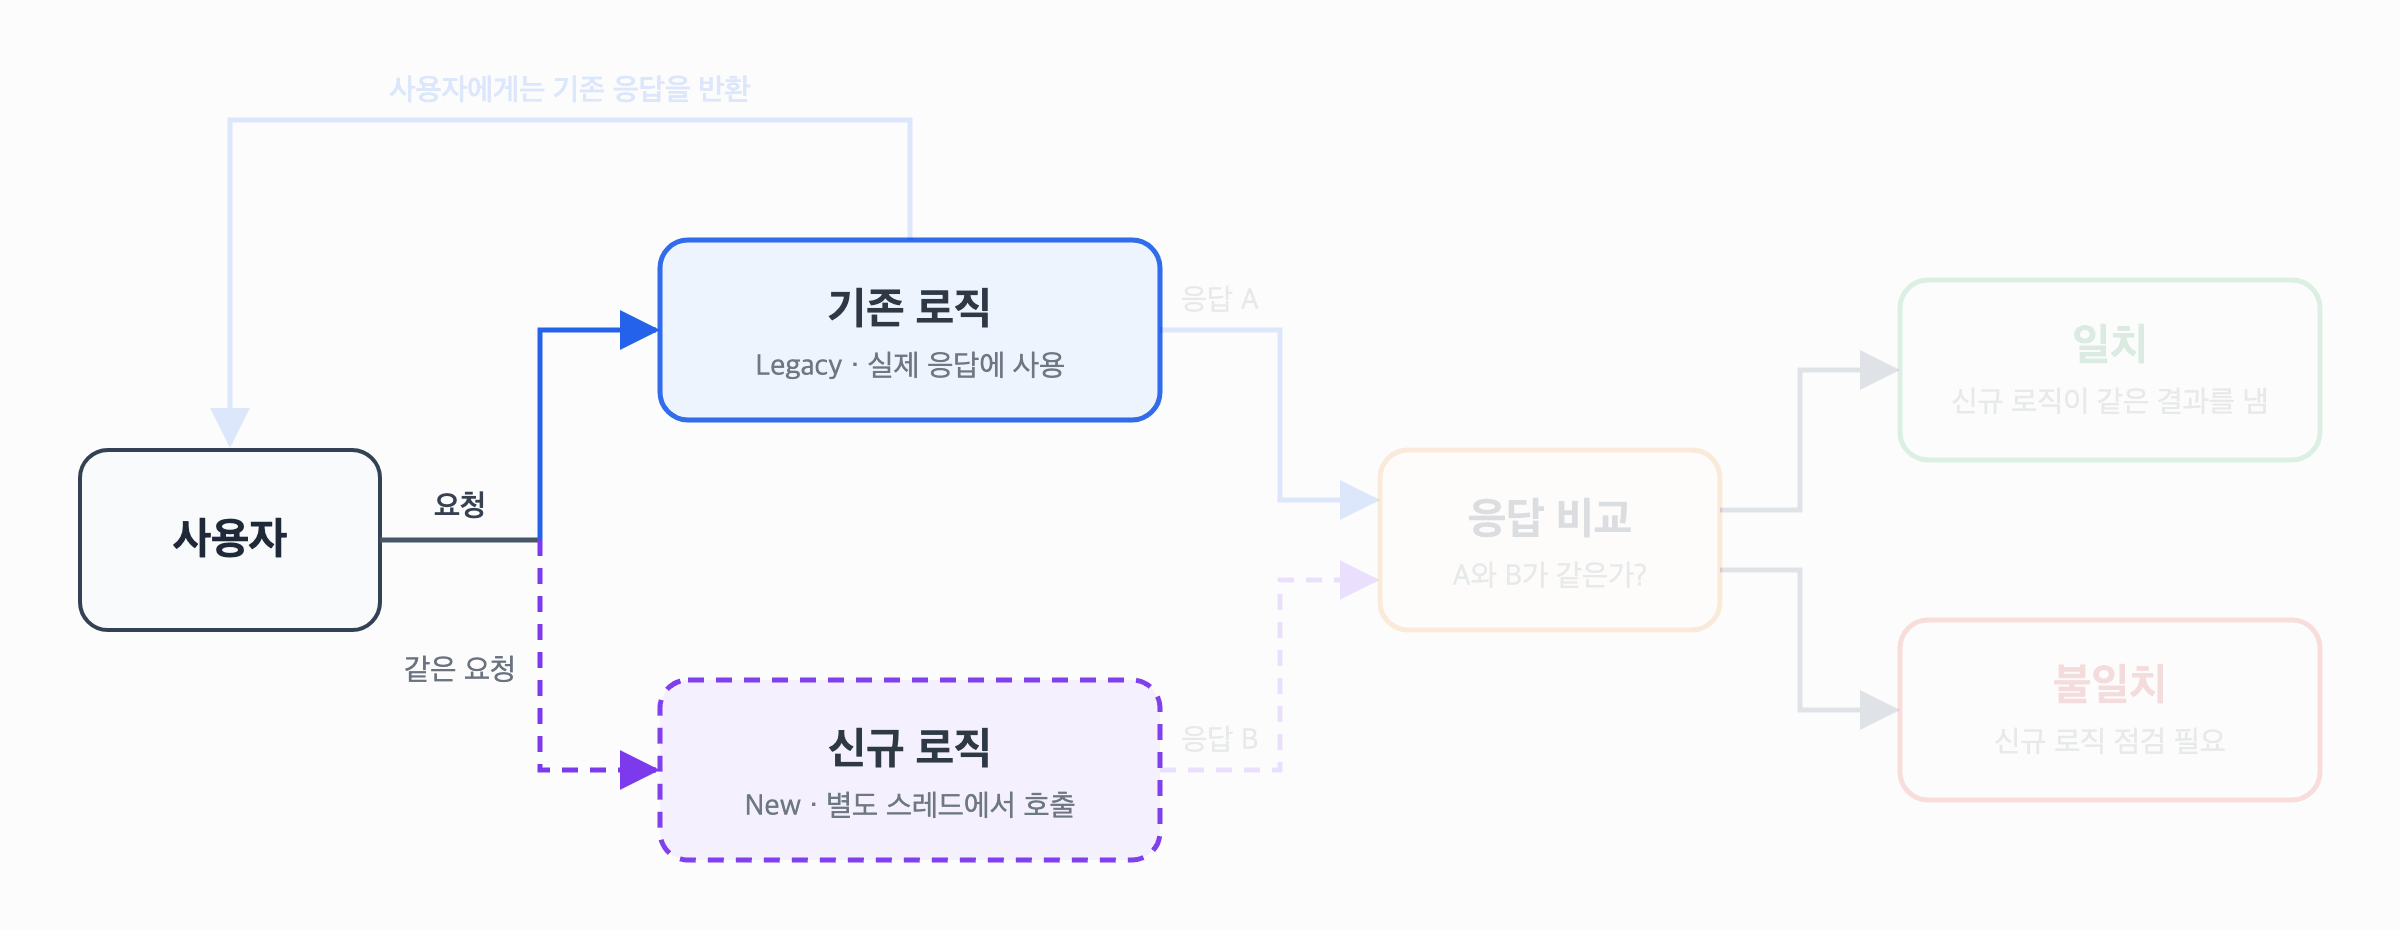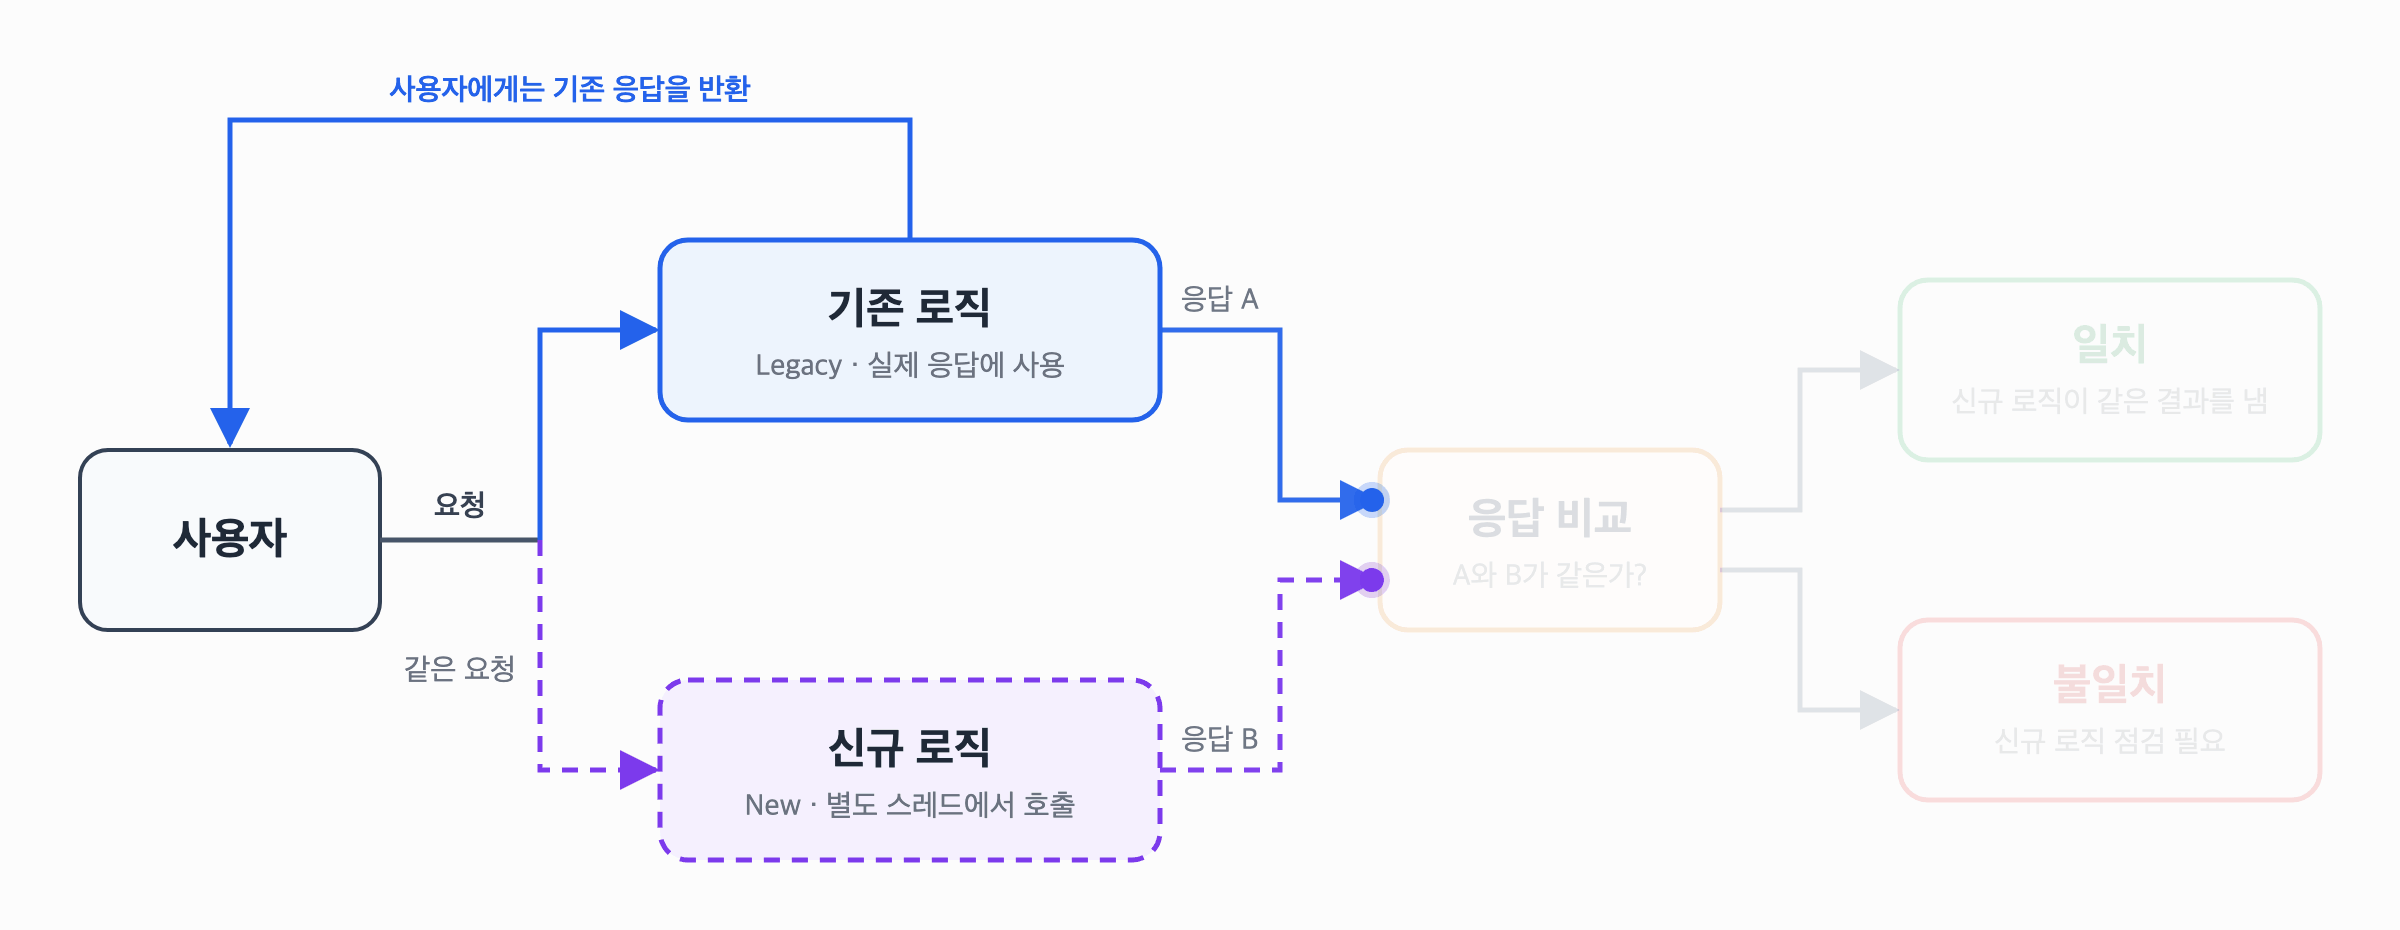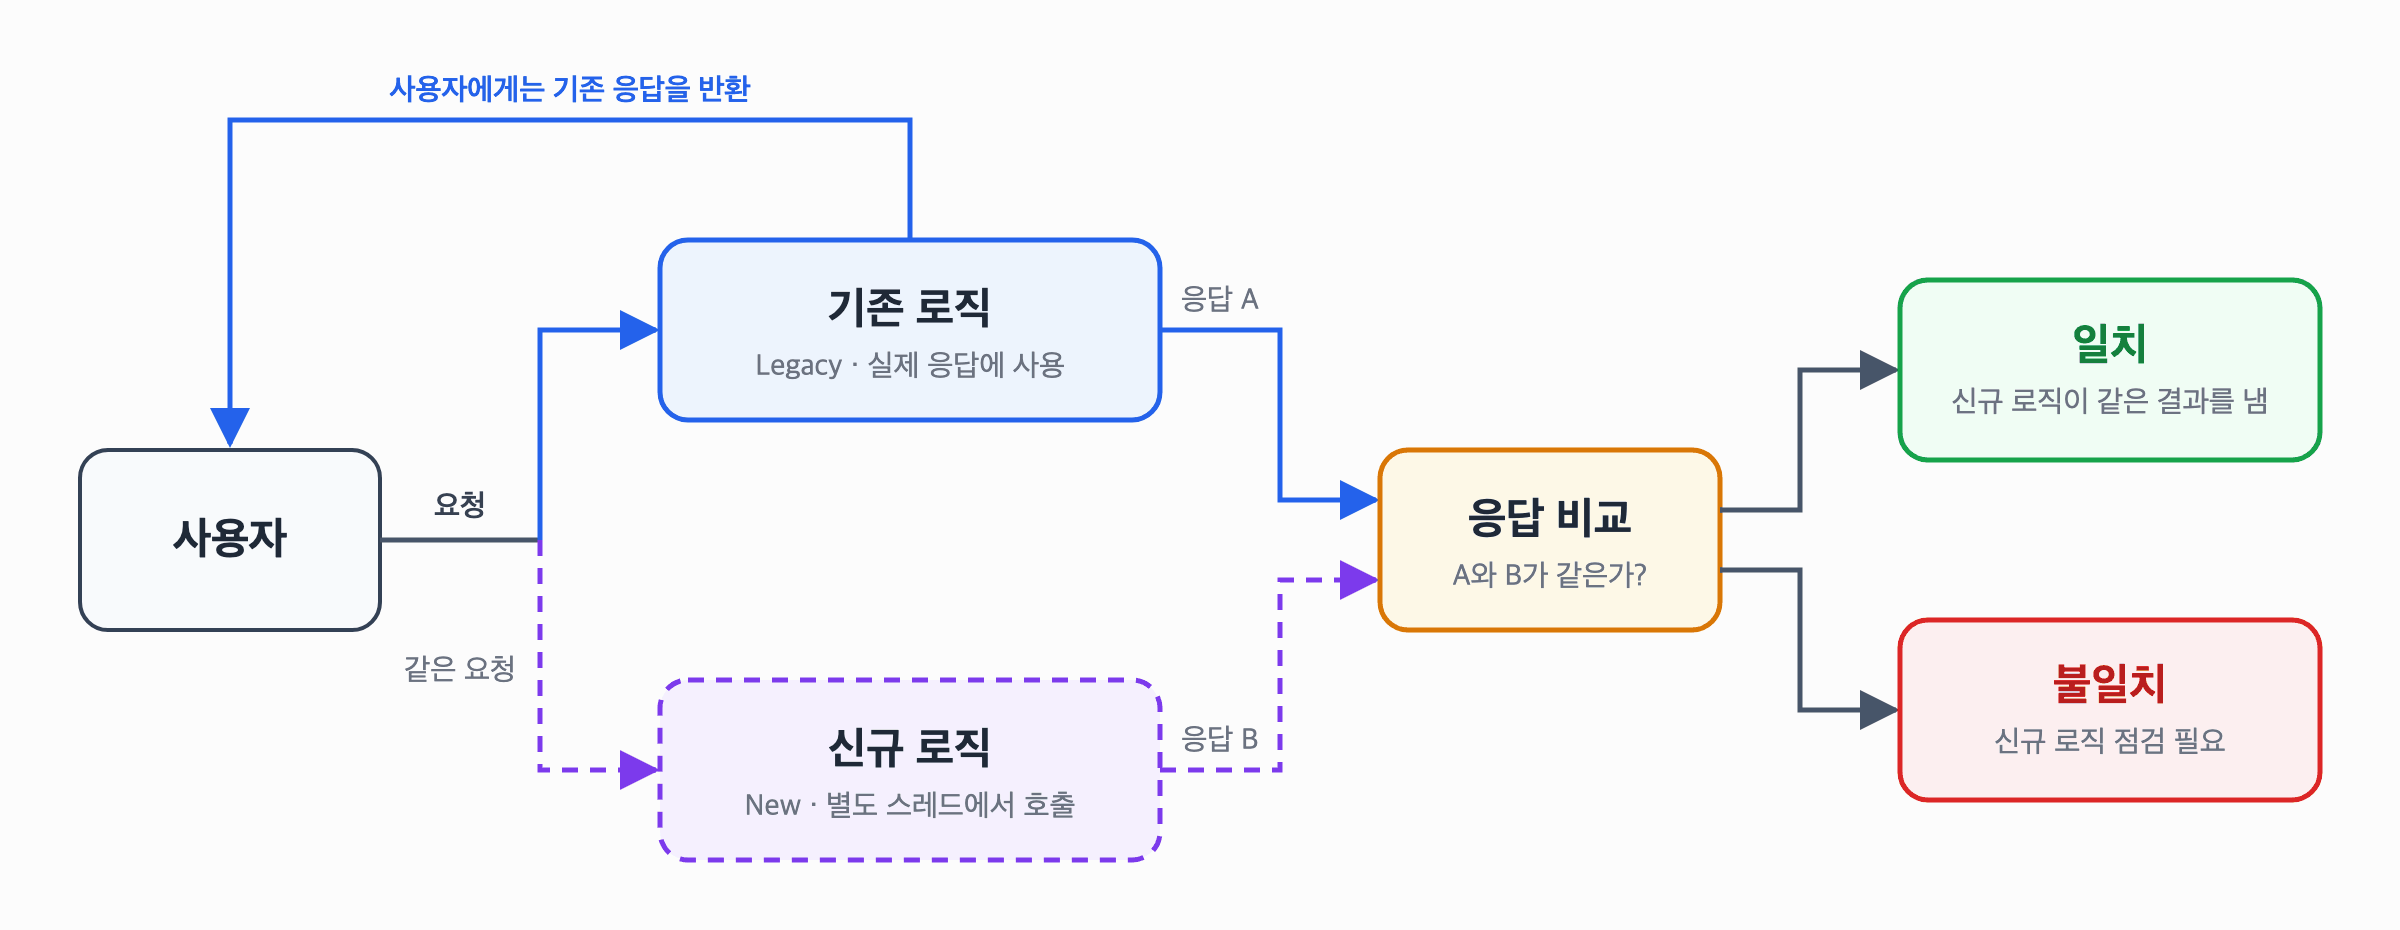
여기어때 전시개발팀은 Kafka 변경분을 MongoDB에 저장해 읽던 상품 정보를 원천 API에서 직접 조회하는 전환을 검증한 사례를 공개했다. 숙소와 객실, 날짜·인원·회원 등급·할인 조건이 얽혀 있어 내부 테스트만으로 운영 요청의 조합을 충분히 다루기 어려웠다고 설명한다. 팀은 기존 응답을 사용자에게 전달하고 별도 실행 경로에서 신규 결과를 비교하는 쉐도잉을 사용했다.
이전에는 불일치만 텍스트 로그로 남겨 전체 중 얼마나 다른지 계산할 분모가 없었다. API별 로그 형식도 달라 같은 문제의 반복을 구분하거나 요청을 다시 구성하는 데 사람이 개입해야 했다. 팀은 기존 Grafana·Prometheus·Loki를 사용하고, 실행과 기록은 공통 라이브러리로 묶되 도메인별 비교 기준은 애플리케이션에 남겼다고 밝혔다.
일치율과 비교 오류를 분리하다
새 구성은 실행 수와 MATCH·DIFF·ERROR 판정을 기록한다. 한 요청 안의 여러 필드가 달라도 불일치는 요청 한 건으로 세고, 필드별 차이는 따로 보존한다. 기술블로그에 공개된 일치율은 MATCH를 MATCH와 DIFF의 합으로 나눈 값이며 비교에 실패한 ERROR는 별도 패널에서 보여준다. 비교 불가능한 요청을 숨기지 않으면서 일치율의 뜻을 유지한 설계다.
기술블로그의 캡처 시점에는 수십만 건 비교에서 99.98%의 일치율이 나타났다. 같은 글은 특정 구간의 신규 처리시간이 약 20ms, 기존은 약 13ms였다고 설명한다. 두 수치는 공개한 시점과 구간의 사례이며 전체 운영 기간의 품질이나 평균 성능을 보장하지 않는다. 측정하지 못한 기존 처리시간은 0ms로 기록하지 않고 그래프에서 제외했다.
상세 값은 로그에, 제한된 차원은 메트릭에
팀은 숙소 ID와 실제 값을 메트릭 라벨에 넣지 않고, 필드 경로를 정규화하며 종류에 상한을 뒀다. 요청 조건과 차이는 SHADOW_EVENT라는 JSON 로그로 남겨 Loki에서 탐색한다. Prometheus 공식 지침도 고유한 라벨 조합마다 새 시계열이 생긴다며 사용자 ID 등 값의 종류가 끝없이 늘어나는 차원을 라벨에 저장하지 말라고 안내한다.
팀이 검토한 Diffy는 요청을 신규 서비스와 기존 서비스 두 벌에 복제하고, 기존끼리의 차이를 비결정적 노이즈로 판단하는 프록시 방식이다. 공식 문서도 이 세 인스턴스 구조를 설명한다. 이번 신규 로직은 같은 애플리케이션 내부의 다른 코드 경로여서 팀은 먼저 라이브러리와 대시보드를 구현했다. 프록시 오케스트레이션은 다음 단계의 준비 과제로 소개됐다.
전환 판단에는 빠진 비교와 흡수한 차이도 포함
ARCH.B의 관점에서 높은 일치율의 가치는 분모와 예외가 함께 보일 때 생긴다. ERROR가 많거나 특정 요청이 샘플링에 들어오지 않으면 관측된 일치율이 높아도 중요한 조건을 확인하지 못했을 수 있다. API별 결과와 기간을 나눠 보고 비교 불가능한 요청의 이유를 추적해야 전환 여부를 판단할 근거가 된다. 일치율 한 숫자는 통과 판정 그 자체가 아니다.
노이즈를 제거하는 기준도 운영 문서로 남길 필요가 있다. 기술블로그는 사용자 화면에 나가지 않거나 실행마다 달라지는 값만 제외하고 금액은 계속 비교했다고 설명한다. 제한된 반올림 차이를 흡수할 때도 별도 건수를 센다. 이런 기록이 없으면 비교기를 고친 뒤 일치율이 올라간 이유가 실제 오류 수정인지, 검사를 덜 하게 된 것인지 구분하기 어렵다.
관측용 코드도 사용자 응답과 분리해 검토
공개된 라이브러리는 이미 제공한 기존 결과를 재사용하고, 샘플링을 통과한 신규 로직을 별도 실행기에 넘긴다. 리포터별 오류도 분리해 검증 코드의 실패가 응답 처리에 번지지 않도록 했다. 다만 비동기로 실행하더라도 추가 API 호출과 자원 사용은 남는다. 도입 팀은 비교의 정확성과 함께 실행기의 처리량, 대기 상태, 보고 누락을 살펴야 한다.
요청 재현 정보는 문제를 다시 확인하는 데 유용하지만 저장 범위를 의식적으로 정해야 한다. 팀은 결과에 영향을 주는 헤더를 골라 남기고 사용자 ID 같은 민감 정보는 제외했다고 밝혔다. 아카이브에는 데이터 전환 이유와 최종 일치율만 적기보다 샘플링 조건, 제외 필드, 오류 집계와 미측정 처리 규칙을 함께 보존하는 편이 다음 검증에도 쓸 수 있는 기록이 된다.
출처
여기어때 기술블로그의 원출처와 본문에 표시한 참고자료를 바탕으로 한국어로 재구성했습니다. ‘ARCH.B 분석’은 자료를 읽고 덧붙인 편집 해석입니다.
쉐도잉 검증 개선기 (새 창)