인도 22개 언어용 2.8조 토큰 예고, 번역 데이터의 규모와 검증을 나눠 읽기
엔비디아와 IIT 마드라스 AI4Bharat가 인도 22개 언어의 약 2.8조 토큰 사전학습 자료와 생성 절차를 소개했다. 번역·평가·수정 과정은 공개 도구로 재사용할 수 있지만, 합성 번역이 지역 지식이나 자연어 원문을 대체하지 않으며 데이터 공개 예정과 학습 성과도 구분해야 한다.
엔비디아와 IIT 마드라스 AI4Bharat가 인도 22개 언어의 약 2.8조 토큰 사전학습 자료와 생성 절차를 소개했다. 번역·평가·수정 과정은 공개 도구로 재사용할 수 있지만, 합성 번역이 지역 지식이나 자연어 원문을 대체하지 않으며 데이터 공개 예정과 학습 성과도 구분해야 한다.
ServiceNow CoreAI 연구팀이 엔터프라이즈 환경에서 인공지능 에이전트의 취약점을 분석하고 폐쇄 루프 커리큘럼을 통해 맞춤형 합성 훈련 데이터를 구축하는 프레임워크 'AutoSynthData'를 발표했습니다. 이 파이프라인은 과제 해결 성공률을 유의미하게 끌어올렸으나, 소스코드 공개 여부와 절대 성공률 측면에서 검토해야 할 한계도 안고 있습니다.
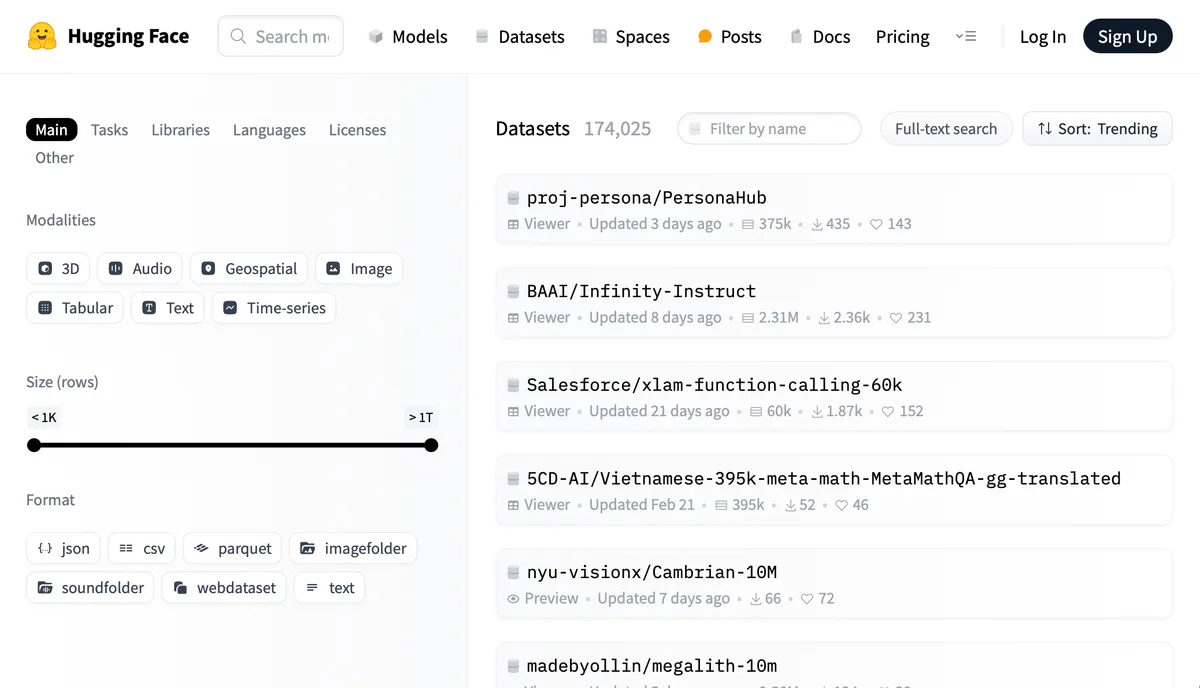
허깅페이스가 기존 데이터셋 저장소를 강화학습 환경으로 찾는 필터와 프레임워크 태그를 추가했다. Harbor·Verifiers·OpenEnv·NeMo Gym의 로딩 명령을 표시하지만 태그가 파일 형식을 변환하거나 작업을 실행하지는 않는다. 평가 보상의 의미와 실제 학습 업데이트도 각각 구분해야 한다.