Cloudflare, 복제·샘플링·집계 위치 바꿔 백본 트래픽 약 70GB/s 줄였다
Cloudflare 데이터 팀이 2026년 봄부터 가을까지의 파이프라인 개선으로 백본의 압축 트래픽을 약 70GB/s 줄였다고 보고했다. 원천에서의 이중 전송을 늦은 복제로 바꾸고, 샘플링과 집계를 앞당긴 결과다. 압축·추정·집계는 보존하는 정보와 절감 대상이 달라 수치를 같은 효과로 합산하면 안 된다.


Cloudflare 데이터 팀이 2026년 봄부터 가을까지의 파이프라인 개선으로 백본의 압축 트래픽을 약 70GB/s 줄였다고 보고했다. 원천에서의 이중 전송을 늦은 복제로 바꾸고, 샘플링과 집계를 앞당긴 결과다. 압축·추정·집계는 보존하는 정보와 절감 대상이 달라 수치를 같은 효과로 합산하면 안 된다.
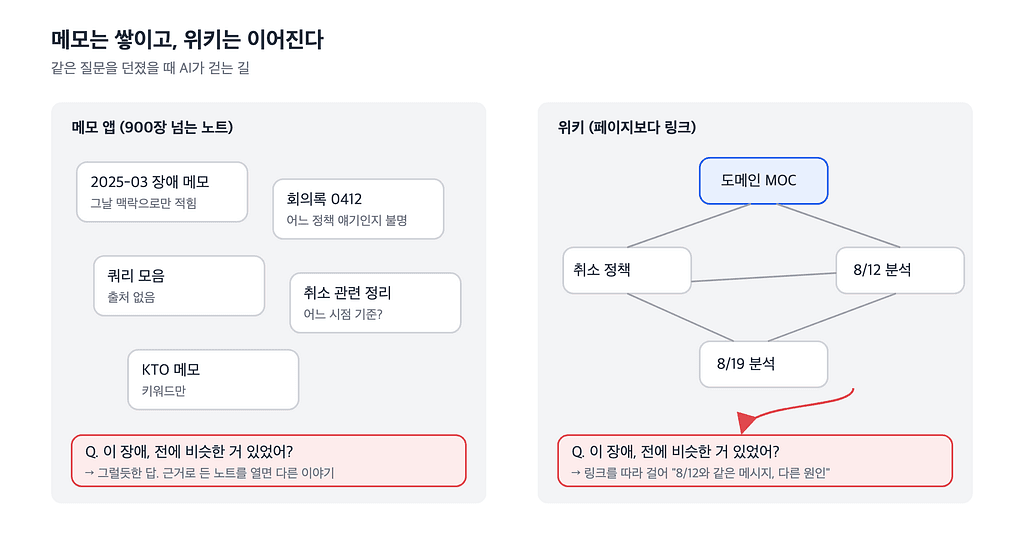
여기어때 유저혜택개발팀 엔지니어가 안드레이 카파시의 LLM 위키 패턴을 업무 환경에 맞춰 변형한 뒤 2달간 운영한 기록을 공개했다. 정적 연구 자료용 설계를 목차(MOC) 계층 추가, 원본의 이동·수정 전면 금지, 코드베이스 우선 검증 규칙으로 보완하여 반복되는 장애의 원인을 식별하는 성과를 냈으나, 정리 비용과 수동 수집 의존성이라는 명확한 한계도 확인됐다.
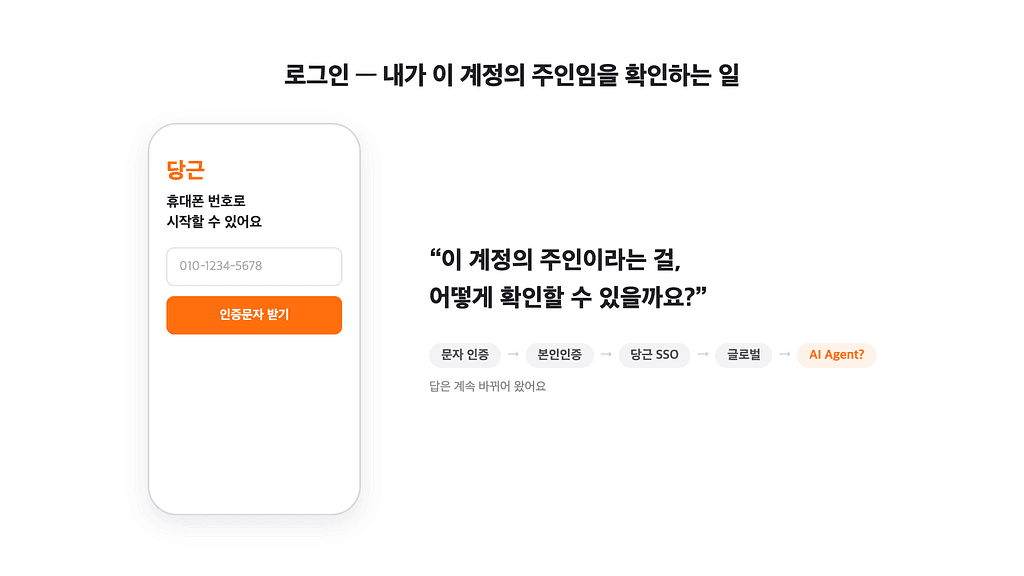
당근이 초기 휴대전화 번호 기반 점유 인증에서 시작해 연계정보(CI) 기반 본인인증, 중앙 집중형 통합 SSO, 그리고 AI 에이전트를 위한 OAuth 2.1 프로토콜로 인증 체계를 확장해 온 과정과 엔지니어링 전략을 살펴봅니다.
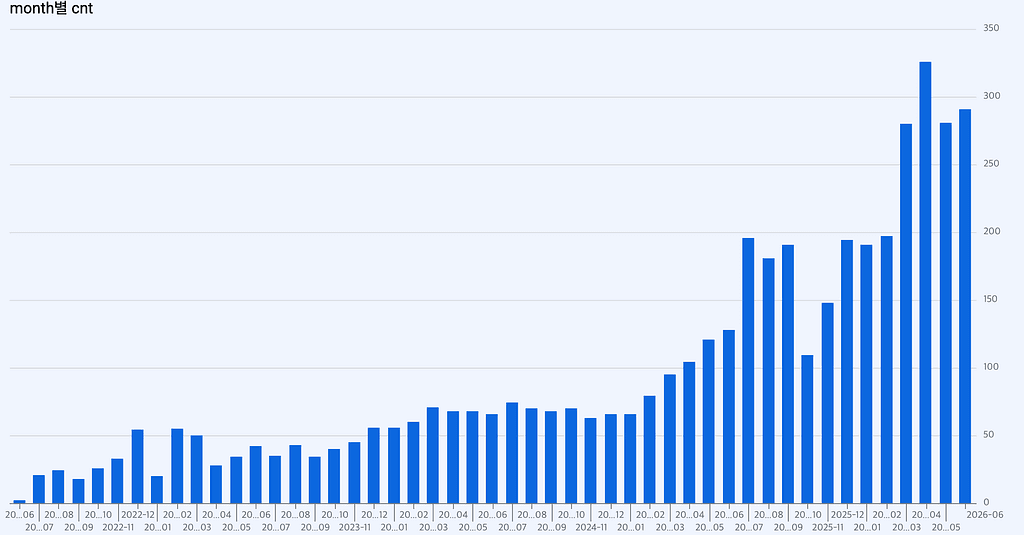
당근이 월 290여 건으로 급증한 A/B 테스트 환경에 맞춰 사내 실험 플랫폼을 개편했습니다. 깃허브 PR 기반 지표 정의를 UI 셀프서브 방식으로 전환하고, 슬롯 및 직교 레이어 기반 상호배제 그룹을 도입해 실험 간 간섭을 분리했습니다.
당근 광고주플랫폼팀이 프론트엔드와 백엔드 엔지니어를 단일 팀으로 통합하고 AI 도구와 문서화를 결합한 한 분기 운영 실험 결과를 공개했다. 직군 간 대기 시간을 줄이며 스토리 포인트 기준 완료량을 유지했으나, 완료 업무의 3분의 2가 무계획 돌발 작업으로 채워지는 등 부작용과 측정 지표의 한계도 함께 확인됐다.
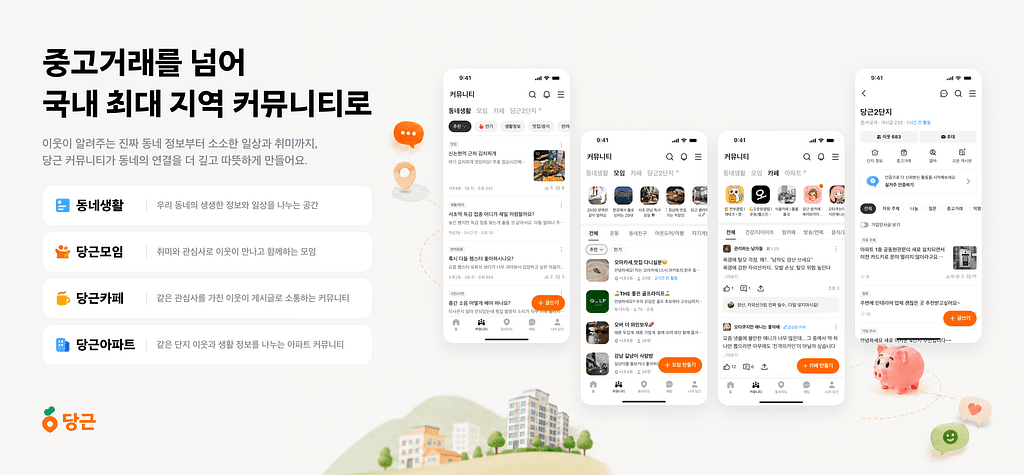
당근이 2026년 상반기 기준 월간 활성 사용자 1,000만 명을 돌파한 당근모임 등 커뮤니티 트래픽을 처리하는 시스템 구조를 공개했습니다. 소규모 조직 한계를 극복하기 위해 무리한 마이크로서비스 대신 단일 서버앱 기반 모듈형 구조를 택하고 스트리밍 렌더링을 적용한 과정이 상세히 정리되었습니다.
당근이 알바 서비스 내 하위 카테고리에 머물던 '레슨/과외'를 버티컬 독립 조직으로 분리하고 전국 단위 오픈을 준비 중이다. 1인 엔지니어 주도의 가설 검증과 수요 중심 퍼널 개편을 통해 공급자와 수요자를 각각 170%p, 150%p 이상 늘렸으나, 실제 거래 성사율과 법적 검증 체계, 비즈니스 모델(BM)에 대한 확인 과제는 여전히 남아 있다.