코어위브, 베라루빈 초기 운영과 Forge 공개…추론부터 재학습까지 연결
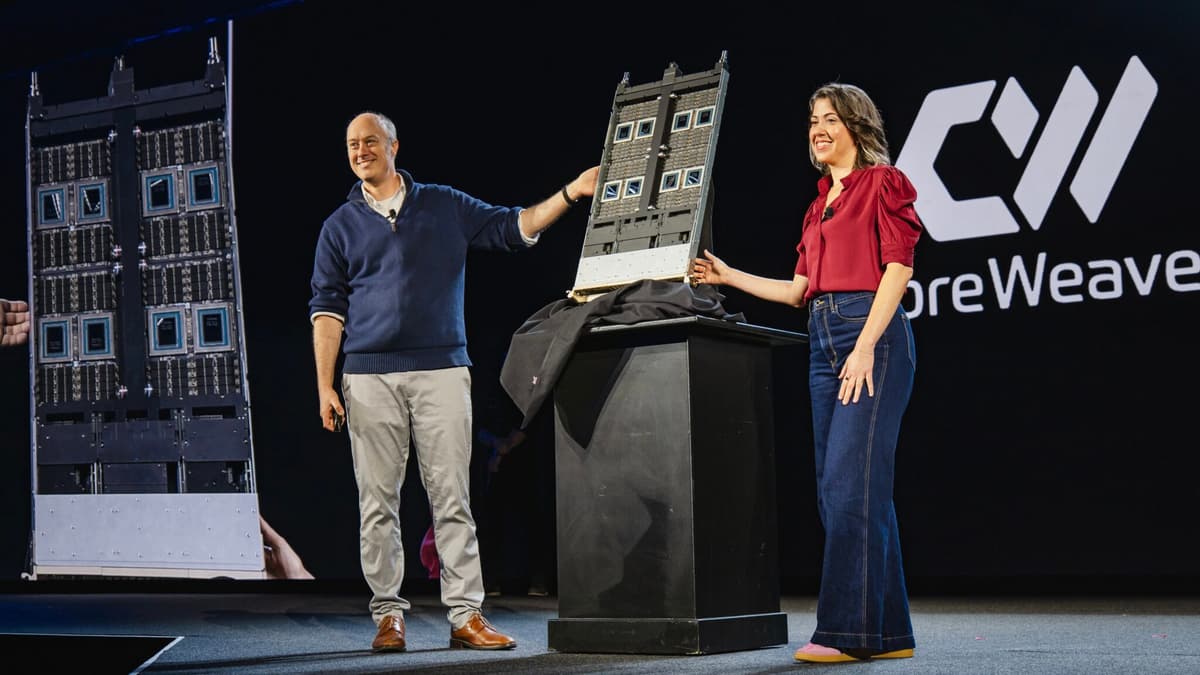
코어위브가 베라루빈 NVL72의 초기 고객 운영과 AI 개발 환경 Forge를 발표했다. 코그니션의 최대 4.8배 토큰 처리량은 특정 소프트웨어 작업의 초기 비교다. 일반 제공 도구, 향후 Vera CPU 공급과 비공개 프리뷰 기능은 단계가 다르다.


코어위브가 베라루빈 NVL72의 초기 고객 운영과 AI 개발 환경 Forge를 발표했다. 코그니션의 최대 4.8배 토큰 처리량은 특정 소프트웨어 작업의 초기 비교다. 일반 제공 도구, 향후 Vera CPU 공급과 비공개 프리뷰 기능은 단계가 다르다.
OpenAI가 프론티어 강화학습 실행에 앞서 위험과 통제 근거를 구조적으로 제시하는 안전 논증 방향을 공개했다. 학습 평가·환경 격리·감시뿐 아니라 반대 검토, 중단 절차와 사고 조사를 포함한다. 현재 구현 중인 권고이며 외부 인증이나 모든 배포 상황의 안전 입증은 아니다.
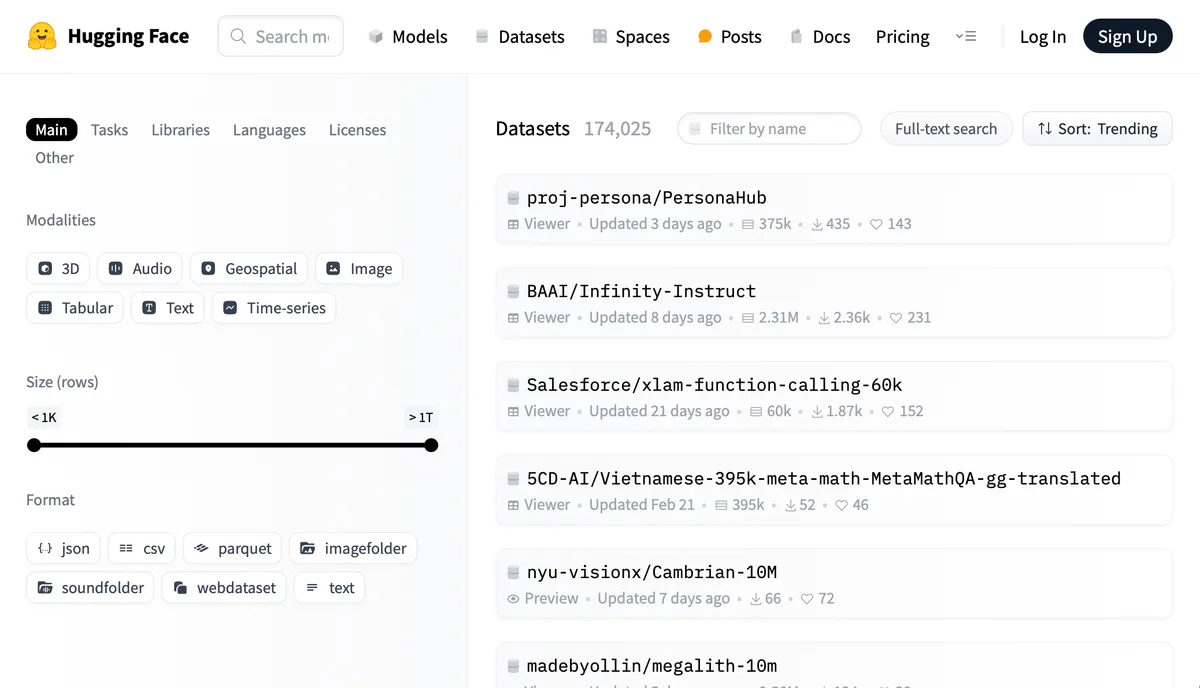
허깅페이스가 기존 데이터셋 저장소를 강화학습 환경으로 찾는 필터와 프레임워크 태그를 추가했다. Harbor·Verifiers·OpenEnv·NeMo Gym의 로딩 명령을 표시하지만 태그가 파일 형식을 변환하거나 작업을 실행하지는 않는다. 평가 보상의 의미와 실제 학습 업데이트도 각각 구분해야 한다.
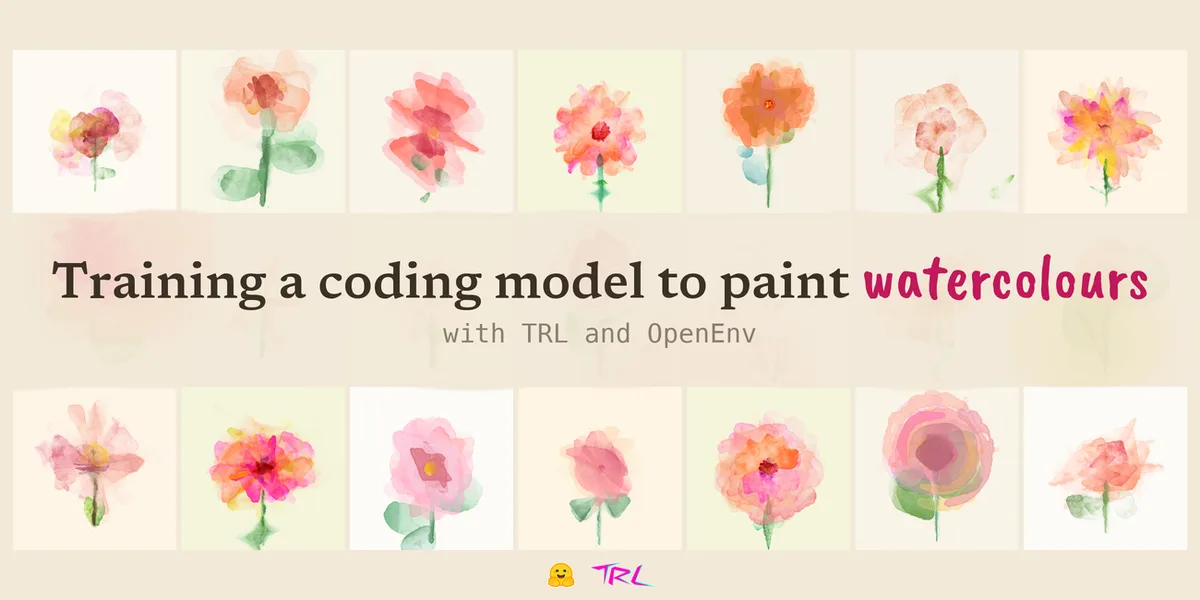
허깅페이스가 TRL과 OpenEnv로 코딩 모델의 수채화 표현을 학습한 실험을 공개했다. 모델이 만든 그림을 사람이 골라 참조 자료로 쓰고 보상 구성을 비교한다. 아름다움의 기준과 데이터의 범위, 평가 실패를 구분하는 일이 결과를 어떻게 바꾸는지 살핀다.
허깅페이스가 LFM2.5-350M에 100단계 GRPO 학습을 적용한 공개 실험을 소개했다. 동일한 서빙 환경의 2천 개 시험에서 통과율이 7.1%포인트 늘었다. JSON과 YAML의 차이, 형식 검증과 내용의 정확성을 구분해 결과를 읽는다.