취향을 보상으로 학습하다, 코드로 수채화를 그리는 공개 실험
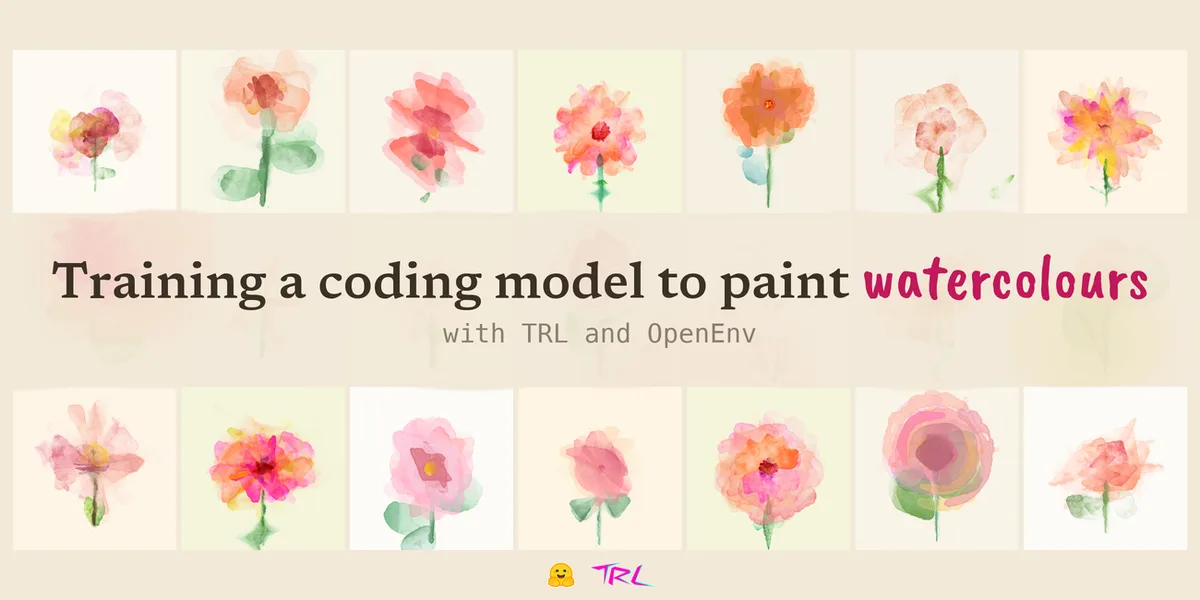
허깅페이스가 TRL과 OpenEnv로 코딩 모델의 수채화 표현을 학습한 실험을 공개했다. 모델이 만든 그림을 사람이 골라 참조 자료로 쓰고 보상 구성을 비교한다. 아름다움의 기준과 데이터의 범위, 평가 실패를 구분하는 일이 결과를 어떻게 바꾸는지 살핀다.


허깅페이스가 TRL과 OpenEnv로 코딩 모델의 수채화 표현을 학습한 실험을 공개했다. 모델이 만든 그림을 사람이 골라 참조 자료로 쓰고 보상 구성을 비교한다. 아름다움의 기준과 데이터의 범위, 평가 실패를 구분하는 일이 결과를 어떻게 바꾸는지 살핀다.