허깅페이스 ML Intern 제작 사례 공개… 작은 모델도 기준선·예산·평가가 먼저
허깅페이스가 자연어 지시로 학습·평가 작업을 수행하는 ML Intern의 여섯 제작 사례를 소개했다. 공개 모델 카드와 공식 문서는 작업별 성과, 비상업 라이선스, 계산 비용의 범위를 보여준다. 쉽게 시작하는 학습 에이전트에서도 기준선과 검증 가능한 산출물이 중요한 이유를 살핀다.
허깅페이스가 자연어 지시로 학습·평가 작업을 수행하는 ML Intern의 여섯 제작 사례를 소개했다. 공개 모델 카드와 공식 문서는 작업별 성과, 비상업 라이선스, 계산 비용의 범위를 보여준다. 쉽게 시작하는 학습 에이전트에서도 기준선과 검증 가능한 산출물이 중요한 이유를 살핀다.
리퀴드 AI가 텍스트 생성을 배제하고 단일 연산으로 분류·판단을 수행하는 오픈 가중치 의사결정 모델 ‘Open d1’ 2종을 허깅페이스를 통해 공개했다. 엣지 기기에서 수십 밀리초 단위의 저지연 처리를 목표로 설계되었으나, 작업 범위 제한과 벤치마크 검증 등의 과제도 남아 있다.
마이크로소프트와 허깅페이스가 AI 에이전트의 텍스트 답변 대신 백엔드 데이터베이스 상태를 직접 검증하는 벤치마크 '씽킹박스'를 공개했다. 12만 회 이상의 대규모 테스트 결과, 실제 DB 상태 검증에 실패한 시도 중 67.24%가 도구 호출 오류 없이 정상 응답으로 종료된 것으로 나타나 에이전트 신뢰도 검증 방식의 근본적 전환을 요구하고 있다.
허깅페이스가 수주가 걸리던 음성 합성(TTS) 모델 평가를 수 시간 단위로 단축하는 '오픈 TTS 리더보드'를 공개했습니다. 명료도(WER), 화자 유사도, 실시간 지연 시간(TTFA) 등 자동화된 정량 지표를 바탕으로 오픈소스 모델 중심의 객관적 벤치마크 환경을 구축했습니다.
허깅페이스가 기존 데이터셋 저장소를 강화학습 환경으로 찾는 필터와 프레임워크 태그를 추가했다. Harbor·Verifiers·OpenEnv·NeMo Gym의 로딩 명령을 표시하지만 태그가 파일 형식을 변환하거나 작업을 실행하지는 않는다. 평가 보상의 의미와 실제 학습 업데이트도 각각 구분해야 한다.
허깅페이스가 oMLX 창시자이자 유지보수 담당자인 Jun Kim의 합류를 발표했다. 회사는 프로젝트의 전담 개발과 장기 지원, MLX 모델 구현의 개선을 목표로 제시했다. oMLX의 Apache 2.0 라이선스와 창시자의 리드는 유지하며, 향후 계획과 현재 서버 기능·실행 조건을 구분해 정리했다.
허깅페이스가 ggml의 Metal 커널로 압축 가중치를 직접 계산하는 Transformers 실행 경로를 소개했다. 초기 대상은 애플 실리콘과 Qwen3.5 계열이다. 익숙한 Python·PyTorch 인터페이스로 GGUF를 다루지만 커널이 없으면 가중치를 풀어 메모리를 더 쓰고, llama.cpp 비교도 서로 다른 측정 조건을 명시한다.
영국 AI Security Institute와 EvalEval이 평가 결과를 Evaluation Cards로 공개하는 협력을 소개했다. 다섯 주요 벤치마크의 여섯 모델 결과와 별도 사이버 평가를 다루며 Every Eval Ever 형식으로 맥락·설정을 연결한다. 연계 논문은 추론 자원과 실행 절차에 따라 점수가 달라지므로 동일 예산·조건 비교가 필요하다고 설명한다.
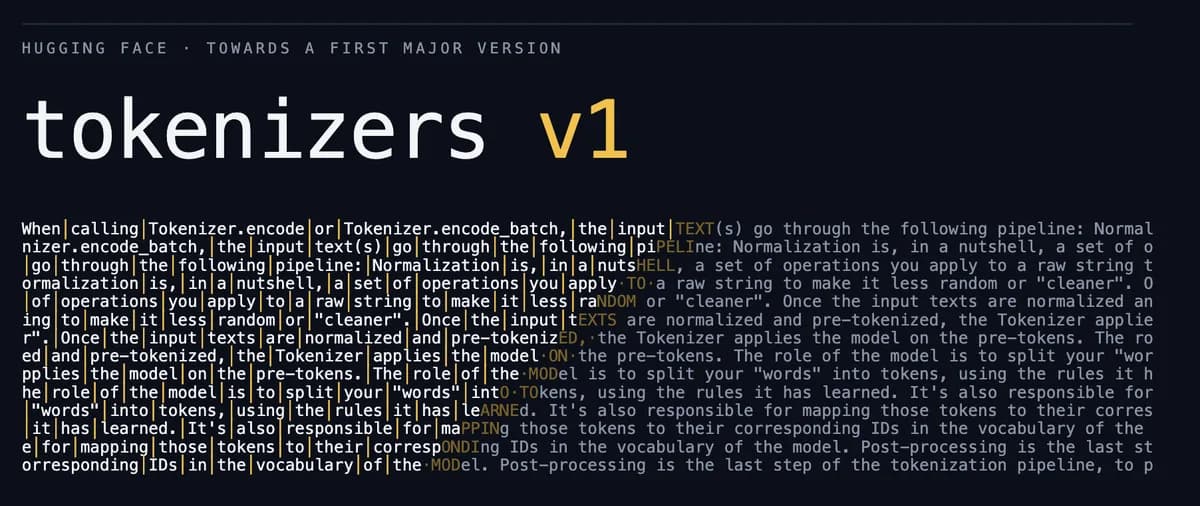
허깅페이스가 출력과 API를 유지하며 tokenizers의 처리 경로를 바꾼 v1 후보판을 소개했다. Apple M4 Max의 특정 비교에서 인코딩 성능 개선을 보고했지만 Python 호출 비용과 언어·반복도·전체 모델 처리 시간은 다른 조건이다.
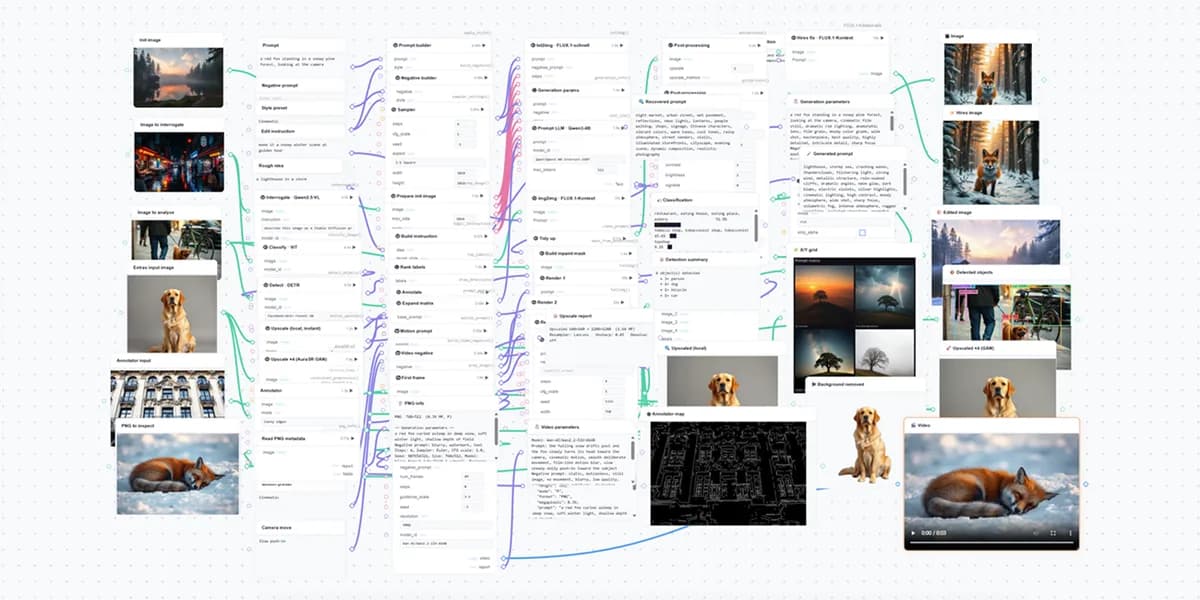
허깅페이스가 AUTOMATIC1111의 여러 작업을 Gradio의 한 캔버스로 다시 구성한 사례를 공개했다. 함수·모델·Space·데이터셋을 연결하지만 모든 작업이 무료나 로컬에서 수행되는 것은 아니다. 화면의 연결과 실제 API 단위·권한·이용량을 함께 볼 필요가 있다.
허깅페이스가 학습과 생성 작업을 별도 Jobs에 놓고 LoRA 어댑터를 버킷으로 공유하는 실험을 공개했다. 작은 전송량만큼 중요한 것은 같은 버전의 정책과 캐시를 유지하는 일이다. 특정 설정의 성능 결과를 모든 모델의 정확도나 처리량으로 확대할 수는 없다.
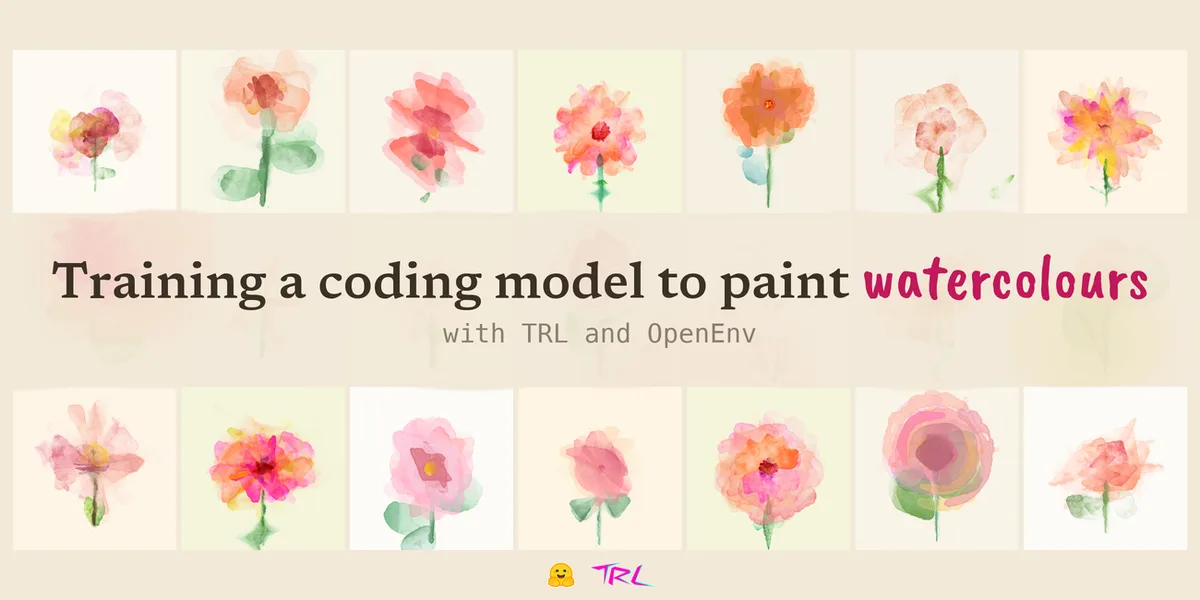
허깅페이스가 TRL과 OpenEnv로 코딩 모델의 수채화 표현을 학습한 실험을 공개했다. 모델이 만든 그림을 사람이 골라 참조 자료로 쓰고 보상 구성을 비교한다. 아름다움의 기준과 데이터의 범위, 평가 실패를 구분하는 일이 결과를 어떻게 바꾸는지 살핀다.
허깅페이스가 에이전트 세션 기록을 검색 가능한 기억으로 만드는 funes를 소개했다. 원문과 출처를 함께 반환하고 필요할 때 자신이 소유한 데이터셋으로 공유한다. 기록의 검색과 사실의 확정, 로컬 처리와 공유 범위의 차이를 살핀다.
허깅페이스가 LFM2.5-350M에 100단계 GRPO 학습을 적용한 공개 실험을 소개했다. 동일한 서빙 환경의 2천 개 시험에서 통과율이 7.1%포인트 늘었다. JSON과 YAML의 차이, 형식 검증과 내용의 정확성을 구분해 결과를 읽는다.