여기어때, 사내 RAG에 검색·답변 평가와 MCP 운영 체계 구축
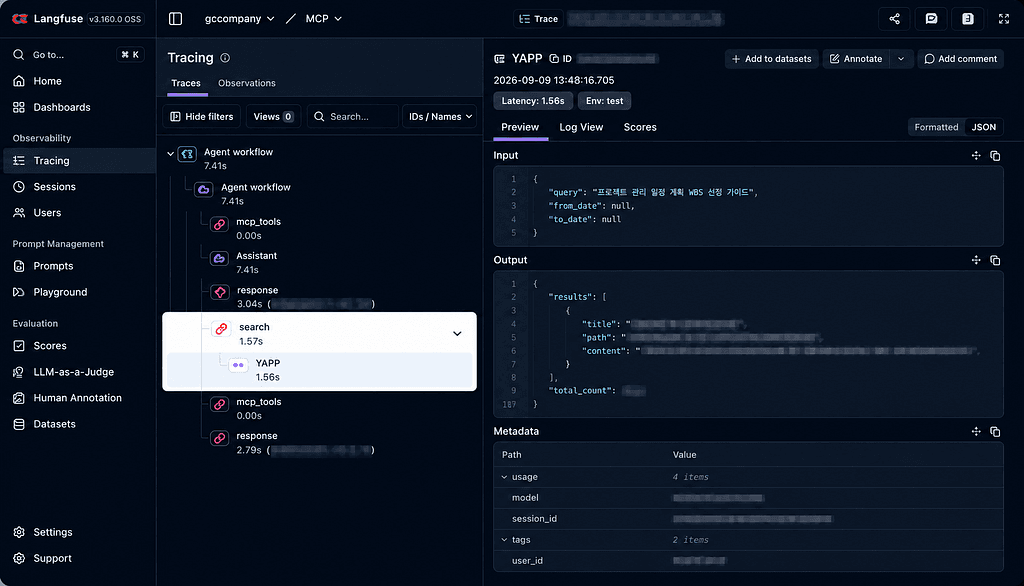
여기어때가 사내 문서 검색을 랭퓨즈로 관측하고 검색 지표와 LLM 채점을 나눠 평가한 사례를 공개했다. MCP 명세와 문서 식별 방식도 개선했다. 내부 평가 결과를 일반 성능으로 확대하지 않고, 변경을 판단할 근거를 만드는 과정에 주목할 만하다.


여기어때가 사내 문서 검색을 랭퓨즈로 관측하고 검색 지표와 LLM 채점을 나눠 평가한 사례를 공개했다. MCP 명세와 문서 식별 방식도 개선했다. 내부 평가 결과를 일반 성능으로 확대하지 않고, 변경을 판단할 근거를 만드는 과정에 주목할 만하다.
영국 AI Security Institute와 EvalEval이 평가 결과를 Evaluation Cards로 공개하는 협력을 소개했다. 다섯 주요 벤치마크의 여섯 모델 결과와 별도 사이버 평가를 다루며 Every Eval Ever 형식으로 맥락·설정을 연결한다. 연계 논문은 추론 자원과 실행 절차에 따라 점수가 달라지므로 동일 예산·조건 비교가 필요하다고 설명한다.