Transformers, GGUF 양자화 실행 경로 추가…애플 실리콘·Qwen3.5부터 지원
허깅페이스가 ggml의 Metal 커널로 압축 가중치를 직접 계산하는 Transformers 실행 경로를 소개했다. 초기 대상은 애플 실리콘과 Qwen3.5 계열이다. 익숙한 Python·PyTorch 인터페이스로 GGUF를 다루지만 커널이 없으면 가중치를 풀어 메모리를 더 쓰고, llama.cpp 비교도 서로 다른 측정 조건을 명시한다.
허깅페이스가 ggml의 Metal 커널로 압축 가중치를 직접 계산하는 Transformers 실행 경로를 소개했다. 초기 대상은 애플 실리콘과 Qwen3.5 계열이다. 익숙한 Python·PyTorch 인터페이스로 GGUF를 다루지만 커널이 없으면 가중치를 풀어 메모리를 더 쓰고, llama.cpp 비교도 서로 다른 측정 조건을 명시한다.
영국 AI Security Institute와 EvalEval이 평가 결과를 Evaluation Cards로 공개하는 협력을 소개했다. 다섯 주요 벤치마크의 여섯 모델 결과와 별도 사이버 평가를 다루며 Every Eval Ever 형식으로 맥락·설정을 연결한다. 연계 논문은 추론 자원과 실행 절차에 따라 점수가 달라지므로 동일 예산·조건 비교가 필요하다고 설명한다.
허깅페이스가 출력과 API를 유지하며 tokenizers의 처리 경로를 바꾼 v1 후보판을 소개했다. Apple M4 Max의 특정 비교에서 인코딩 성능 개선을 보고했지만 Python 호출 비용과 언어·반복도·전체 모델 처리 시간은 다른 조건이다.
IBM 연구진은 같은 과제를 반복할 때 모두 성공한 비율을 평균 성공률과 함께 평가했다. 기록의 불안정한 결정에서 지침을 만들어 다음 실행에 쓰는 방식으로 개선을 보고했지만, 안정적인 판단이 정확한 판단과 같지는 않으며 추가 분석 비용과 적용 범위가 남는다.
허깅페이스가 AUTOMATIC1111의 여러 작업을 Gradio 캔버스 기반으로 재구성한 Workflow1111을 공개했다. 캔버스로 기능이 연결되더라도 호출 단위와 실행 장소, 자원 한도는 개별 설정에 따라 달라진다.
허깅페이스가 학습기와 생성 서버를 분리해 버킷으로 LoRA 어댑터를 공유하는 실험을 공개했다. 작은 가중치 전송과 함께 캐시 및 정책 버전 일치가 요구된다.
H컴퍼니가 텍스트와 이미지 패치를 하나의 양방향 인코더로 처리하는 NeoMME를 공개했다. 작은 검색 모델과 압축 색인으로 문서 검색의 비용을 줄이는 방향이지만, 페이지 인코딩 속도와 검색·답변 전체의 성능은 서로 다른 지표다.
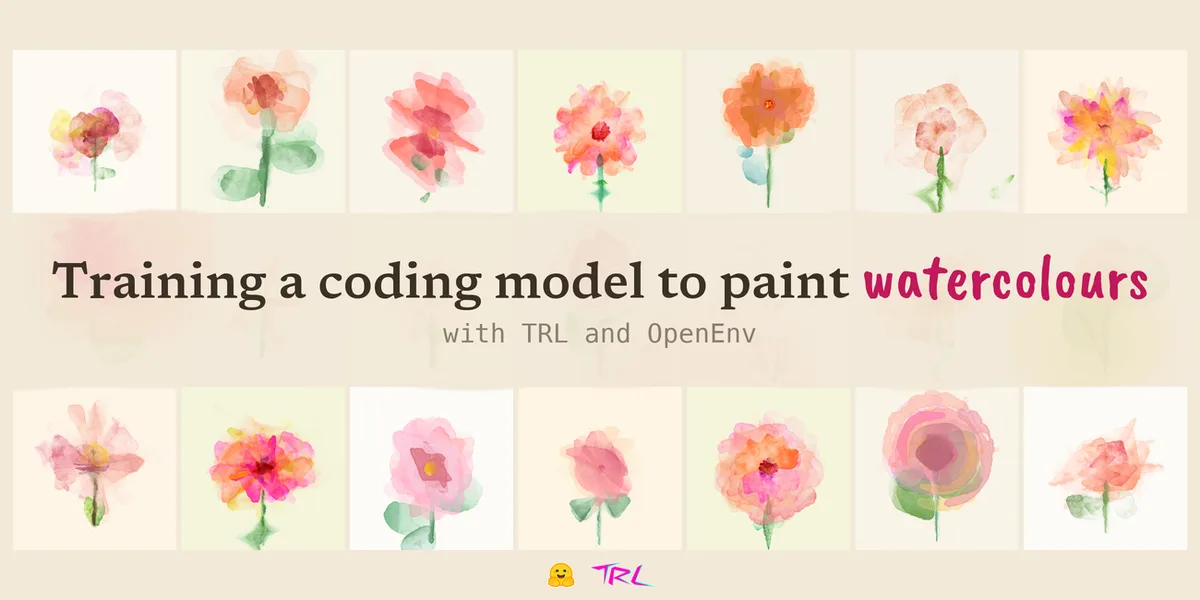
허깅페이스가 TRL과 OpenEnv를 활용해 코딩 모델이 수채화 표현을 생성하도록 학습시킨 실험을 공개했다. 사람이 분류한 178점의 참조 풀과 보상 설계를 비교하며 평가 기준과 재현 한계를 구체화했다.
허깅페이스가 에이전트 세션 기록을 로컬에서 검색 가능한 기억으로 관리하는 도구 funes를 발표했다. 원문과 메타데이터를 유지해 과거 결정을 추적하고 필요할 때 데이터셋으로 공유하는 체계를 제시한다.
허깅페이스가 LFM2.5-350M에 100단계 GRPO 학습을 적용한 공개 실험을 소개했다. 동일한 서빙 환경의 2천 개 시험에서 통과율이 7.1%포인트 늘었다. JSON과 YAML의 차이, 형식 검증과 내용의 정확성을 구분해 결과를 읽는다.