몬스터하우스, 말하는 차고 문의 대화와 목소리·표정을 따로 설계하다
엔비디아의 릭 그랜디가 차고 문에 대답하는 캐릭터를 투사하는 제작 과정을 공개했다. 대화 상태를 관리하고 입을 움직일 깨끗한 음성과 관객이 들을 효과음을 나눈 설계가 핵심이다. 실제 방문객 공연 검증이 남은 시제품에서 자동 생성보다 중요한 연출의 선택을 읽는다.
엔비디아의 릭 그랜디가 차고 문에 대답하는 캐릭터를 투사하는 제작 과정을 공개했다. 대화 상태를 관리하고 입을 움직일 깨끗한 음성과 관객이 들을 효과음을 나눈 설계가 핵심이다. 실제 방문객 공연 검증이 남은 시제품에서 자동 생성보다 중요한 연출의 선택을 읽는다.
엔비디아와 IIT 마드라스 AI4Bharat가 인도 22개 언어의 약 2.8조 토큰 사전학습 자료와 생성 절차를 소개했다. 번역·평가·수정 과정은 공개 도구로 재사용할 수 있지만, 합성 번역이 지역 지식이나 자연어 원문을 대체하지 않으며 데이터 공개 예정과 학습 성과도 구분해야 한다.
허깅페이스가 리플렉션 빔의 가중치와 실행 경로를 소개했다. 총 5,010억 매개변수 중 토큰당 약 230억을 활성화하지만 전체 가중치를 보관할 자원은 필요하다. 100만 토큰 맥락과 여러 정밀도, 공급사 벤치마크를 실제 한국어 업무의 비용·성공률과 구분해 읽는다.
IBM Granite Switch는 공통 모델의 맥락을 재사용하며 대화·판단·위험 탐지와 음성 전사를 연결한다. 10월 소개 뒤 현재 4.1.1 모델 카드는 영어 등 7개 언어의 전사와 문장부호·대문자 출력을 안내한다. 음성 인식과 언어 모델은 분리된 단계이며 버전별 범위를 맞춰 읽어야 한다.
Hugging Face가 FLUX.3 Image Klein의 Diffusers 지원을 공개했다. 단일 모델로 텍스트 생성과 다중 참조 편집, 좌표 기반 요소 배치를 다룬다. 좌표는 위치를 유도할 뿐 주변 픽셀을 잠그지 않으며, 실행 파이프라인 구성과 면책 조건을 함께 살펴야 한다.
메타가 텍스트·이미지·음성·영상을 입력받는 Muse Spark Open 가중치를 공개했다. 총 816B 중 토큰당 약 42B를 활성화하는 구조지만 전체 가중치와 긴 맥락 캐시를 위한 대규모 메모리가 필요하다. 공개 모델 카드의 실행 조건과 이용 규정은 운영 환경에 맞춘 면밀한 배포 판단을 요구한다.
Ai2가 100km 기후 모사와 3km 다운스케일링을 결합한 HiRO-ACEv2를 선보였다. 수치 모델의 극한값 통계를 저비용으로 재현하는 데 초점을 맞추며 바람과 해면기압을 함께 다루지만, 관측 기반 일기예보나 미래 온난화 시나리오에 곧바로 적용할 수 있는 체계는 아니다.
리퀴드 AI가 24B 전체 파라미터와 약 2B 활성 파라미터, 131K 문맥의 LFM2.5-24B-A2B를 공개했다. 활성 연산량과 모델을 담는 저장·메모리 요구는 다르며, 단일 기기의 디코딩 속도와 서버 전체 처리량도 조건을 나눠 비교해야 한다.
Ai2가 연구용 GPU 클러스터에 시간 예산과 계층적 공정 배분, 최소 실행 시간 계약을 도입한 운영 사례를 공개했다. 연구소는 30일 관찰에서 배정해야 할 GPU 시간의 98%를 제공했다고 보고했다. 높은 점유율과 실제 연산 효율의 차이, 중단되는 작업의 복구 비용도 함께 살핀다.
허깅페이스가 자연어 지시로 학습·평가 작업을 수행하는 ML Intern의 여섯 제작 사례를 소개했다. 공개 모델 카드와 공식 문서는 작업별 성과, 비상업 라이선스, 계산 비용의 범위를 보여준다. 쉽게 시작하는 학습 에이전트에서도 기준선과 검증 가능한 산출물이 중요한 이유를 살핀다.
리퀴드 AI가 텍스트 생성을 배제하고 단일 순방향 연산으로 결정을 내리는 오픈 가중치 모델 Open d1 2종을 공개했다. 엣지 기기에서 수십 밀리초 단위 저지연 연산을 지원하지만, 자체 벤치마크 결과 의존도와 입력 사양 제한 등 실무 적용 시 확인할 과제도 명확하다.
아부다비 TII가 16억 매개변수의 Falcon ASR을 소개했다. 아랍어 여섯 시험의 평균 단어 오류율 20.92%와 별도 에미라티 내부 평가를 제시하며 다섯 언어 전사를 지원한다고 밝혔다. 공개 데이터와 내부 시험, 데모 제공과 계획 중인 API를 구분해 읽는다.
엔비디아가 범용 파운데이션 모델 네모트론 3에 사후 훈련과 테스트타임 연산 탐색 파이프라인을 적용해 IOI와 IMO 2026에서 금메달 수준의 성과를 거두었다고 발표했습니다.
아랍에미리트 TII가 현대 표준 아랍어를 넘어 현지 구어체와 문화적 맥락을 반영한 'Falcon-Emirati-7B'와 음성·문서 인식 모델군을 발표했습니다. 하이브리드 아키텍처와 합성 데이터를 활용해 방언 생성 능력을 끌어올렸으나, 방언 충실도 한계와 가중치 공개 조건 등 실무 적용 시 점검해야 할 과제도 상존합니다.
마이크로소프트와 허깅페이스가 백엔드 데이터베이스 상태를 직접 대조하는 씽킹박스 벤치마크를 공개했다. 12만 회가 넘는 테스트 결과, 실제 검증에 실패한 시도 중 67.24%가 도구 호출 오류 없이 정상 응답으로 완료된 것으로 확인됐다.
앨런 인공지능 연구소(Ai2)가 과학 문헌 발췌문을 바탕으로 구조화된 인용 보고서를 신속히 작성하는 오픈 웨이트 모델 'AstaBrief 8B'를 공개했다. 기존 상용 다단계 파이프라인 대비 3.5배 빠른 생성 속도를 보였으나, 외부 벤치마크에서는 인용 정밀도 저하와 의미적 왜곡이라는 기술적 한계가 확인됐다.
ServiceNow CoreAI 연구팀이 엔터프라이즈 환경에서 인공지능 에이전트의 취약점을 분석하고 폐쇄 루프 커리큘럼을 통해 맞춤형 합성 훈련 데이터를 구축하는 프레임워크 'AutoSynthData'를 발표했습니다. 이 파이프라인은 과제 해결 성공률을 유의미하게 끌어올렸으나, 소스코드 공개 여부와 절대 성공률 측면에서 검토해야 할 한계도 안고 있습니다.
허깅페이스가 수주가 걸리던 음성 합성 모델 평가를 수 시간 단위로 단축하는 오픈 TTS 리더보드를 공개했습니다. 명료도, 화자 유사도, 지연 시간을 자동화된 정량 지표로 측정하여 오픈소스 중심의 객관적 벤치마크 환경을 구축했습니다.
NVIDIA가 추가 학습이나 파라미터 튜닝 없이 단일 순전파로 정형 데이터를 예측하는 인컨텍스트 러닝 모델 Kumo Tabular를 공개했습니다. 합성 데이터 기반 사전학습과 3단계 트랜스포머 설계를 접목해 상업적 활용이 가능한 OpenMDW-1.1 라이선스로 제공됩니다.
멀티버스 컴퓨팅 연구팀이 모델 재학습 없이 MCP 기반 에이전트의 출처 교차 혼동을 방어하는 사후 사실성 검증 프레임워크 프로비넌스가드를 공개했습니다. 이 기술은 진술의 참거짓 판별을 넘어 인용 출처 식별자의 일치 여부까지 대조해 결함 주장을 차단합니다.
프랑스 스타트업 H Company가 컴퓨터 화면 제어와 도구 실행을 결합한 에이전트 모델군 Holo4를 발표했다. 오픈 배포와 높은 비용 효율성을 입증했으나, 상업용 라이선스 분리와 복합 장기 과제에서의 성능 저하로 실무 도입 전 면밀한 검토가 필요하다.
허깅페이스가 기존 데이터셋 저장소를 강화학습 환경으로 찾는 필터와 프레임워크 태그를 추가했다. Harbor·Verifiers·OpenEnv·NeMo Gym의 로딩 명령을 표시하지만 태그가 파일 형식을 변환하거나 작업을 실행하지는 않는다. 평가 보상의 의미와 실제 학습 업데이트도 각각 구분해야 한다.
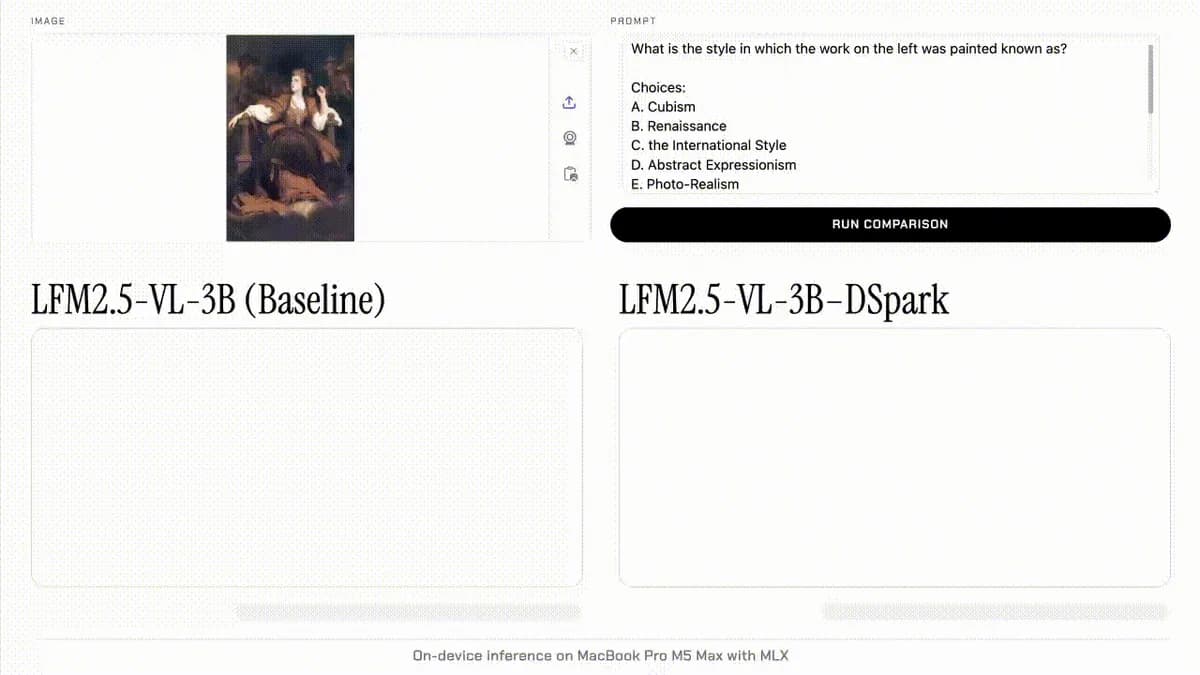
Liquid AI가 LFM2.5-VL-3B 모델을 위한 실험용 DSpark 초안 모델을 공개했다. 약2억8000만 매개변수가 추가되며 본 모델이 후보 토큰을 검증하는 방식이다. 특정 장비의 디코딩은 최대3.13배 빨라졌으나 이미지 처리와 입력 단계는 가속되지 않아 전체 처리 속도와 차이가 있다.
허깅페이스가 oMLX 창시자이자 유지보수 담당자인 Jun Kim의 합류를 발표하며 전담 개발과 재정 지원 계획을 제시했다. oMLX의 Apache 2.0 라이선스와 Jun의 프로젝트 리드는 유지되며, 모델 지원 체계 정비와 서버 개발을 이어갈 예정이다.