주요 뉴스

뉴스

디자인·AI·제품·개발·인테리어의 소식과 ARCH.B 에디토리얼을 함께 읽습니다.

“iF” 검색 결과검색 초기화10편

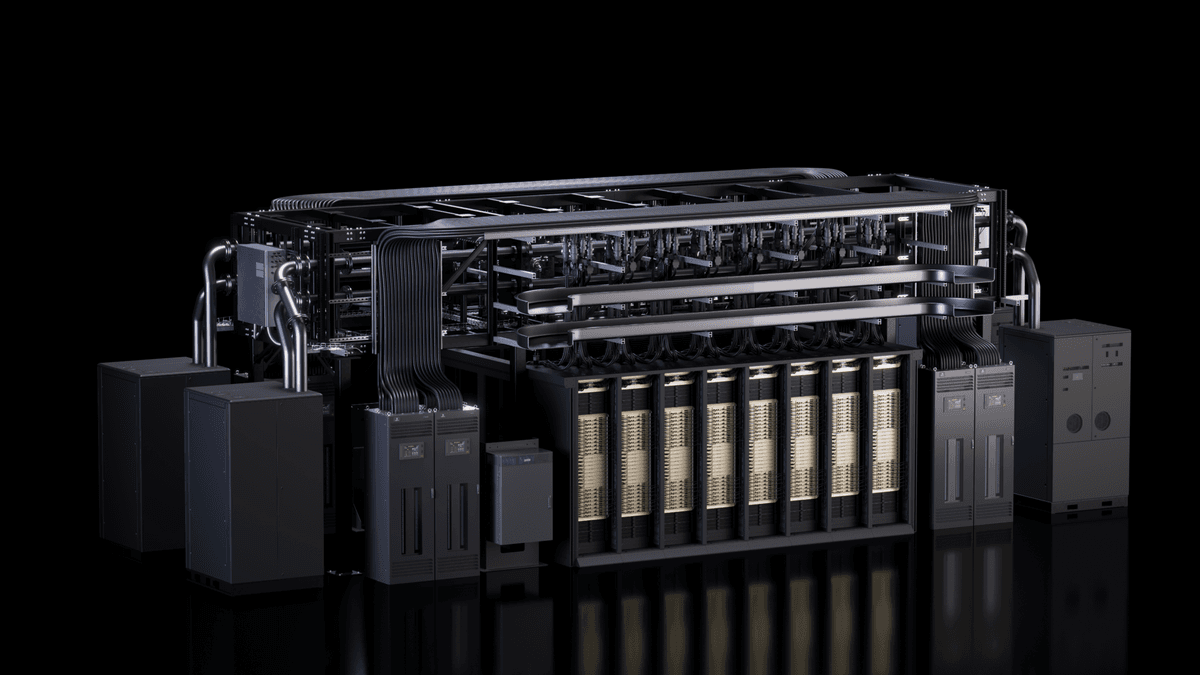
엔비디아, 차세대 '베라 루빈' 랙 설계 OCP 전격 개방… 250kW 초고밀도 AI 팩토리 표준화 시동

엔비디아가 OCP 글로벌 서밋에서 차세대 플래그십 아키텍처 '베라 루빈'의 핵심 랙 및 컴퓨트 트레이 설계를 MGX 오픈 아키텍처를 통해 공개했습니다. 랙당 250kW 전력 밀도를 지원하는 액체 냉각 규격과 독립형 베라 CPU 랙, DSX AI Factory 오픈소스 소프트웨어를 함께 발표하며 생태계 표준화를 추진하지만, 핵심 반도체 종속성과 실제 인프라 공기 등 실무적 검증 과제도 공존합니다.
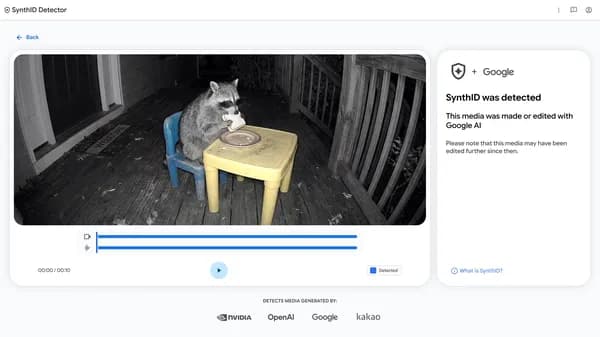
구글, 비가시적 워터마크 탐지 포털 '신스ID 디텍터' 공개… 생태계 확장과 한계

구글 딥마인드가 AI 생성 미디어 판별을 위한 독립형 웹 포털 '신스ID 디텍터'를 일반에 공개했다. 구글 모델뿐 아니라 오픈AI, 엔비디아, 카카오 등의 생성물까지 감지할 수 있도록 파트너십을 확장했으나, 워터마크 미탑재 모델 탐지 불가 등 구조적 한계도 명확하다.

OpenAI, 대화창에 GPT-6 패밀리 및 인텔리전트 UI 배포… 안전성 지표 일부 퇴행 확인

OpenAI가 ChatGPT 일반 대화창에 GPT-6 계열 모델과 동적 시각 컴포넌트를 구성하는 '인텔리전트 UI'의 글로벌 순차 적용을 시작했습니다. 응답 속도는 개선되었으나 공식 시스템 카드에서는 일부 안전성 지표의 퇴행이 확인되어 실무 적용 시 주의가 필요합니다.

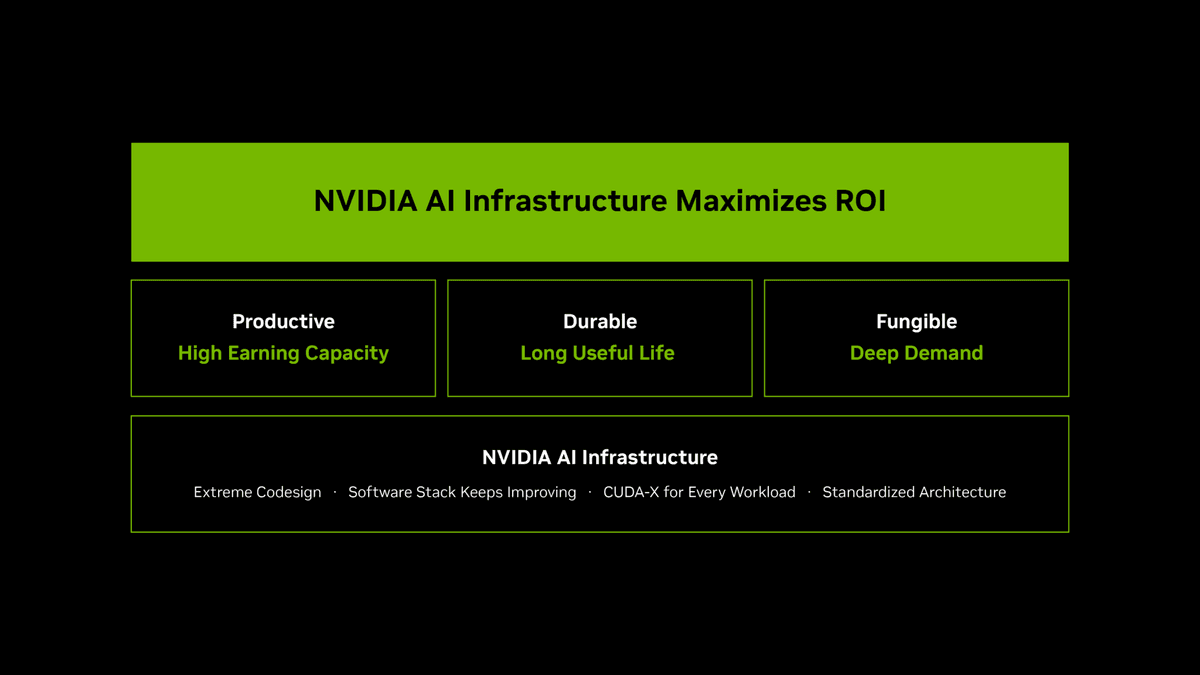
MW당 6,000만 달러 시대, 엔비디아가 제시한 AI 팩토리 ROI 3대 프레임워크와 현실적 한계

엔비디아가 메가와트당 약 6,000만 달러에 달하는 대규모 AI 인프라 투자 회수를 설득하기 위해 '생산성·내구성·범용성' 프레임워크를 발표했습니다. 차세대 시스템의 전력당 처리량 대폭 개선과 구형 A100의 9년 장기 운용 사례를 근거로 내세웠으나, 실제 인프라 현장에서는 특정 벤치마크 한계, 데이터센터 전력·냉각 제약, 금융권 담보 인정 격차 등 엄격한 조건들이 공존합니다.

내용만 맞으면 끝일까… MCP 에이전트의 출처 왜곡 잡는 검증 계층 등장

멀티버스 컴퓨팅 연구팀이 모델 컨텍스트 프로토콜(MCP) 기반 LLM 에이전트의 '출처 교차 혼동' 문제를 해결하기 위한 사후 사실성 검증 프레임워크 '프로비넌스가드(ProvenanceGuard)'를 공개했습니다. 이 기술은 에이전트 재학습 없이도 생성된 답변의 세부 주장을 개별 도구 출력과 대조해 잘못된 인용을 차단합니다.

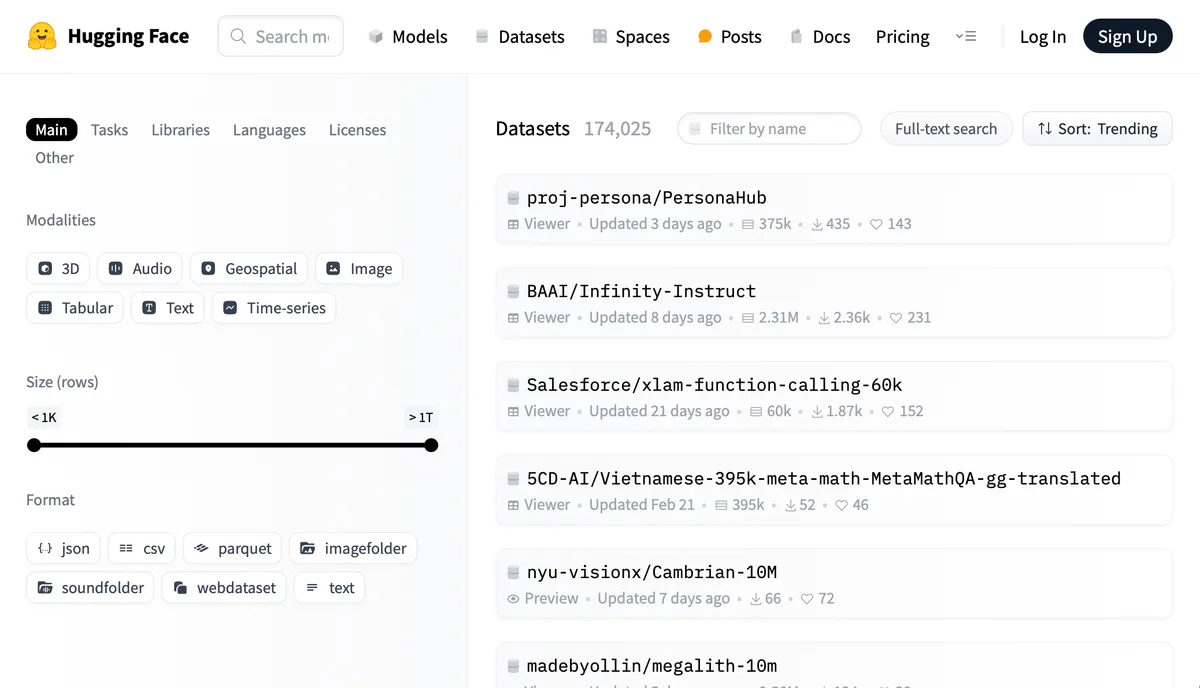
허깅페이스, Hub에 강화학습 환경 필터 추가…데이터 공개와 실행은 별도

허깅페이스가 기존 데이터셋 저장소를 강화학습 환경으로 찾는 필터와 프레임워크 태그를 추가했다. Harbor·Verifiers·OpenEnv·NeMo Gym의 로딩 명령을 표시하지만 태그가 파일 형식을 변환하거나 작업을 실행하지는 않는다. 평가 보상의 의미와 실제 학습 업데이트도 각각 구분해야 한다.

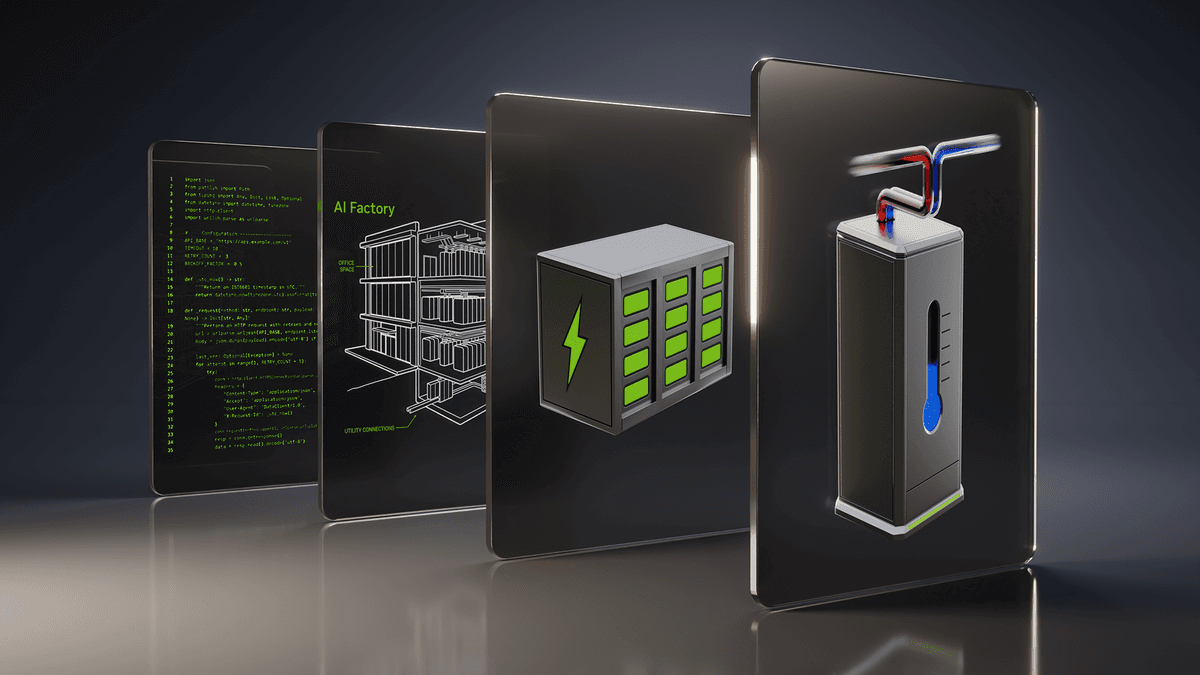
엔비디아 DSX Ready, 전력·냉각 제품 적합성 절차 공개…현장 전체 인증과 구분

엔비디아가 AI 팩토리의 전력·냉각 제품을 DSX 요구 사항에 맞춰 평가하는 DSX Ready를 발표했다. 출시 때의 대상은 배터리 에너지 저장 시스템과 냉각 분배 장치다. 특정 제품의 적합성 평가이며 업체 전체나 설치 현장의 안정성·안전 인증을 대신하지 않는다. 현재 안내의 냉각액 범주와 초기 발표도 구분했다.

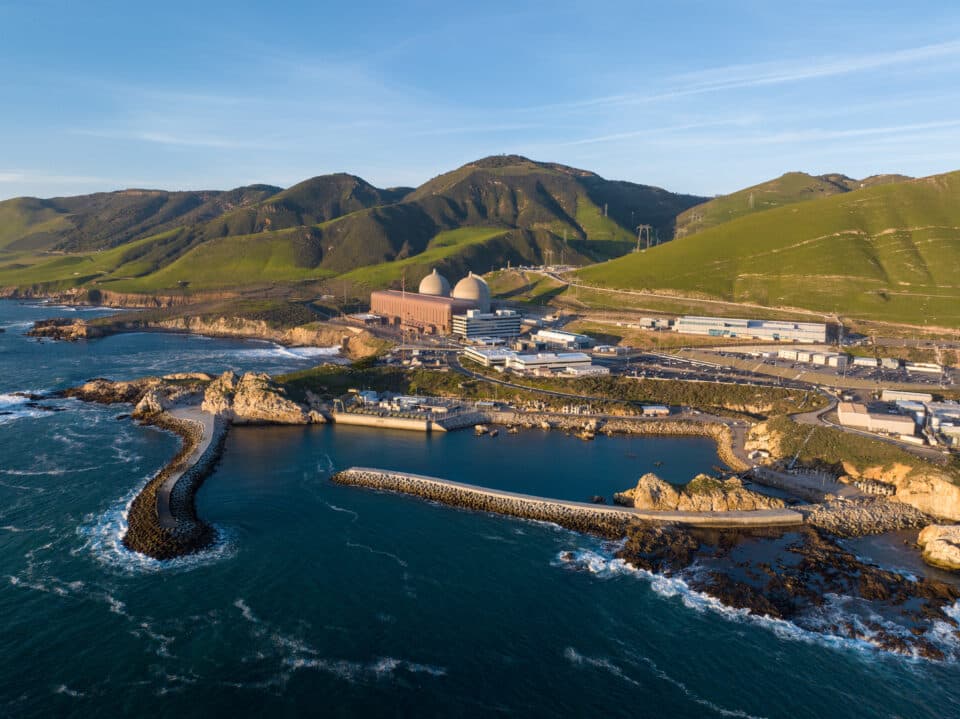
엔비디아, 청정에너지 AI 활용 5개사 소개…문서 검색·설계 시연·전력 저장 구분

엔비디아가 뉴욕 기후 주간을 맞아 전력망, 원자력 문서, 배터리 저장, 원전 설계, 핵융합 실험에 AI를 연결하는 다섯 회사를 소개했다. 각 회사의 공식 발표를 대조하면 제공 중인 지식 보조 도구와 개발·시연 단계의 설계 플랫폼이 섞여 있다. 설계 시간 비교를 발전소 건설 기간으로 옮기거나 저장용 배터리를 자체 발전으로 해석할 수 없다.

350M 모델의 구조화 출력 학습, IFStruct 통과율 22.6%→29.7%

허깅페이스가 LFM2.5-350M에 100단계 GRPO 학습을 적용한 공개 실험을 소개했다. 동일한 서빙 환경의 2천 개 시험에서 통과율이 7.1%포인트 늘었다. JSON과 YAML의 차이, 형식 검증과 내용의 정확성을 구분해 결과를 읽는다.