여기어때, 라이트RAG와 문서 계층 탐색으로 사내 검색 보완
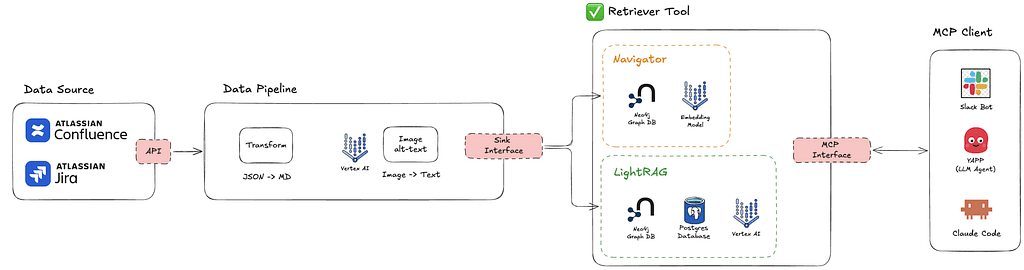
여기어때가 의미 검색을 담당하는 라이트RAG와 원본 문서 계층을 따라가는 Navigator를 결합한 사례를 공개했다. 동일 제목의 문서 구분, 비동기 적재 점검, 대규모 재임베딩 대응이 핵심이다. 내부 개선 수치는 해당 데이터와 평가 조건에서 해석해야 한다.


여기어때가 의미 검색을 담당하는 라이트RAG와 원본 문서 계층을 따라가는 Navigator를 결합한 사례를 공개했다. 동일 제목의 문서 구분, 비동기 적재 점검, 대규모 재임베딩 대응이 핵심이다. 내부 개선 수치는 해당 데이터와 평가 조건에서 해석해야 한다.
클라우드플레어가 DNS 주소 1.1.1.1을 기념해 추진한 대규모 인턴십 프로그램의 1년 경과를 공개했습니다. 9개 글로벌 오피스에서 750명을 수용하며 캐시 압축, CMS 개편, 네트워크 라우팅 연구 등 실무 기여를 발표했으나, 목표 달성률과 기술적 한계에 대한 냉정한 평가도 필요합니다.
구글의 10월 DevTools 정리는 Chrome 153·154에 도입된 광고 추적과 소프트 탐색 분석, MCP 실행 제어를 소개한다. 광고 지표는 Core Web Vitals와 별개이며, 에이전트의 스크립트 평가를 제한하는 설정도 추가됐다. 측정 대상과 실행 권한을 나눠 디버깅할 수 있는 변화다.
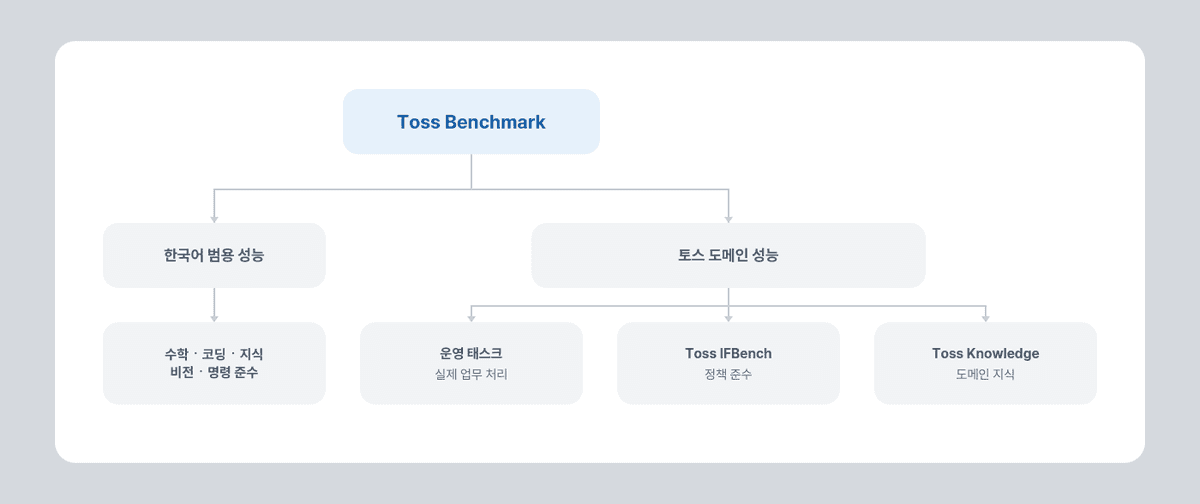
비바리퍼블리카(토스)가 공개 글로벌 리더보드 점수와 현업 환경 간의 괴리를 해소하기 위해 자체 LLM 평가 체계 'Toss Benchmark'를 구축했습니다. 평가 언어와 추론(Reasoning) 설정에 따른 극심한 순위 역전을 검증하고, 지시 준수 및 도메인 지식 지표를 바탕으로 사내 모델 서빙 기준을 정립했습니다.
제품 디자이너 캣 호먼은 정신건강 앱에서 시각적 새로움보다 인지 부담·감정적 맥락·예측 가능한 탐색을 살펴야 한다고 제안했다. 실제 사용 연구와 접근성 기준을 대조하면, 이용 지속과 치료 효과를 구분하고 디자인 사례의 효용을 제한된 근거 안에서 읽어야 한다.
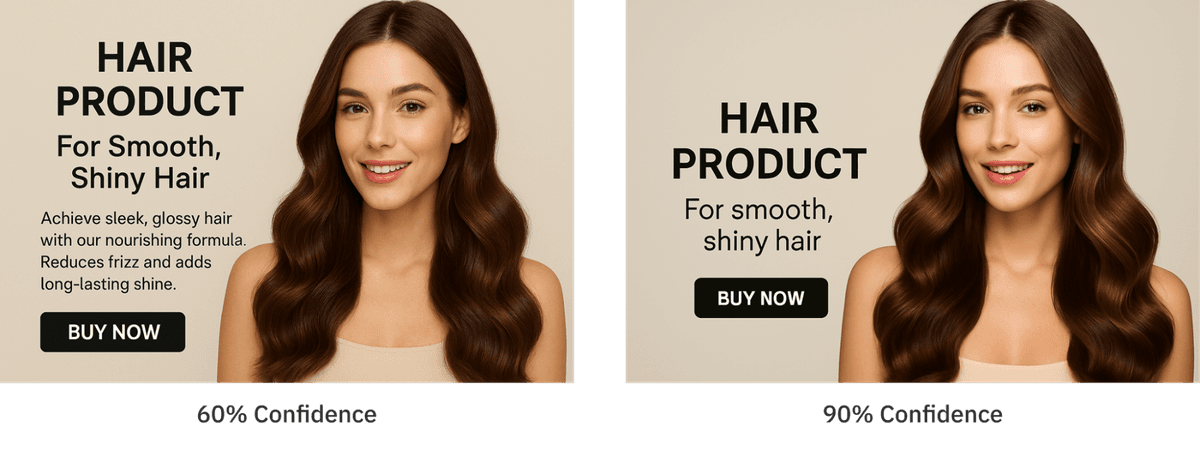
프라틱 조글레카는 AI 예측을 확정된 답으로 다루지 않고 가설·실험·수정으로 연결하는 설계를 제안했다. 언어모델 자기 평가 연구를 함께 살펴보면, 모델이 적은 신뢰도와 실제 정답률의 관계를 확인해야 하며 설명·검토·복구 경로가 수치만큼 중요하다.