열 수 있는 기기에서 다시 쓰는 경로까지, 구글의 픽셀 수리 설계
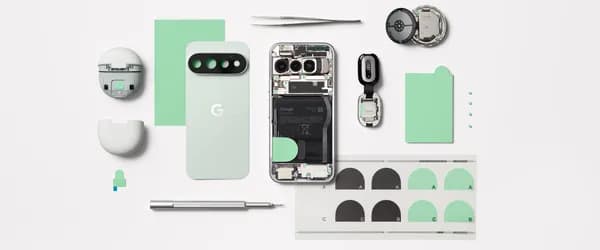
구글이 세계 수리의 날을 맞아 모듈 구조와 수리 접수, 공식 리퍼비시 확대를 소개했다. 픽셀 워치4의 분해 평가를 직접 대조하면 구조적 접근성뿐 아니라 부품 가격과 안내·서비스 경로가 기기를 오래 쓰는 조건임을 알 수 있다.


구글이 세계 수리의 날을 맞아 모듈 구조와 수리 접수, 공식 리퍼비시 확대를 소개했다. 픽셀 워치4의 분해 평가를 직접 대조하면 구조적 접근성뿐 아니라 부품 가격과 안내·서비스 경로가 기기를 오래 쓰는 조건임을 알 수 있다.
OpenAI가 무료 학습 플랫폼의 교사 대상 AI 과정에 브라질 포르투갈어를 추가했다. 수업 준비와 평가에 도구를 쓰되 교사의 교육적 판단을 유지하는 방향이다. 함께 소개한 학습 모드는 단계별 질문을 돕는 기존 기능으로, 이번에 새로 출시된 것은 아니다.
구글이 Gemini 4 Argon을 공개하며 복잡한 소프트웨어 작업과 과학 연구 사례를 제시했다. 모델은 입력과 출력을 합친 최대 1M 토큰 맥락을 사용한다. ADK 최적화는 특정 프레임워크 구간의 측정이며 사람의 검토를 거쳤고, 핵융합 관련 사례는 평형 해석해 연구다. 성과의 범위와 모델 카드의 한계를 함께 살핀다.
메타와 Yuvaa가 공동 기획한 인도 Edits 영화제가 200편 넘는 응모작에서 공식 선정작 12편을 발표했다. 일상의 영상을 Edits 앱으로 재구성하는 공모는 이야기의 독창성과 편집을 통한 변화, 앱 기능의 창의적 사용을 함께 평가한다.
Design Milk의 협찬 기사는 iF 수상이 온라인 주목보다 오래가는 인정이라고 강조한다. 공식 2027 참가 문서는 최종 마감을 11월 4일로 안내하며 등록·심사·수상 단계의 비용과 제출 자료를 구분한다. 수상 홍보를 프로젝트의 판단 근거와 함께 읽는다.
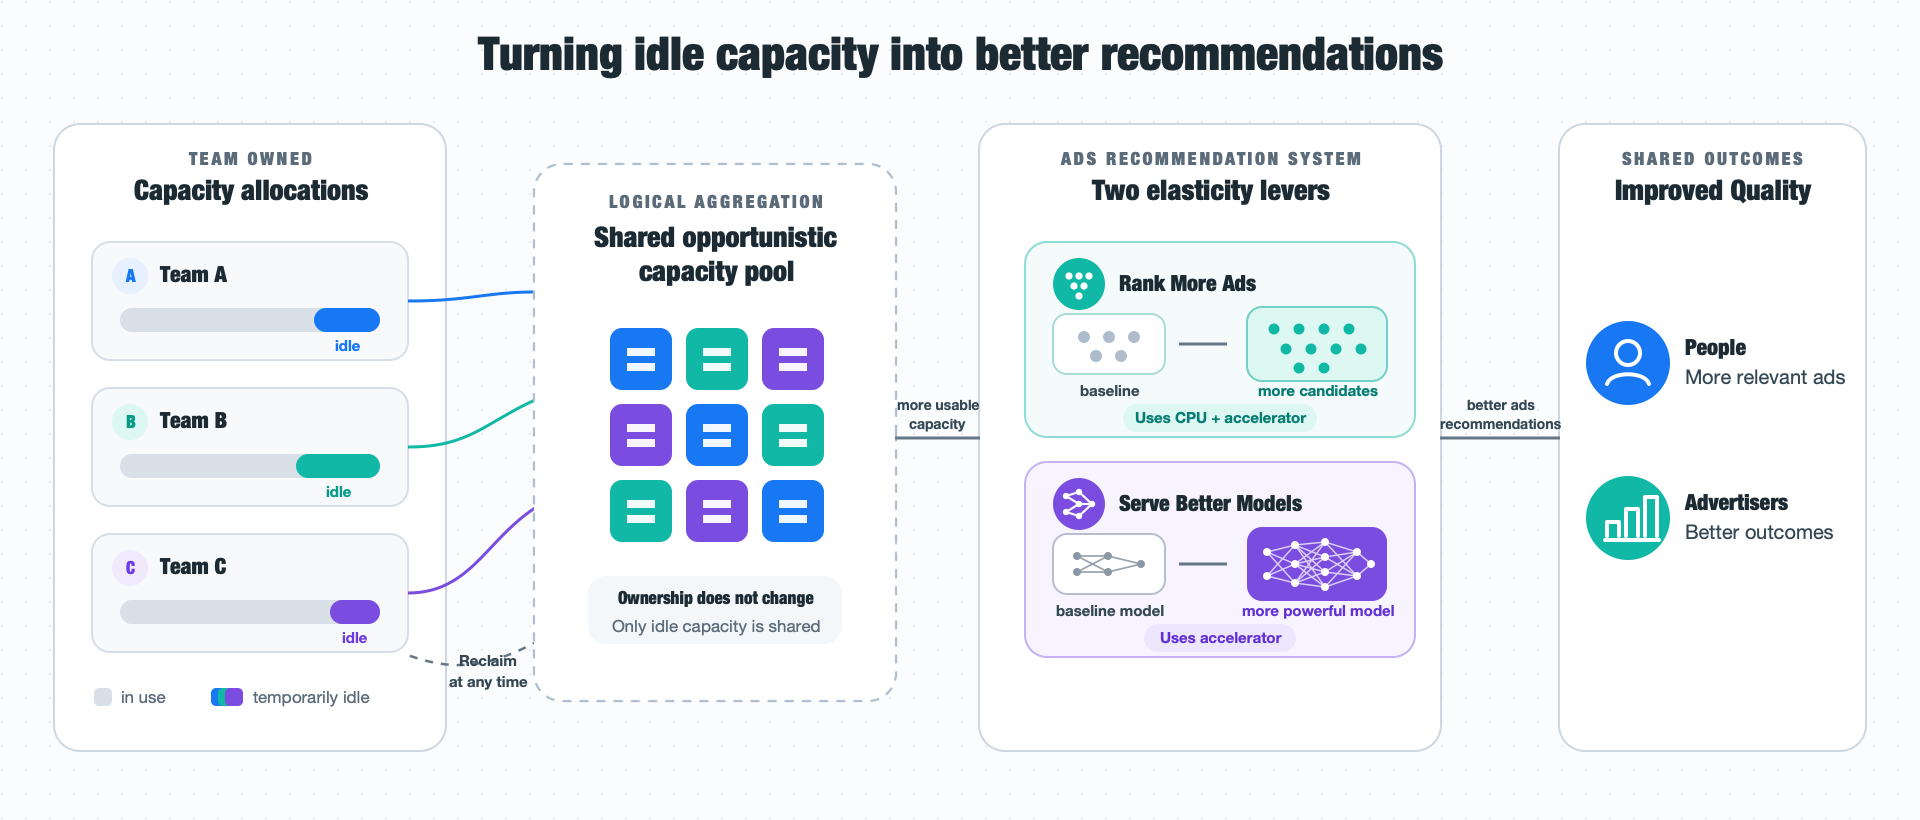
메타가 회수 가능한 유휴 추론 자원을 광고 추천에 활용하는 구조를 공개했다. RMA는 평가 후보 수를, SBM은 더 강력한 모델로 보내는 요청 비율을 조절한다. 자원이 줄면 추가 작업을 덜어내 기본 서비스에 부담이 넘어가지 않게 설계했다. 자원 구성·부하 분산·모델 계산·배분 정책이 함께 작동하며 결과를 단일 모델 효과로 볼 수는 없다.
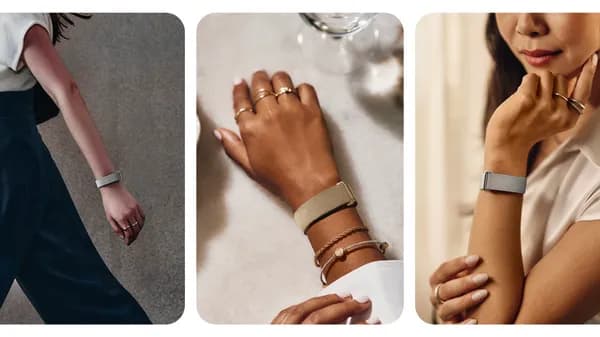
구글이 10월 중 Fitbit Air·Edge와 Pixel Watch 3~5의 운동 자동 감지 확대를 예고했다. 감지 개선 수치는 수동 기록 운동으로 이전 모델과 비교한 오프라인 평가다. Premium의 Health Guardian은 월간 추세 정보이며 실시간 임상 측정과 다르다. 앱 연동은 서비스별 지역·구독·시점이 다르며 Air Metal Mesh 밴드도 예약 판매한다.
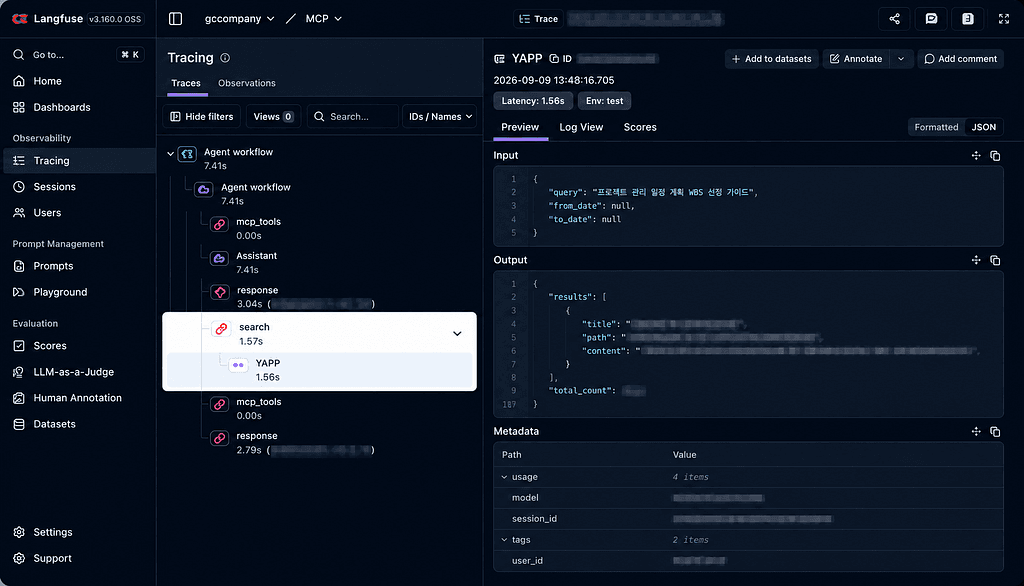
여기어때가 사내 문서 검색을 랭퓨즈로 관측하고 검색 지표와 LLM 채점을 나눠 평가한 사례를 공개했다. MCP 명세와 문서 식별 방식도 개선했다. 내부 평가 결과를 일반 성능으로 확대하지 않고, 변경을 판단할 근거를 만드는 과정에 주목할 만하다.
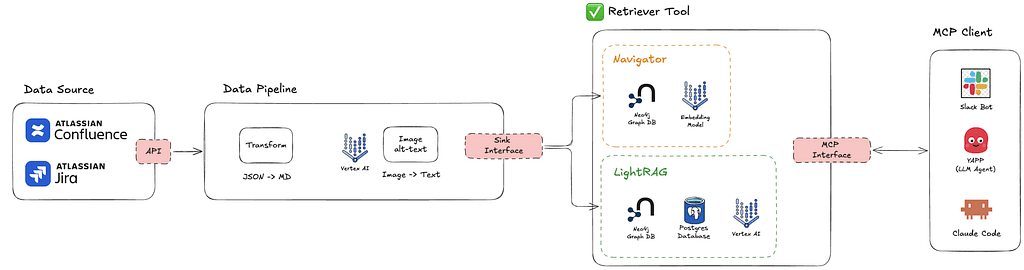
여기어때가 의미 검색을 담당하는 라이트RAG와 원본 문서 계층을 따라가는 Navigator를 결합한 사례를 공개했다. 동일 제목의 문서 구분, 비동기 적재 점검, 대규모 재임베딩 대응이 핵심이다. 내부 개선 수치는 해당 데이터와 평가 조건에서 해석해야 한다.
허깅페이스가 자연어 지시로 학습·평가 작업을 수행하는 ML Intern의 여섯 제작 사례를 소개했다. 공개 모델 카드와 공식 문서는 작업별 성과, 비상업 라이선스, 계산 비용의 범위를 보여준다. 쉽게 시작하는 학습 에이전트에서도 기준선과 검증 가능한 산출물이 중요한 이유를 살핀다.
아부다비 TII가 16억 매개변수의 Falcon ASR을 소개했다. 아랍어 여섯 시험의 평균 단어 오류율 20.92%와 별도 에미라티 내부 평가를 제시하며 다섯 언어 전사를 지원한다고 밝혔다. 공개 데이터와 내부 시험, 데모 제공과 계획 중인 API를 구분해 읽는다.
메타가 플랫폼 내 유료 광고를 통해 외부 불법 아동 성착취물로 유도하는 수법을 막기 위해 대규모 언어 모델과 레드팀 AI 에이전트를 도입했습니다. 표면적으로 무해해 보이는 광고 문구와 외부 연결 목적지를 함께 분석하는 체계로의 전환이지만, 글로벌 규제 당국의 압박과 탐사보도가 계기가 되었다는 평가가 나옵니다.
OpenAI가 아직 출시하지 않은 내부 프론티어 모델을 활용해 수학 미해결 문제들을 탐색하고, 총 372개 문제군에 걸친 722편의 논문 초안과 린(Lean 4) 검증 코드를 깃허브에 공개했습니다. 전통적인 학술 동료 평가 체계를 거치지 않고 대규모 결과물을 일괄 배포함에 따라 학계에서는 연산 능력에 대한 주목과 연구 재현성 한계를 둘러싼 비판이 동시에 제기되고 있습니다.
말레이시아 Universiti Putra의 교수가 데이터 마이닝 평가를 코드 작성 시험에서 선택을 설명하는 구두 면담으로 바꾼 경험을 공개했다. 학생은 Colab의 Gemini 제안을 검토하고 모델링 결정을 정당화한다. 교수의 평가 방식과 제품 기능, 학습 효과의 근거를 구분해 읽는다.
클라우드플레어가 DNS 주소 1.1.1.1을 기념해 추진한 대규모 인턴십 프로그램의 1년 경과를 공개했습니다. 9개 글로벌 오피스에서 750명을 수용하며 캐시 압축, CMS 개편, 네트워크 라우팅 연구 등 실무 기여를 발표했으나, 목표 달성률과 기술적 한계에 대한 냉정한 평가도 필요합니다.
OpenAI가 Chatham Financial의 Codex·GPT 활용 사례를 공개했다. 거래 증거를 모아 조건을 비교하는 앱의 초기 검토 시간이 약 30분에서 4분 미만으로 줄었다는 회사 평가다. 전문가와 실제 거래를 대조 중인 단계이며, 모델 단독 성능과 업무 재설계의 효과를 구분한다.
클라우드플레어가 선택지별 확률을 반환하는 Clef와 Clef-flash를 Workers AI 및 공개 가중치로 제공한다. 자유로운 문장 생성 대신 정해진 스키마의 판단을 수행하며 맞춤 학습은 엔지니어와 함께 지원한다. 자체 평가의 속도·품질 차이와 향후 셀프서비스 학습 계획을 구분해 살펴본다.
덴버 가족 소셜클럽 더덴은 ChatGPT Work로 자료를 모으고 지원금·주류 면허 신청 준비를 돕는다고 설명했다. 경영진의 주당 10~15시간 절감은 고객 사례의 자체 평가다. 기관의 심사 기간이나 사업 수익 개선을 측정한 결과는 아니다.
OpenAI가 7월 관찰한 조직적 모델 추론 추출 활동을 9월 30일 공개했다. 요청 수는 성공한 추출 건수가 아니며 문샷AI 관련 인물에 대한 귀속은 회사의 평가다. 연구 논문을 대조하면 암호화된 추론의 세션 간 재사용과 공개 로그 관리가 별도 보안 과제로 드러난다.
삼성전자가 KCSI에서 25년 연속 최다 부문 1위를 발표했다. 보도자료는 가전·IT 9부문을 소개하지만 평가기관 보고서는 간편결제서비스를 더해 10개 산업으로 집계한다. 만족도 조사의 범위와 측정 모델을 보면 순위만으로 AI 기능의 효과를 단독 판정할 수는 없다.
허깅페이스가 수주가 걸리던 음성 합성(TTS) 모델 평가를 수 시간 단위로 단축하는 '오픈 TTS 리더보드'를 공개했습니다. 명료도(WER), 화자 유사도, 실시간 지연 시간(TTFA) 등 자동화된 정량 지표를 바탕으로 오픈소스 모델 중심의 객관적 벤치마크 환경을 구축했습니다.
OpenAI가 GPT-6.1 Sol을 발표하며 코딩·업무 평가의 개선과 Astra보다 낮은 표준 단가를 제시했다. 다만 과제별 비용과 벤치마크 조건은 다르고 사실성 평가는 오류를 유발한 어려운 대화로 구성된다. API 문서의 긴 입력·캐시·속도 모드 요금을 함께 확인했다.
OpenAI가 프론티어 강화학습 실행에 앞서 위험과 통제 근거를 구조적으로 제시하는 안전 논증 방향을 공개했다. 학습 평가·환경 격리·감시뿐 아니라 반대 검토, 중단 절차와 사고 조사를 포함한다. 현재 구현 중인 권고이며 외부 인증이나 모든 배포 상황의 안전 입증은 아니다.
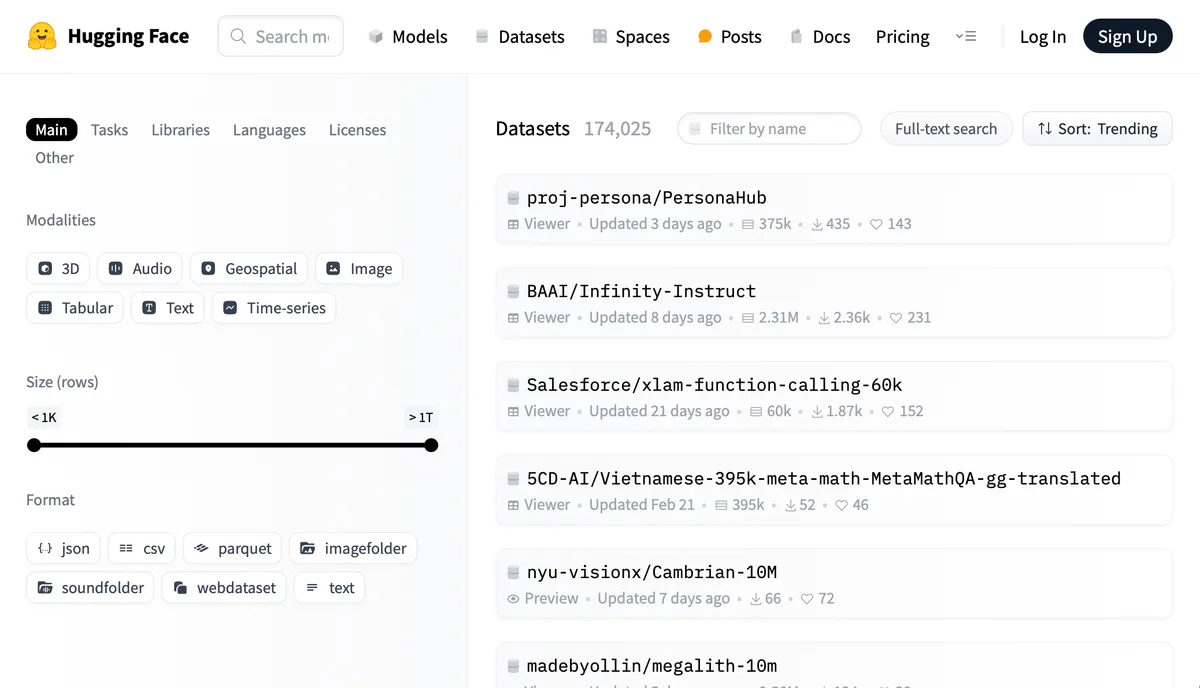
허깅페이스가 기존 데이터셋 저장소를 강화학습 환경으로 찾는 필터와 프레임워크 태그를 추가했다. Harbor·Verifiers·OpenEnv·NeMo Gym의 로딩 명령을 표시하지만 태그가 파일 형식을 변환하거나 작업을 실행하지는 않는다. 평가 보상의 의미와 실제 학습 업데이트도 각각 구분해야 한다.