리퀴드 AI, 온디바이스 에이전트 특화 MoE 모델 'LFM2.5-24B-A2B' 공개
리퀴드 AI가 240억 개 파라미터 중 24.5억 개만 활성화하는 하이브리드 MoE 구조의 LFM2.5-24B-A2B를 오픈 웨이트로 공개했습니다. 131K 컨텍스트와 도구 조작에 특화되어 엣지 기기에서 빠른 추론 속도를 보이지만, 온디바이스 적재를 위한 메모리 하한선과 지식 집약 과제의 한계도 명확합니다.


리퀴드 AI가 240억 개 파라미터 중 24.5억 개만 활성화하는 하이브리드 MoE 구조의 LFM2.5-24B-A2B를 오픈 웨이트로 공개했습니다. 131K 컨텍스트와 도구 조작에 특화되어 엣지 기기에서 빠른 추론 속도를 보이지만, 온디바이스 적재를 위한 메모리 하한선과 지식 집약 과제의 한계도 명확합니다.
Meta가 장기 작업 처리 역량을 강화한 프런티어 에이전트 모델 'Muse Wonder'와 'Muse Wonder Full'을 발표했다. 과거 Llama의 오픈 가중치 정책을 버리고 독점 API 및 자사 구독 소프트웨어 중심의 상용 모델 체제로 전환했으며, 최상위 모델은 API에서 배제해 자사 유료 도구 가입을 유도하는 사업적 락인 전략을 구체화했다.
엔비디아가 OCP 글로벌 서밋에서 차세대 플래그십 아키텍처 '베라 루빈'의 핵심 랙 및 컴퓨트 트레이 설계를 MGX 오픈 아키텍처를 통해 공개했습니다. 랙당 250kW 전력 밀도를 지원하는 액체 냉각 규격과 독립형 베라 CPU 랙, DSX AI Factory 오픈소스 소프트웨어를 함께 발표하며 생태계 표준화를 추진하지만, 핵심 반도체 종속성과 실제 인프라 공기 등 실무적 검증 과제도 공존합니다.
Deno 팀 전체가 클라우드플레어에 합류해 Workers와 Durable Objects의 자체 운영을 단순화한다. Deno 런타임은 1년간 수정·보안 업데이트를 제공하고 Deploy는 6개월 뒤 종료할 예정이다. 기존 사용자에게 필요한 이전 판단과 공개 런타임 통합의 의미를 살펴본다.
깃허브에서 triage 이상의 저장소 역할이 PR을 보관하거나 복구할 수 있게 됐다. 보관된 PR은 공개 화면에서 숨겨지고 새 댓글·반응·자동 댓글이 차단된다. 보관을 해제해도 PR은 닫힌 상태를 유지한다. 권한 위임과 검토 기록 관리에 생기는 변화를 살펴본다.
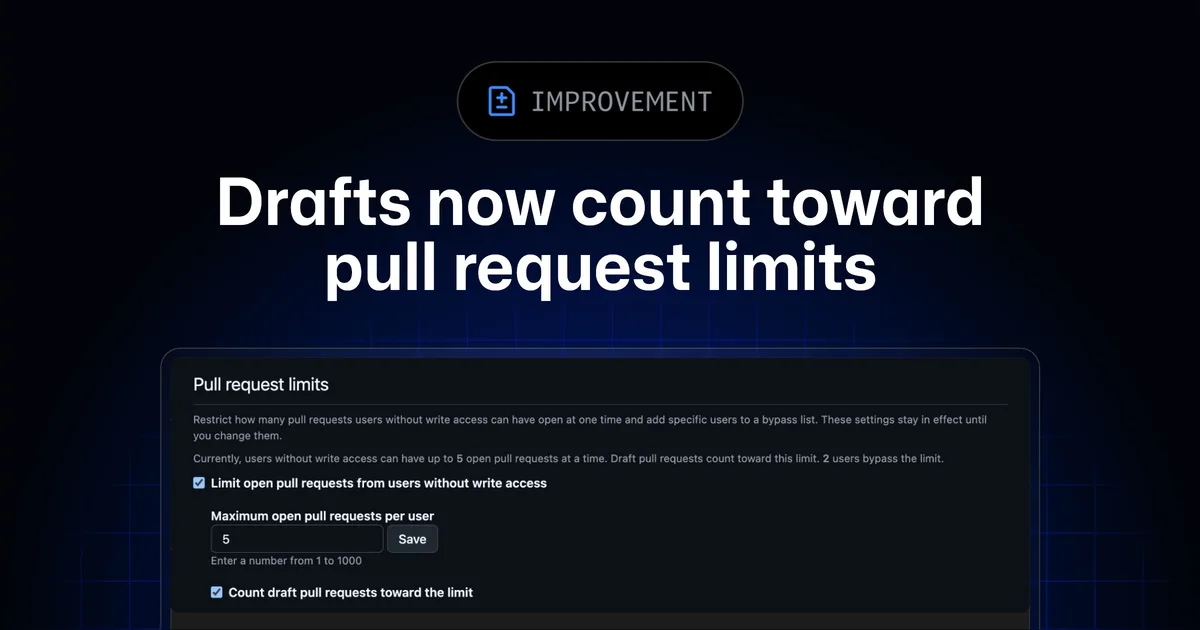
깃허브가 사용자별 동시 풀 리퀘스트 제한에 초안을 포함하는 설정을 추가했다. 초안 상태로 요청을 계속 생성하던 우회 경로를 줄이려는 변경이다. 공개 저장소의 외부 기여자에게 적용되는 기존 제한과 예외 목록을 바탕으로 운영상 의미를 살펴본다.
리퀴드 AI가 텍스트 생성을 배제하고 단일 연산으로 분류·판단을 수행하는 오픈 가중치 의사결정 모델 ‘Open d1’ 2종을 허깅페이스를 통해 공개했다. 엣지 기기에서 수십 밀리초 단위의 저지연 처리를 목표로 설계되었으나, 작업 범위 제한과 벤치마크 검증 등의 과제도 남아 있다.
엔비디아가 범용 파운데이션 모델인 네모트론 3를 기반으로 정밀한 사후 훈련과 테스트타임 연산 파이프라인을 결합해 2026년 국제정보올림피아드(IOI)와 국제수학올림피아드(IMO)에서 모두 금메달 수준의 성과를 거두었다고 발표했습니다. 연구팀은 전용 모델을 새로 구축하는 대신 재사용 가능한 전문화 방법론을 입증하고 핵심 가중치와 코드를 오픈소스로 공개했습니다.
메타가 퍼블릭 시간 서비스에 RFC 8915 표준 네트워크 시간 보안(NTS)을 공식 적용하고 서버·클라이언트 구현체를 오픈소스로 공개했습니다. TLS 유효기간 단축 규제와 맞물려 시간 동기화의 암호학적 검증이 인프라 필수 요건으로 떠오르고 있습니다.
구글이 텍스트·시각·음성을 768차원 단일 벡터 공간으로 결합한 오픈 웨이트 모델 ‘임베딩젬마 2’를 공개했습니다. 740M 모듈형 아키텍처와 컨텍스트 확장으로 온디바이스 검색 효율을 끌어올렸으나, 정밀도 제약과 벤치마크 해석을 둘러싼 실무적 점검 사항도 확인됩니다.
글로벌 통신사들이 고비용 폐쇄형 인공지능(AI) 의존을 낮추고 통제권과 맞춤형 역량을 확보하기 위해 오픈 모델 도입을 확대하고 있다. 엔비디아의 연례 조사에 따르면 설문 참여 통신사의 89%가 오픈소스 모델과 소프트웨어를 전략적 핵심으로 지목했으며, 300억 매개변수 규모의 통신 특화 모델 등이 현업 실증 단계에 진입했다.
클라우드플레어가 창립 16주년을 맞아 에이전트 트래픽 수용, 머클 트리 기반 양자내성 인증기관(CA) 진출, 오픈소스 개발 생태계 및 데이터 플랫폼 확장을 골자로 하는 46개 발표 항목을 공개했습니다.
GitHub이 npm 단계별 배포(Staged Publishing) 기능을 개선해 사전 수동 배포 절차 없이도 신규 패키지를 직접 생성할 수 있도록 지원합니다. 자동화 파이프라인에서 생성된 첫 버전은 대기열에 진입하며 관리자의 승인을 거쳐 최종 공개됩니다.
클라우드플레어가 Workers, Containers, Durable Objects를 결합해 장시간 비디오 처리 파이프라인을 구축할 수 있는 오픈소스 프로젝트 '스트림라인(Streamline)'을 발표했습니다. 실시간 자막 번인과 동적 그래픽 합성을 지원하지만, 완전 관리형 서비스가 아닌 개발자가 직접 컨테이너를 운용해야 하는 참조 구현체 단계입니다.
앨런 인공지능 연구소(Ai2)가 과학 문헌 발췌문을 바탕으로 구조화된 인용 보고서를 신속히 작성하는 오픈 웨이트 모델 'AstaBrief 8B'를 공개했다. 기존 상용 다단계 파이프라인 대비 3.5배 빠른 생성 속도를 보였으나, 외부 벤치마크에서는 인용 정밀도 저하와 의미적 왜곡이라는 기술적 한계가 확인됐다.
클라우드플레어가 선택지별 확률을 반환하는 Clef와 Clef-flash를 Workers AI 및 공개 가중치로 제공한다. 자유로운 문장 생성 대신 정해진 스키마의 판단을 수행하며 맞춤 학습은 엔지니어와 함께 지원한다. 자체 평가의 속도·품질 차이와 향후 셀프서비스 학습 계획을 구분해 살펴본다.
클라우드플레어가 조직의 에이전트 작업공간 Cloudflare OS를 대신 배포·관리하는 서비스를 예고하고 대기 명단을 열었다. 기존 공개 코드는 직접 배포할 수 있다. GitHub와 Google Workspace 연결, 문서 내보내기 및 외부 변경 승인 구조가 조직 업무에 주는 의미를 살펴본다.
허깅페이스가 수주가 걸리던 음성 합성(TTS) 모델 평가를 수 시간 단위로 단축하는 '오픈 TTS 리더보드'를 공개했습니다. 명료도(WER), 화자 유사도, 실시간 지연 시간(TTFA) 등 자동화된 정량 지표를 바탕으로 오픈소스 모델 중심의 객관적 벤치마크 환경을 구축했습니다.
NVIDIA가 추가 학습이나 파라미터 튜닝 없이 단일 순전파로 정형 데이터를 예측하는 인컨텍스트 러닝 모델 'Kumo Tabular'를 공개했습니다. 합성 데이터 기반 사전학습과 3단계 트랜스포머 설계를 접목해 상업적 활용이 가능한 OpenMDW-1.1 라이선스로 제공됩니다.
프랑스 AI 스타트업 H Company가 데스크톱 GUI, 웹, 모바일, API 도구 호출을 아우르는 컴퓨터 조작 에이전트 모델군 'Holo4'를 공개했다. 뛰어난 가성비와 오픈 웨이트 배포로 주목받고 있으나, 상업용 라이선스 분리와 복합 업무에서의 성능 한계가 뚜렷해 도입 전 면밀한 검토가 요구된다.
OpenAI가 Codex Originals 프로그램에 소개할 실제 프로젝트와 제작자의 이야기를 받는다. 신청 화면은 개인 배경과 프로젝트 설명을 각각 최대1,000자로 요청하고 관련 링크도 받는다. 기존 소개는 창업·프로토타입·오픈소스 활동을 다루며, 모집 자체가 상금·투자나 성능 인증을 약속한 것은 아니다.
엔비디아가 Isaac ROS 5.0을 공개하며 로봇 개발용 에이전트 워크플로와 ROS2 Lyrical·Ubuntu24.04 지원을 소개했다. 공식 릴리스는 NITROS API를 직접 쓴 코드의 이관과 일부 플랫폼 제한도 명시한다. 개발 자동화와 실제 로봇의 자율 실행, 개별 라이브러리 가속과 전체 시스템 성능을 구분했다.
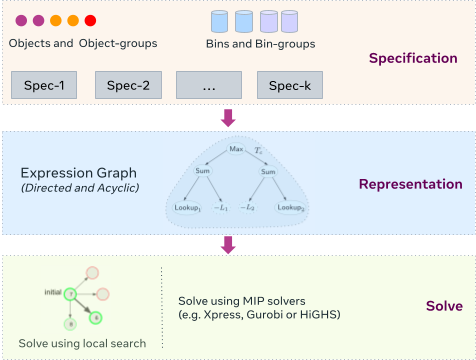
메타가 사내 인프라에서 9년 이상 활용해 온 자원 배정 문제 해결 라이브러리 '리밸런서(Rebalancer)'를 아파치 2.0 라이선스로 일반에 공개했다. 문제 모델링과 풀이 엔진을 분리하고 수식 그래프 기반 설계를 적용해 대규모 인프라 운영 최적화를 지원한다.
여기어때 숙박플랫폼개선TF팀이 오픈소스 표준인 OpenTelemetry와 컬럼형 DBMS인 ClickHouse를 활용해 상용 APM 수준의 분산 추적 스캐터 차트를 구축하는 아키텍처를 공개했습니다. 개별 지연 분포를 시각화하기 위한 SpanKind 분류 기준과 MergeTree 스토리지 최적화 방안이 제시되었습니다.