리퀴드 AI, 온디바이스 에이전트 특화 MoE 모델 'LFM2.5-24B-A2B' 공개
리퀴드 AI가 240억 개 파라미터 중 24.5억 개만 활성화하는 하이브리드 MoE 구조의 LFM2.5-24B-A2B를 오픈 웨이트로 공개했습니다. 131K 컨텍스트와 도구 조작에 특화되어 엣지 기기에서 빠른 추론 속도를 보이지만, 온디바이스 적재를 위한 메모리 하한선과 지식 집약 과제의 한계도 명확합니다.


리퀴드 AI가 240억 개 파라미터 중 24.5억 개만 활성화하는 하이브리드 MoE 구조의 LFM2.5-24B-A2B를 오픈 웨이트로 공개했습니다. 131K 컨텍스트와 도구 조작에 특화되어 엣지 기기에서 빠른 추론 속도를 보이지만, 온디바이스 적재를 위한 메모리 하한선과 지식 집약 과제의 한계도 명확합니다.
Ai2가 연구용 GPU 클러스터에 시간 예산과 계층적 공정 배분, 최소 실행 시간 계약을 도입한 운영 사례를 공개했다. 연구소는 30일 관찰에서 배정해야 할 GPU 시간의 98%를 제공했다고 보고했다. 높은 점유율과 실제 연산 효율의 차이, 중단되는 작업의 복구 비용도 함께 살핀다.
허깅페이스가 자연어 지시로 학습·평가 작업을 수행하는 ML Intern의 여섯 제작 사례를 소개했다. 공개 모델 카드와 공식 문서는 작업별 성과, 비상업 라이선스, 계산 비용의 범위를 보여준다. 쉽게 시작하는 학습 에이전트에서도 기준선과 검증 가능한 산출물이 중요한 이유를 살핀다.
리퀴드 AI가 텍스트 생성을 배제하고 단일 연산으로 분류·판단을 수행하는 오픈 가중치 의사결정 모델 ‘Open d1’ 2종을 허깅페이스를 통해 공개했다. 엣지 기기에서 수십 밀리초 단위의 저지연 처리를 목표로 설계되었으나, 작업 범위 제한과 벤치마크 검증 등의 과제도 남아 있다.
아부다비 TII가 16억 매개변수의 Falcon ASR을 소개했다. 아랍어 여섯 시험의 평균 단어 오류율 20.92%와 별도 에미라티 내부 평가를 제시하며 다섯 언어 전사를 지원한다고 밝혔다. 공개 데이터와 내부 시험, 데모 제공과 계획 중인 API를 구분해 읽는다.
엔비디아가 범용 파운데이션 모델인 네모트론 3를 기반으로 정밀한 사후 훈련과 테스트타임 연산 파이프라인을 결합해 2026년 국제정보올림피아드(IOI)와 국제수학올림피아드(IMO)에서 모두 금메달 수준의 성과를 거두었다고 발표했습니다. 연구팀은 전용 모델을 새로 구축하는 대신 재사용 가능한 전문화 방법론을 입증하고 핵심 가중치와 코드를 오픈소스로 공개했습니다.
아랍에미리트 TII가 현대 표준 아랍어를 넘어 현지 구어체와 문화적 맥락을 반영한 'Falcon-Emirati-7B'와 음성·문서 인식 모델군을 발표했습니다. 하이브리드 아키텍처와 합성 데이터를 활용해 방언 생성 능력을 끌어올렸으나, 방언 충실도 한계와 가중치 공개 조건 등 실무 적용 시 점검해야 할 과제도 상존합니다.
마이크로소프트와 허깅페이스가 AI 에이전트의 텍스트 답변 대신 백엔드 데이터베이스 상태를 직접 검증하는 벤치마크 '씽킹박스'를 공개했다. 12만 회 이상의 대규모 테스트 결과, 실제 DB 상태 검증에 실패한 시도 중 67.24%가 도구 호출 오류 없이 정상 응답으로 종료된 것으로 나타나 에이전트 신뢰도 검증 방식의 근본적 전환을 요구하고 있다.
앨런 인공지능 연구소(Ai2)가 과학 문헌 발췌문을 바탕으로 구조화된 인용 보고서를 신속히 작성하는 오픈 웨이트 모델 'AstaBrief 8B'를 공개했다. 기존 상용 다단계 파이프라인 대비 3.5배 빠른 생성 속도를 보였으나, 외부 벤치마크에서는 인용 정밀도 저하와 의미적 왜곡이라는 기술적 한계가 확인됐다.
ServiceNow CoreAI 연구팀이 엔터프라이즈 환경에서 인공지능 에이전트의 취약점을 분석하고 폐쇄 루프 커리큘럼을 통해 맞춤형 합성 훈련 데이터를 구축하는 프레임워크 'AutoSynthData'를 발표했습니다. 이 파이프라인은 과제 해결 성공률을 유의미하게 끌어올렸으나, 소스코드 공개 여부와 절대 성공률 측면에서 검토해야 할 한계도 안고 있습니다.
허깅페이스가 수주가 걸리던 음성 합성(TTS) 모델 평가를 수 시간 단위로 단축하는 '오픈 TTS 리더보드'를 공개했습니다. 명료도(WER), 화자 유사도, 실시간 지연 시간(TTFA) 등 자동화된 정량 지표를 바탕으로 오픈소스 모델 중심의 객관적 벤치마크 환경을 구축했습니다.
NVIDIA가 추가 학습이나 파라미터 튜닝 없이 단일 순전파로 정형 데이터를 예측하는 인컨텍스트 러닝 모델 'Kumo Tabular'를 공개했습니다. 합성 데이터 기반 사전학습과 3단계 트랜스포머 설계를 접목해 상업적 활용이 가능한 OpenMDW-1.1 라이선스로 제공됩니다.
멀티버스 컴퓨팅 연구팀이 모델 컨텍스트 프로토콜(MCP) 기반 LLM 에이전트의 '출처 교차 혼동' 문제를 해결하기 위한 사후 사실성 검증 프레임워크 '프로비넌스가드(ProvenanceGuard)'를 공개했습니다. 이 기술은 에이전트 재학습 없이도 생성된 답변의 세부 주장을 개별 도구 출력과 대조해 잘못된 인용을 차단합니다.
프랑스 AI 스타트업 H Company가 데스크톱 GUI, 웹, 모바일, API 도구 호출을 아우르는 컴퓨터 조작 에이전트 모델군 'Holo4'를 공개했다. 뛰어난 가성비와 오픈 웨이트 배포로 주목받고 있으나, 상업용 라이선스 분리와 복합 업무에서의 성능 한계가 뚜렷해 도입 전 면밀한 검토가 요구된다.
허깅페이스가 기존 데이터셋 저장소를 강화학습 환경으로 찾는 필터와 프레임워크 태그를 추가했다. Harbor·Verifiers·OpenEnv·NeMo Gym의 로딩 명령을 표시하지만 태그가 파일 형식을 변환하거나 작업을 실행하지는 않는다. 평가 보상의 의미와 실제 학습 업데이트도 각각 구분해야 한다.
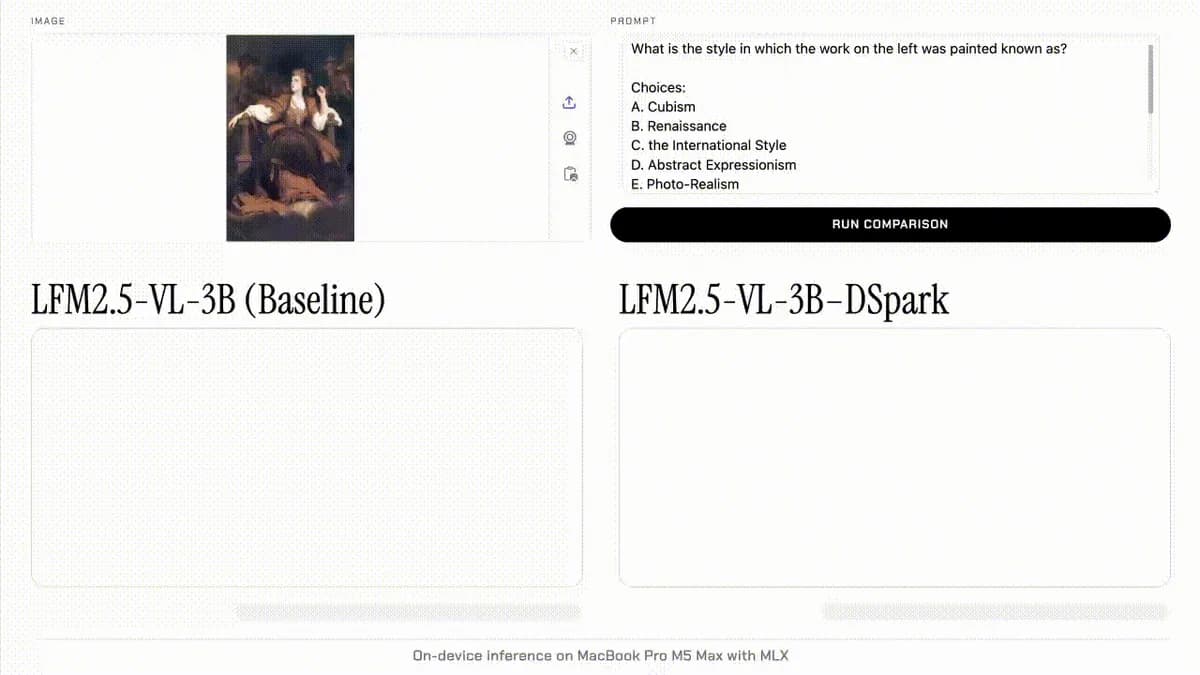
Liquid AI가 LFM2.5-VL-3B에 붙이는 실험용 DSpark 초안 모델을 공개했다. 약2억8,000만 매개변수를 추가해 후보 토큰을 미리 만들고 본 모델이 검증한다. 회사의16비트·배치1 실험에서 디코딩은 최대3.13배 빨라졌지만 이미지 처리와 입력 단계는 가속 대상이 아니어서 전체 작업 이득은 다르다.
허깅페이스가 oMLX 창시자이자 유지보수 담당자인 Jun Kim의 합류를 발표했다. 회사는 프로젝트의 전담 개발과 장기 지원, MLX 모델 구현의 개선을 목표로 제시했다. oMLX의 Apache 2.0 라이선스와 창시자의 리드는 유지하며, 향후 계획과 현재 서버 기능·실행 조건을 구분해 정리했다.
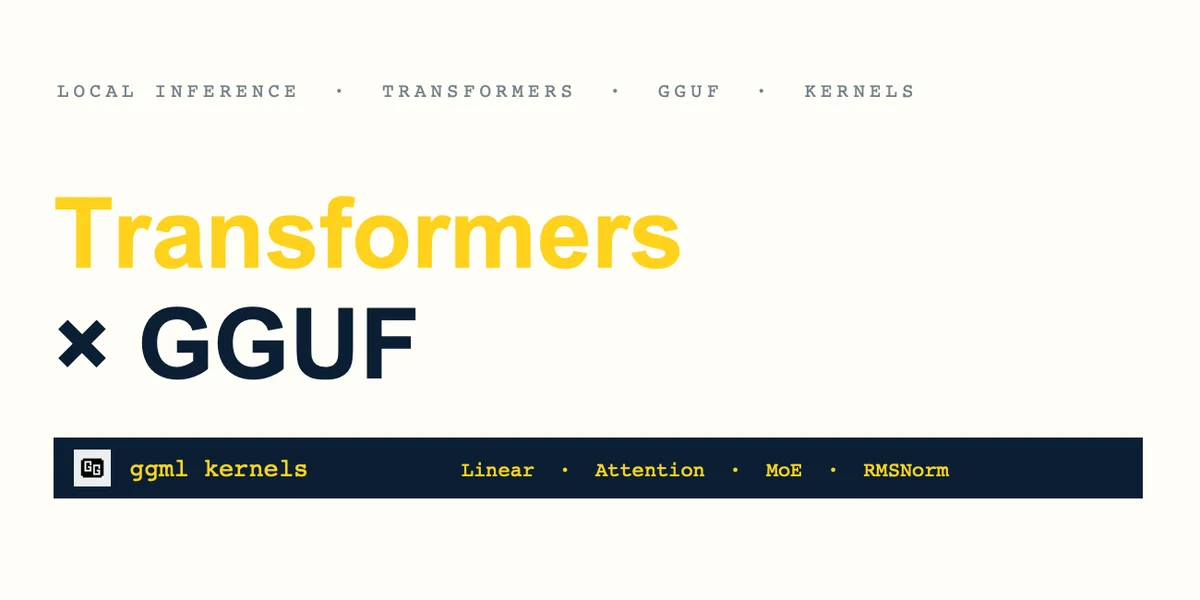
허깅페이스가 ggml의 Metal 커널로 압축 가중치를 직접 계산하는 Transformers 실행 경로를 소개했다. 초기 대상은 애플 실리콘과 Qwen3.5 계열이다. 익숙한 Python·PyTorch 인터페이스로 GGUF를 다루지만 커널이 없으면 가중치를 풀어 메모리를 더 쓰고, llama.cpp 비교도 서로 다른 측정 조건을 명시한다.
영국 AI Security Institute와 EvalEval이 평가 결과를 Evaluation Cards로 공개하는 협력을 소개했다. 다섯 주요 벤치마크의 여섯 모델 결과와 별도 사이버 평가를 다루며 Every Eval Ever 형식으로 맥락·설정을 연결한다. 연계 논문은 추론 자원과 실행 절차에 따라 점수가 달라지므로 동일 예산·조건 비교가 필요하다고 설명한다.
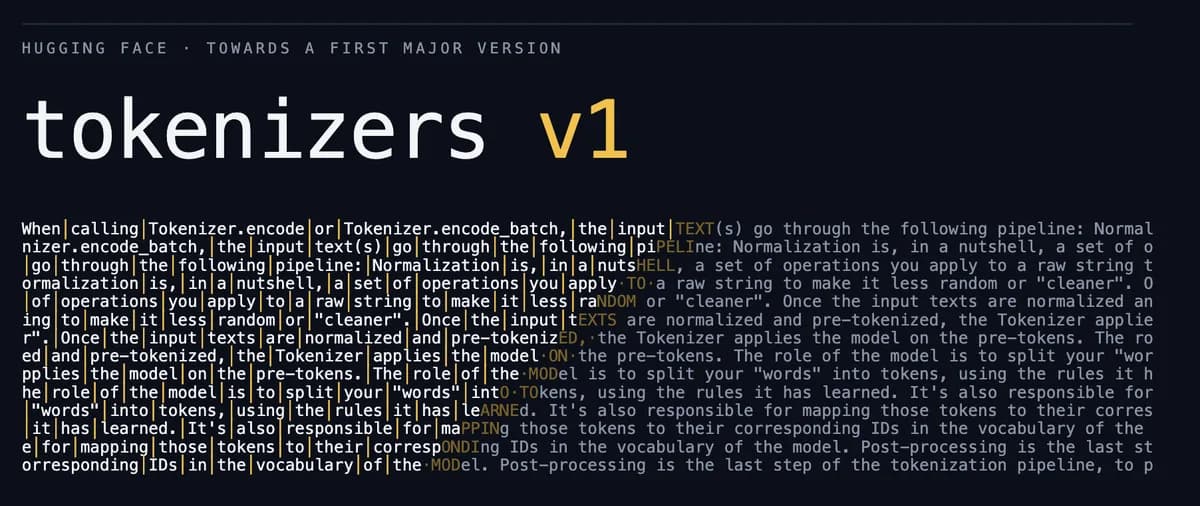
허깅페이스가 출력과 API를 유지하며 tokenizers의 처리 경로를 바꾼 v1 후보판을 소개했다. Apple M4 Max의 특정 비교에서 인코딩 성능 개선을 보고했지만 Python 호출 비용과 언어·반복도·전체 모델 처리 시간은 다른 조건이다.
IBM 연구진은 같은 과제를 반복할 때 모두 성공한 비율을 평균 성공률과 함께 평가했다. 기록의 불안정한 결정에서 지침을 만들어 다음 실행에 쓰는 방식으로 개선을 보고했지만, 안정적인 판단이 정확한 판단과 같지는 않으며 추가 분석 비용과 적용 범위가 남는다.
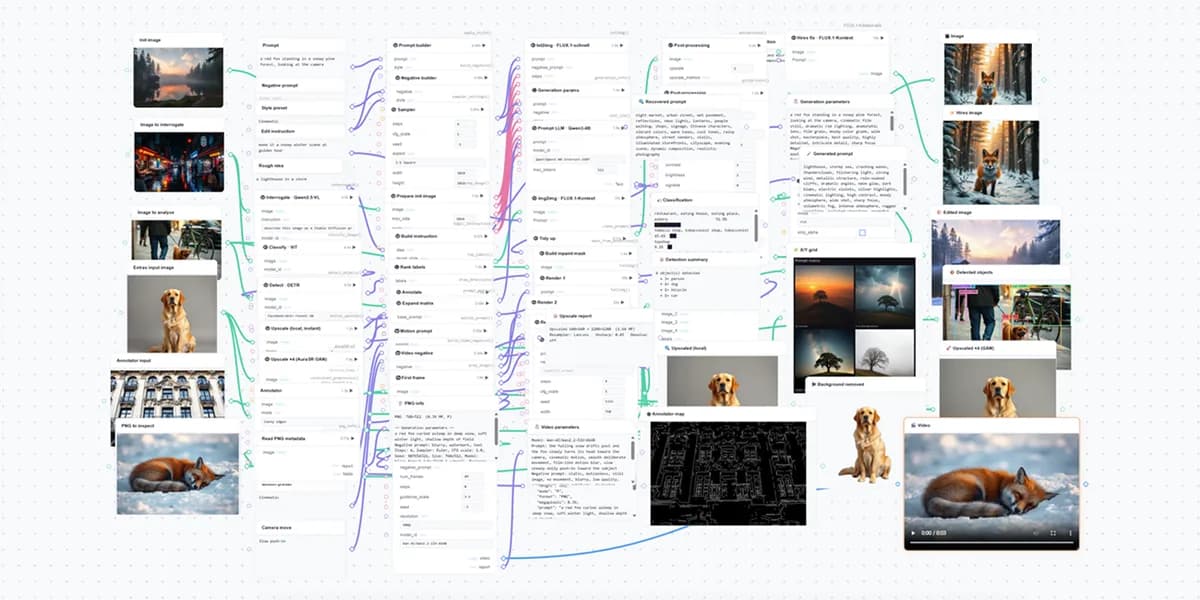
허깅페이스가 AUTOMATIC1111의 여러 작업을 Gradio의 한 캔버스로 다시 구성한 사례를 공개했다. 함수·모델·Space·데이터셋을 연결하지만 모든 작업이 무료나 로컬에서 수행되는 것은 아니다. 화면의 연결과 실제 API 단위·권한·이용량을 함께 볼 필요가 있다.
허깅페이스가 학습과 생성 작업을 별도 Jobs에 놓고 LoRA 어댑터를 버킷으로 공유하는 실험을 공개했다. 작은 전송량만큼 중요한 것은 같은 버전의 정책과 캐시를 유지하는 일이다. 특정 설정의 성능 결과를 모든 모델의 정확도나 처리량으로 확대할 수는 없다.
H컴퍼니가 텍스트와 이미지 패치를 하나의 양방향 인코더로 처리하는 NeoMME를 공개했다. 작은 검색 모델과 압축 색인으로 문서 검색의 비용을 줄이는 방향이지만, 페이지 인코딩 속도와 검색·답변 전체의 성능은 서로 다른 지표다.