엔비디아 AI Day 싱가포르, 공공 연구와 동남아 언어 모델 적용 사례 공개
엔비디아가 싱가포르 AI Day에서 동남아 공공·기업의 AI 개발 사례를 소개했다. HTX의 공공안전 연구, AI Singapore의 지역 언어 모델 공개, Sea의 인프라 도입은 서로 다른 단계다. SEA-LION 논문의 언어 평가 결과와 실제 서비스 운영 효과를 구분해 지역화의 의미와 확인할 조건을 살펴봤다.
엔비디아가 싱가포르 AI Day에서 동남아 공공·기업의 AI 개발 사례를 소개했다. HTX의 공공안전 연구, AI Singapore의 지역 언어 모델 공개, Sea의 인프라 도입은 서로 다른 단계다. SEA-LION 논문의 언어 평가 결과와 실제 서비스 운영 효과를 구분해 지역화의 의미와 확인할 조건을 살펴봤다.
구글의 10월 DevTools 정리는 Chrome 153·154에 도입된 광고 추적과 소프트 탐색 분석, MCP 실행 제어를 소개한다. 광고 지표는 Core Web Vitals와 별개이며, 에이전트의 스크립트 평가를 제한하는 설정도 추가됐다. 측정 대상과 실행 권한을 나눠 디버깅할 수 있는 변화다.
영국 AI Security Institute와 EvalEval이 평가 결과를 Evaluation Cards로 공개하는 협력을 소개했다. 다섯 주요 벤치마크의 여섯 모델 결과와 별도 사이버 평가를 다루며 Every Eval Ever 형식으로 맥락·설정을 연결한다. 연계 논문은 추론 자원과 실행 절차에 따라 점수가 달라지므로 동일 예산·조건 비교가 필요하다고 설명한다.
엔비디아가 AI 팩토리의 전력·냉각 제품을 DSX 요구 사항에 맞춰 평가하는 DSX Ready를 발표했다. 출시 때의 대상은 배터리 에너지 저장 시스템과 냉각 분배 장치다. 특정 제품의 적합성 평가이며 업체 전체나 설치 현장의 안정성·안전 인증을 대신하지 않는다. 현재 안내의 냉각액 범주와 초기 발표도 구분했다.
엔비디아가 차량·로봇의 하드웨어·소프트웨어·AI 행동·운영 환경을 함께 다루는 Halos의 안전 접근을 설명했다. 공식 기술 자료는 실제 시험과 시뮬레이션·운영 기록으로 안전 주장의 근거를 쌓는 구조다. ANAB의 검사기관 인정은 검사 수행 역량에 관한 것이며 모든 통합 제품의 최종 인증을 뜻하지 않는다.
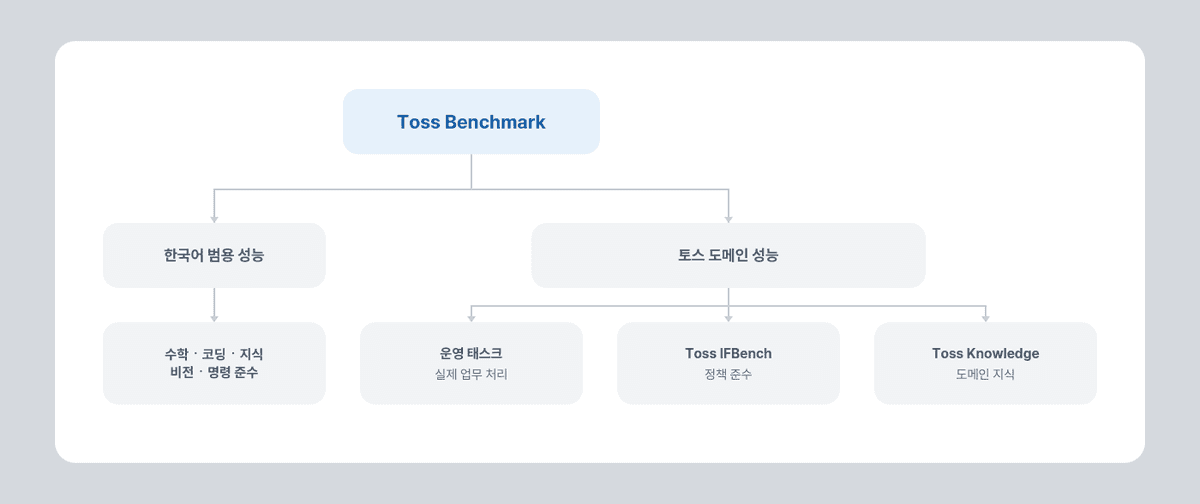
비바리퍼블리카(토스)가 공개 글로벌 리더보드 점수와 현업 환경 간의 괴리를 해소하기 위해 자체 LLM 평가 체계 'Toss Benchmark'를 구축했습니다. 평가 언어와 추론(Reasoning) 설정에 따른 극심한 순위 역전을 검증하고, 지시 준수 및 도메인 지식 지표를 바탕으로 사내 모델 서빙 기준을 정립했습니다.
IBM 연구진은 같은 과제를 반복할 때 모두 성공한 비율을 평균 성공률과 함께 평가했다. 기록의 불안정한 결정에서 지침을 만들어 다음 실행에 쓰는 방식으로 개선을 보고했지만, 안정적인 판단이 정확한 판단과 같지는 않으며 추가 분석 비용과 적용 범위가 남는다.
애플은9월 발표에서 건강 앱의 Insights·Longevity 탭과 기기 내 움직임 평가를 연말 미국 영어부터 제공할 계획이라고 밝혔다. 요약과 Health Age를 실제 수명이나 진단의 보장으로 읽지 않으며, 여러 자료의 출처·권한·기기 조건을 함께 확인해야 한다.
피그마가 크리에이티브 테크놀로지스트 마리사 첸타쿨의 창작 과정을 인터뷰했다. 그는 작업을 슬롭이라 부르는 취향의 단정보다 의도와 관객의 반응을 묻자고 제안한다. 웹 제작에서 시작한 경로, 이른 공유의 어려움과 분야를 넘나드는 영감이 평가 방식에 주는 의미를 살펴본다.
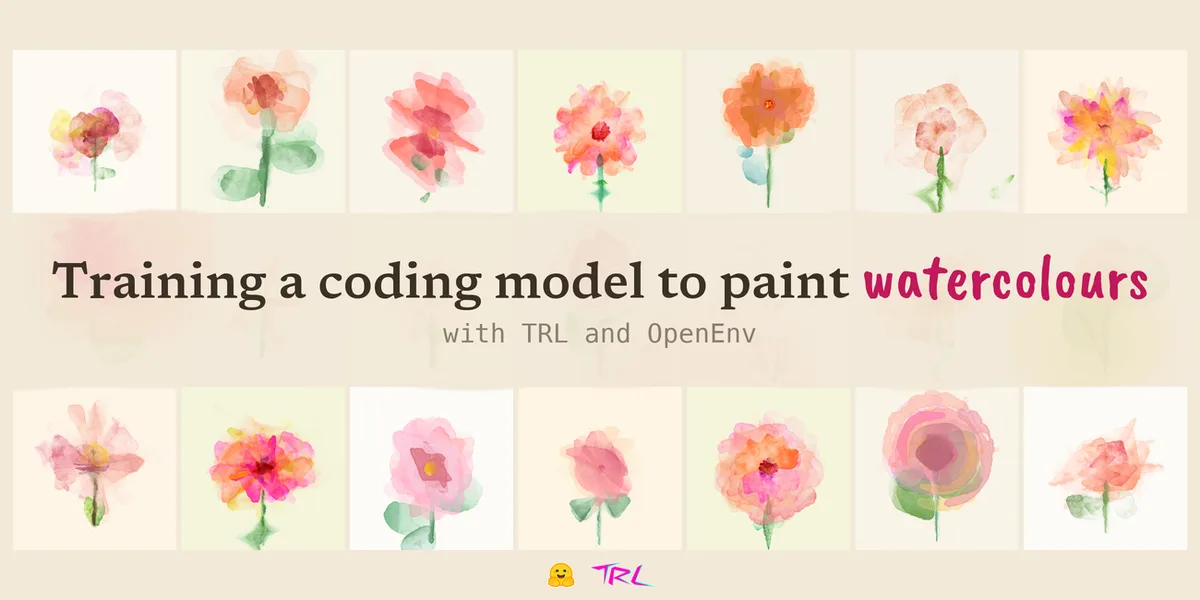
허깅페이스가 TRL과 OpenEnv로 코딩 모델의 수채화 표현을 학습한 실험을 공개했다. 모델이 만든 그림을 사람이 골라 참조 자료로 쓰고 보상 구성을 비교한다. 아름다움의 기준과 데이터의 범위, 평가 실패를 구분하는 일이 결과를 어떻게 바꾸는지 살핀다.
피그마가 코인베이스 디자인 시스템 팀의 Code Connect 도입·평가 사례를 공개했다. 실제 컴포넌트 연결을 갱신하고 같은 디자인·프롬프트·모델로 비교한 결과를 소개했다. 토큰과 비용의 서로 다른 수치, 평가 범위 및 연결 자료의 유지 비용을 중심으로 살펴본다.
협업 및 이슈 관리 소프트웨어 기업 리니어(Linear)가 신주 발행 없이 임직원 보유 지분을 매각하는 9,900만 달러 규모의 텐더 오퍼를 완료하며 25억 달러의 기업가치를 인정받았습니다. 연간 반복 매출(ARR) 1억 달러 돌파와 유료 워크스페이스 내 AI 에이전트 확산을 바탕으로 실무 개발 워크플로의 핵심 조율 계층으로 진화하고 있습니다.
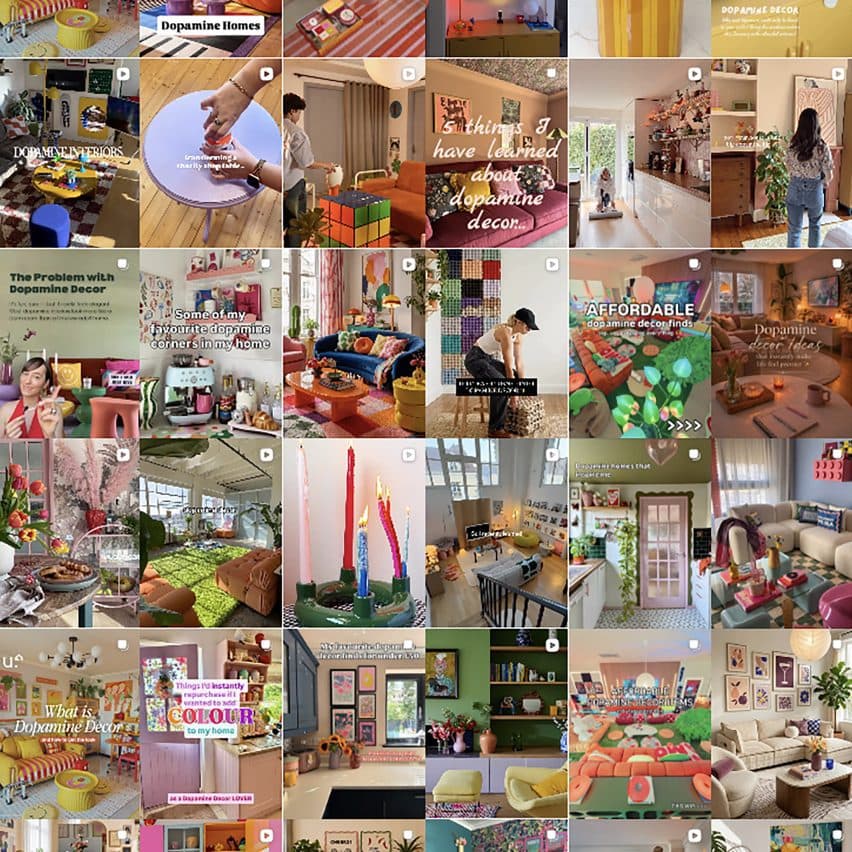
디자인 비평가 줄리 래스키는 도파민 데코의 색채보다 뇌 화학을 동원한 판매 언어를 문제 삼았다. 관련 책의 실제 소개와 안드레아 드 파이바의 논의를 대조하면, 개인 취향의 즐거움과 검증된 건강 효과를 구분할 필요가 드러난다.
미드저니가 7월 24일 V8.2 이미지 모델을 공개하고 미감·품질·개인화 개선을 설명했다. 평가 결과는 정량적으로 공개하지 않았다. 기존 프로필의 호환 범위와 버전 선택 기록을 통해 취향에 맞는 결과와 요구에 맞는 결과를 구분한다.
제품 디자이너 캣 호먼은 정신건강 앱에서 시각적 새로움보다 인지 부담·감정적 맥락·예측 가능한 탐색을 살펴야 한다고 제안했다. 실제 사용 연구와 접근성 기준을 대조하면, 이용 지속과 치료 효과를 구분하고 디자인 사례의 효용을 제한된 근거 안에서 읽어야 한다.
프라틱 조글레카는 AI 예측을 확정된 답으로 다루지 않고 가설·실험·수정으로 연결하는 설계를 제안했다. 언어모델 자기 평가 연구를 함께 살펴보면, 모델이 적은 신뢰도와 실제 정답률의 관계를 확인해야 하며 설명·검토·복구 경로가 수치만큼 중요하다.
빌헬름 하마르셰이(1864–1916)는 덴마크 화가로, 회색·흰색·갈색 등 무채색 팔레트로 고요한 실내를 그려 "침묵의 화가"로 불렸다. 주로 자신의 아파트를 배경으로, 등을 돌린 아내 이다의 뒷모습을 통해 얼굴 없이도 감정을 전달하는 독특한 화풍을 완성했다. 인상주의·표현주의와 거리를 두고 침묵과 여백을 예술로 승화시켰으며, 사후 재조명되어 북유럽 미니멀리즘의 상징적 인물로 평가받는다.