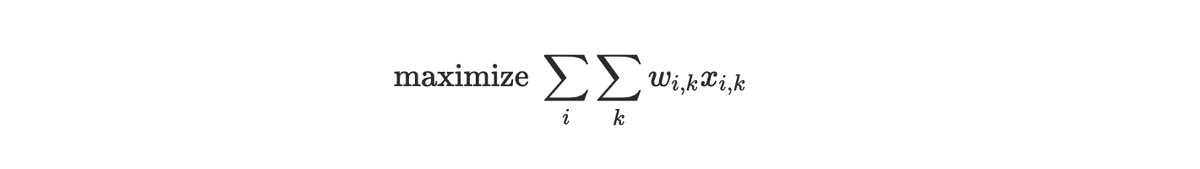메타의 포럼 앱 개발 회고, AI 코드 생성량 대신 테스트와 화면 검증을 완료 기준으로 삼다
메타가 페이스북 그룹 전용 앱 포럼을 구축하며 AI 에이전트를 개발 및 검증 과정에 결합한 경험을 공개했다. 회사는 8주 만의 핵심 기능 구현과 메모리 문제 개선을 보고했으나, 완전 자율화 대신 최종 승인과 제품 판단을 엔지니어의 몫으로 남겼다.
메타가 페이스북 그룹 전용 앱 포럼을 구축하며 AI 에이전트를 개발 및 검증 과정에 결합한 경험을 공개했다. 회사는 8주 만의 핵심 기능 구현과 메모리 문제 개선을 보고했으나, 완전 자율화 대신 최종 승인과 제품 판단을 엔지니어의 몫으로 남겼다.
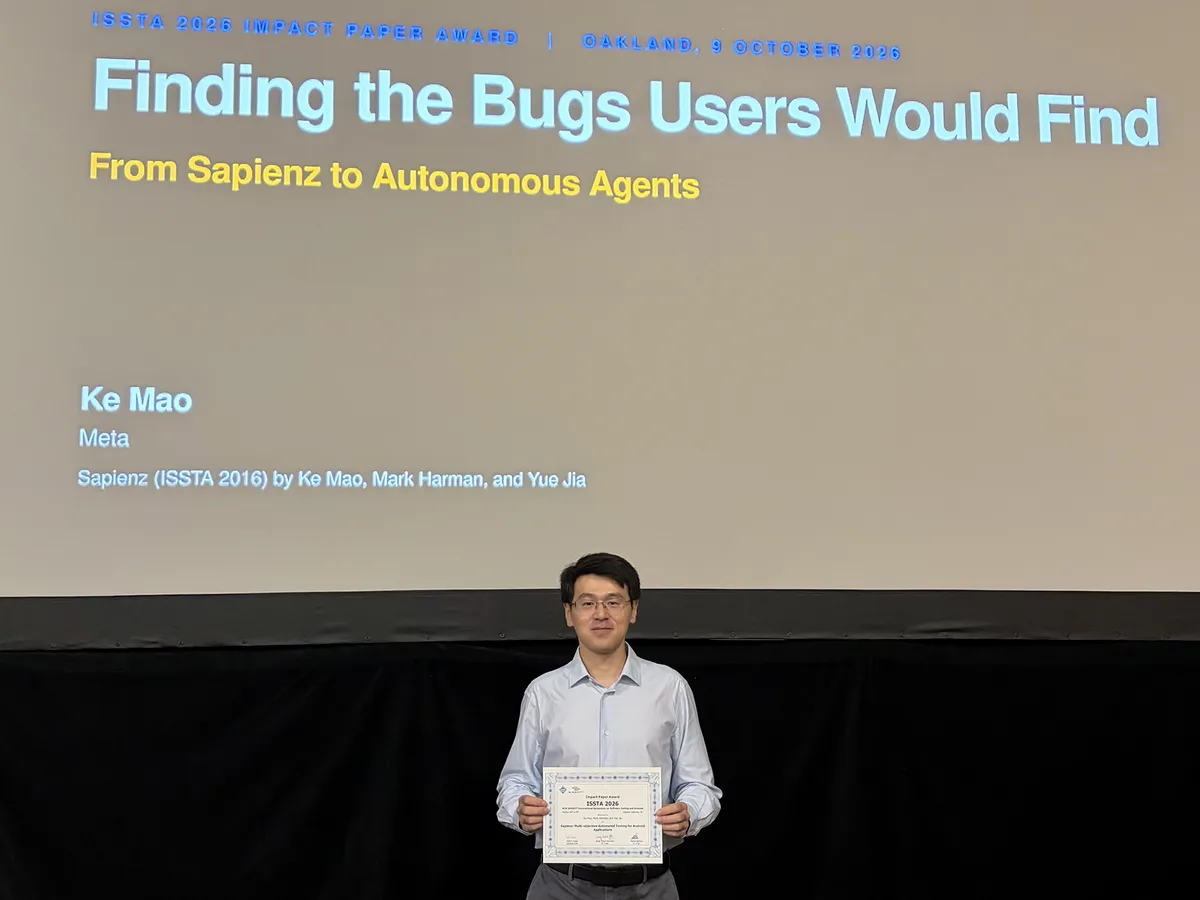
안드로이드 앱의 탐색 범위 확장, 비정상 충돌 감지, 재현 단계 최소화를 결합했던 2016년 사피엔즈 연구가 ISSTA 2026 영향력 논문상을 받았다. 메타는 이 연구를 기반으로 대규모 자동 테스트 파이프라인을 구축해 운영해 왔으나, 초기 학술 실험 수치와 현재의 일일 운영 통계는 측정 대상과 조건이 다르므로 구분해 살펴봐야 한다.
서드 모먼트 리서치는 동시 1만 개, 세션당 36~48시간 규모의 AI 에이전트 연구 운영 사례를 공개했다. 핵심은 모델 선택에 그치지 않고 백테스트 연산 병목 해소, 상위 실행 흐름의 중단 감독, 고객 승인 기반 실패 유형 평가를 통합한 환경 설계에 있다.
엔비디아가 범용 파운데이션 모델 네모트론 3에 사후 훈련과 테스트타임 연산 탐색 파이프라인을 적용해 IOI와 IMO 2026에서 금메달 수준의 성과를 거두었다고 발표했습니다.
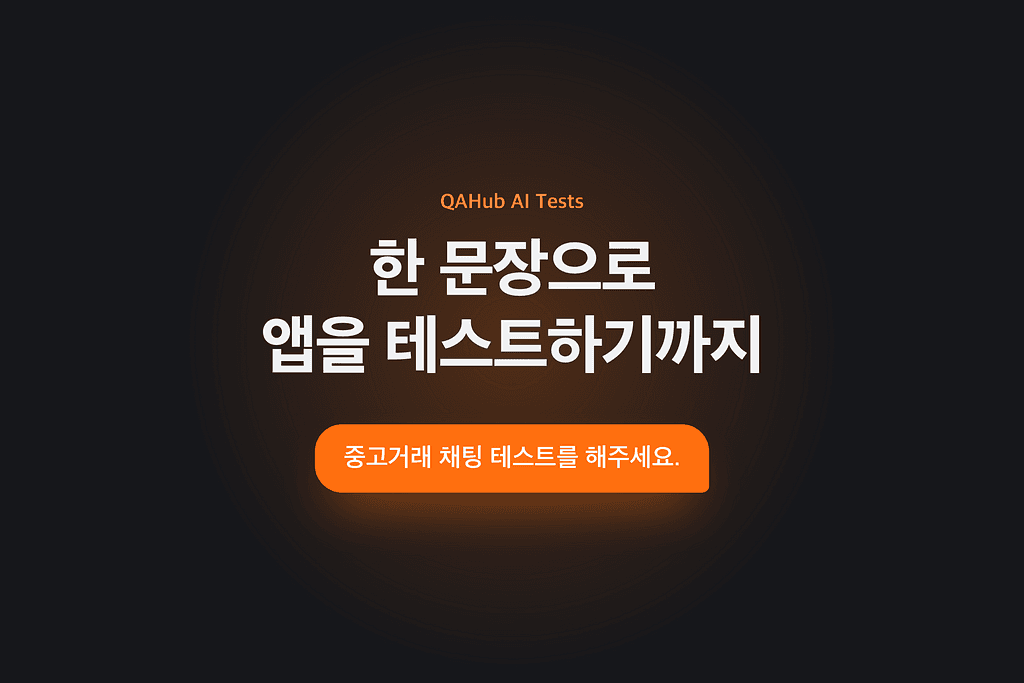
당근이 노션과 구글 시트에 분산되어 있던 22개 프로젝트의 검증 자산을 통합하고, 자가 치유와 경로 재생 기술을 결합해 실기기 모바일 앱 테스트를 안정화한 QAHub 구조를 공개했다.
마이크로소프트와 허깅페이스가 백엔드 데이터베이스 상태를 직접 대조하는 씽킹박스 벤치마크를 공개했다. 12만 회가 넘는 테스트 결과, 실제 검증에 실패한 시도 중 67.24%가 도구 호출 오류 없이 정상 응답으로 완료된 것으로 확인됐다.
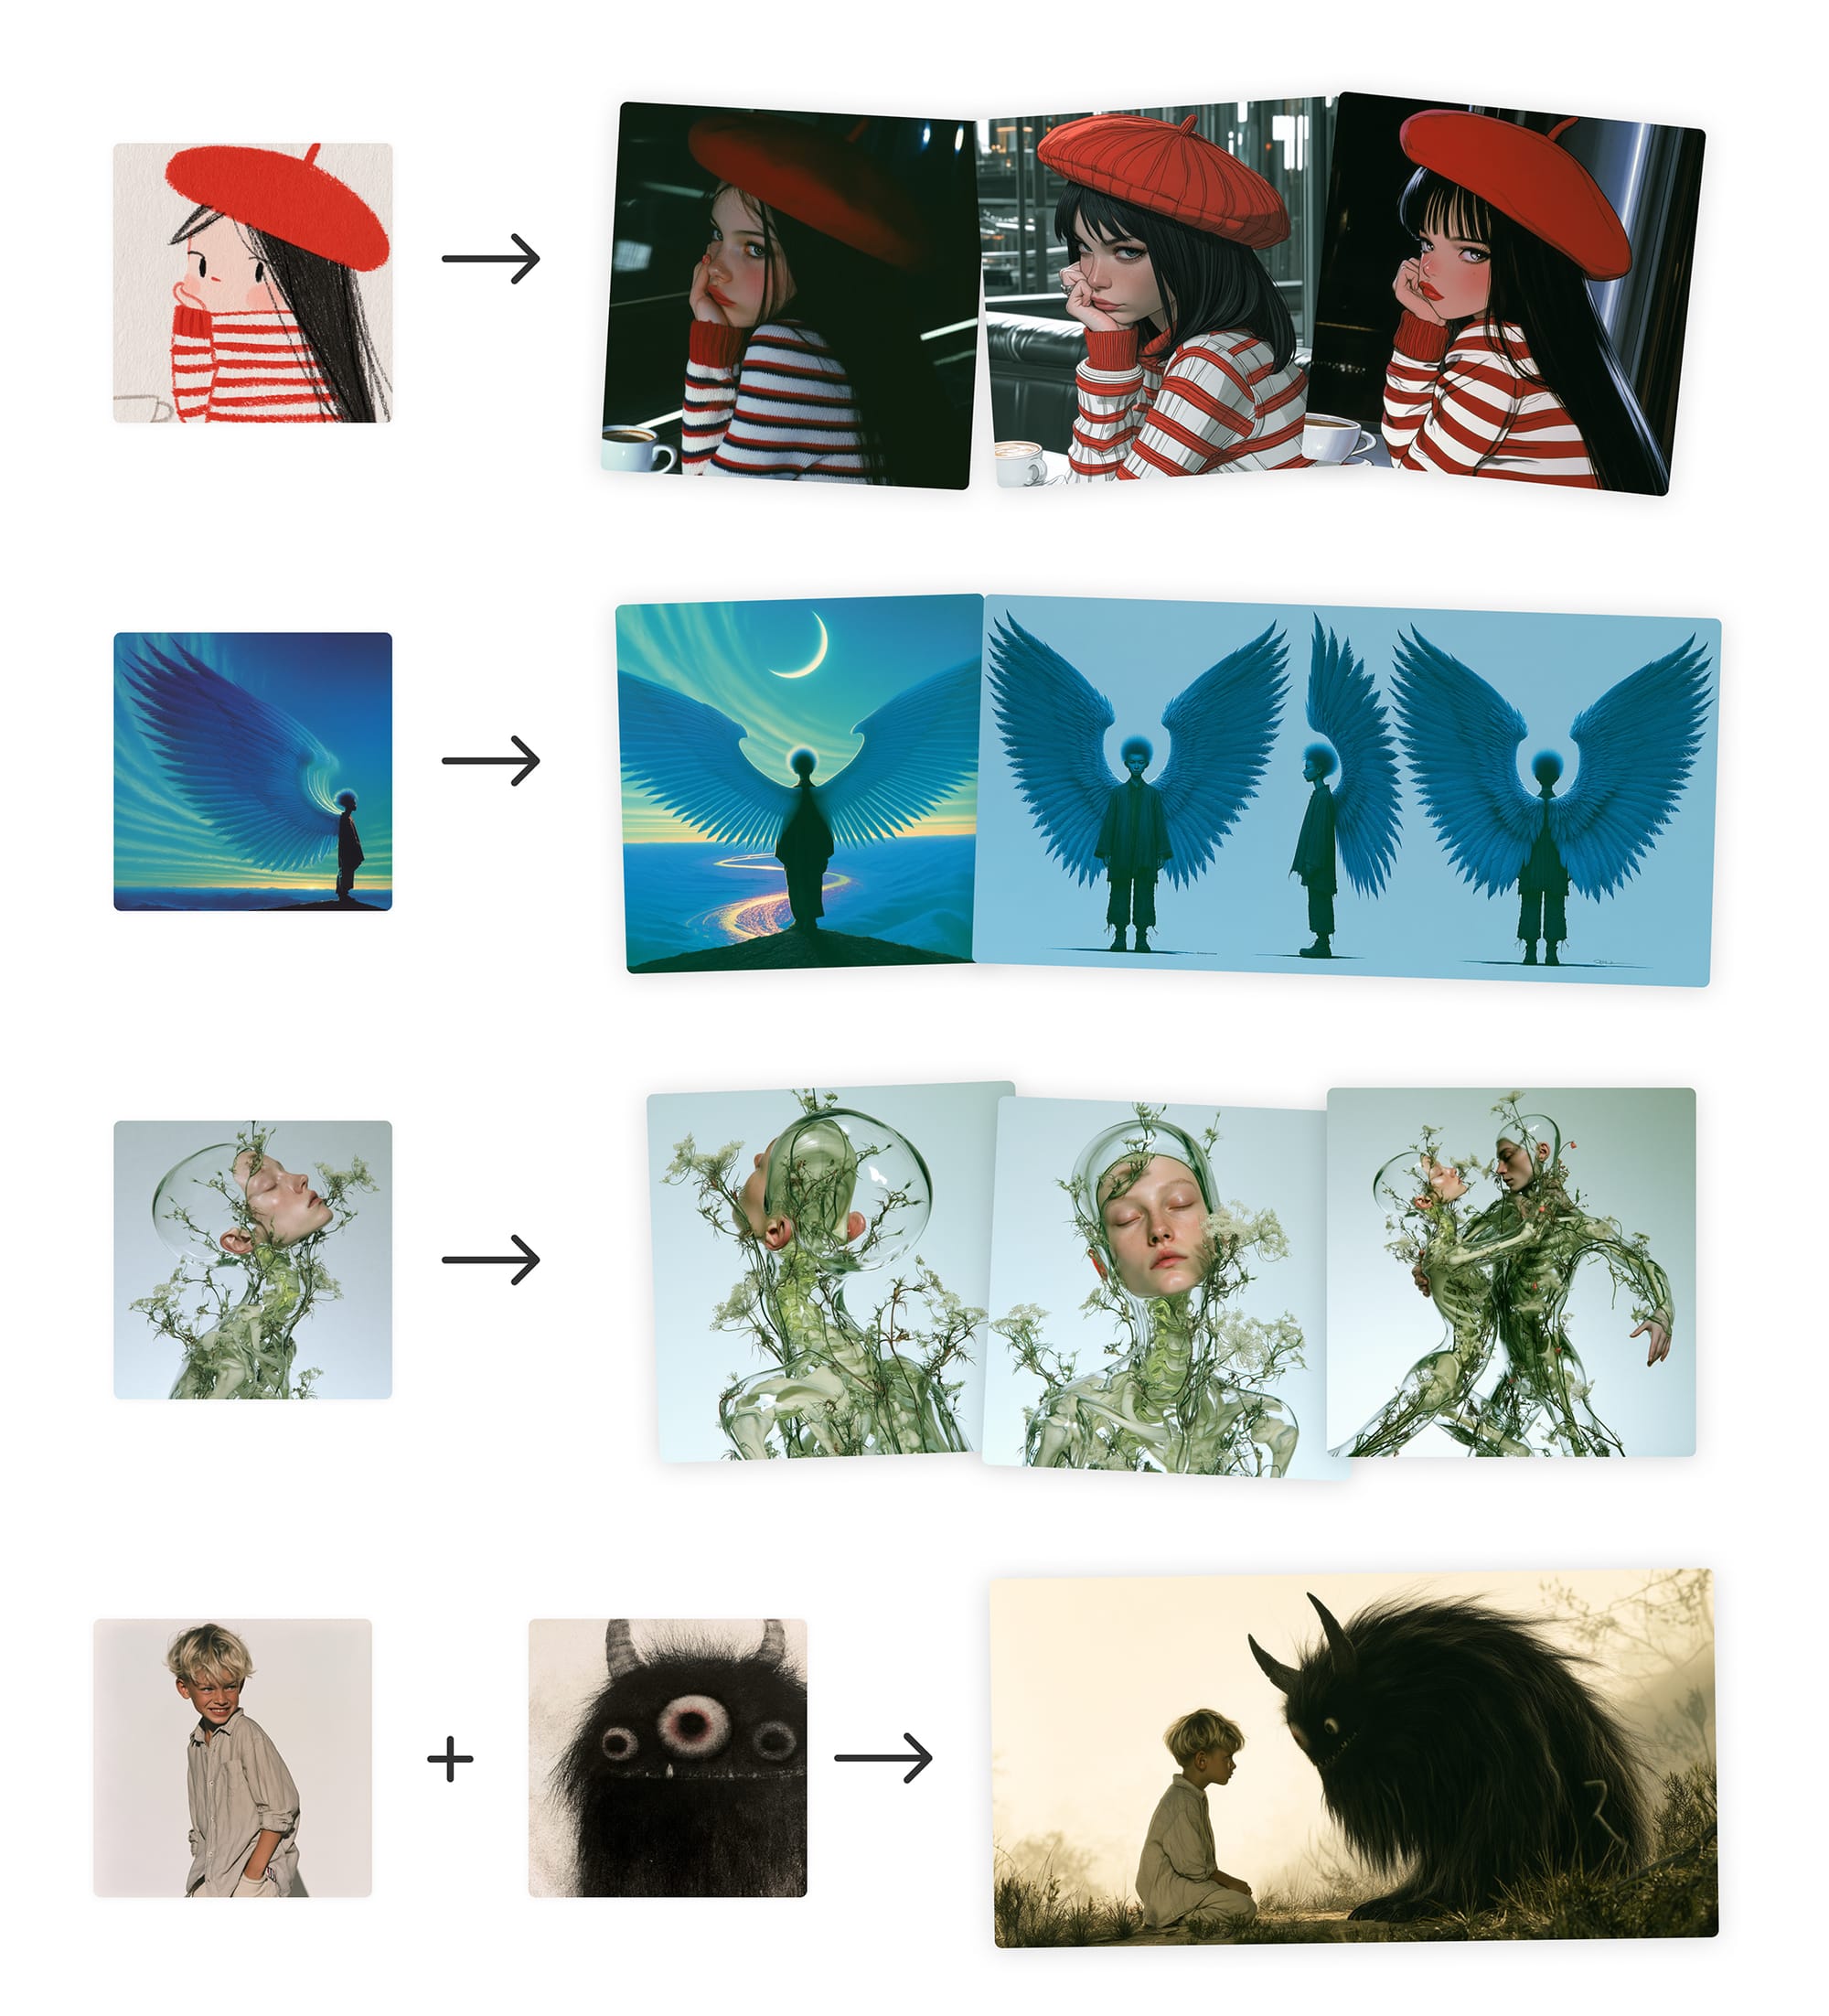
미드저니가 웹 알파 테스트 환경에서 10만 장 이상 라이브러리 탐색 시 브라우저 강제 종료를 막고 다중 스타일 참조를 단일 알약 UI로 합쳤습니다. 비율 고정 편집과 무드보드 연계도 개선됐습니다.
토스 커머스 개인화 팀이 추천 파이프라인의 리트리벌 단계에 정수계획법을 적용해 후보 수를 50% 축소하고 구매 전환율 7.55% 개선을 기록했습니다. 노출 다양성 저하 문제는 검베 가중 샘플링을 결합해 함께 보완했습니다.
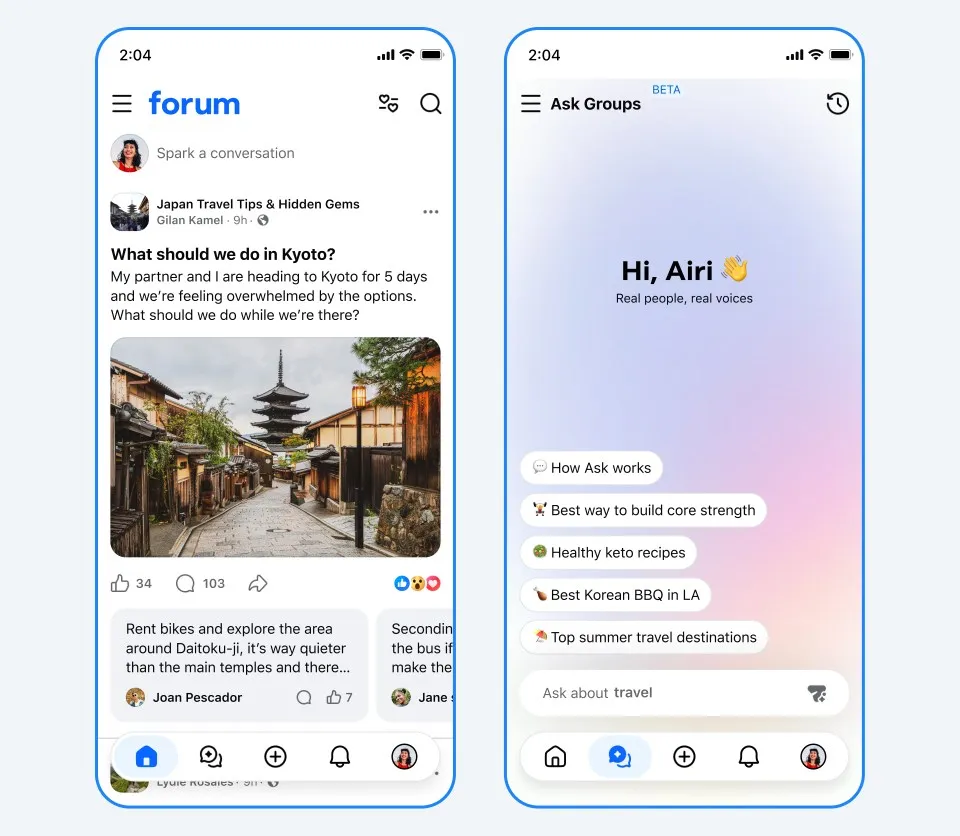
메타가 페이스북 그룹의 대화와 정보 탐색을 메인 피드와 분리한 전용 독립 앱 ‘포럼(Forum)’을 미국 등 일부 지역에 공개 테스트 형태로 출시했습니다. AI 기반 질의응답 기능 ‘Ask’와 관심사 기반 토픽 라벨, 개편된 우수 기여자 시스템을 전면에 내세웠으나 과거 독립 앱 철회 이력과 AI 정보의 정확성 검증이라는 과제가 여전히 남아 있습니다.
토스뱅크가 홈 화면 내 자산관리 리포트를 고정 배너에서 플로팅 카드로 재설계하며 클릭률과 전환율을 각각 3배 개선했다고 밝혔습니다. 정보 층위를 분리하고 스크롤 연동 모션을 도입한 실험 성과와 함께 비공개 지표에 따른 실무적 한계를 검토합니다.
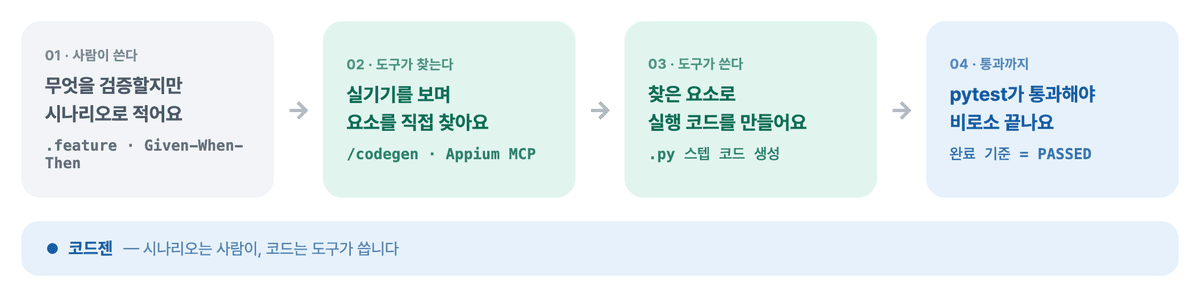
토스 QA Platform 팀이 주간 배포 파이프라인의 스모크 테스트 유지보수 비용을 낮추기 위해 '토스닥터 V2'를 공개했습니다. 한국어 BDD 시나리오를 바탕으로 LLM과 Appium MCP를 연동해 코드를 자동 생성하고, 테스트 실행 중 장애를 실시간으로 치유하며 실패 원인을 스스로 수정하는 구조를 구축했습니다. 다만 완전 자동화의 위험을 방지하기 위해 검증 단계의 유사 매칭을 제한하고 수동 개입 기준을 명확히 분리했습니다.
AI 코딩 도구 도입 이후 테스트 규모가 급증하자 Linear는 고성능 러너 전환, 네이티브 도구 적용, 선행 셋업 단축, 선별적 격리 완화로 파이프라인 대기 시간을 5분 초반으로 줄였습니다.
미드저니가 웹 알파 테스트 사이트에 한국어 인터페이스 지원을 도입하고 v8.2 에디터 워크플로를 개편했습니다. 모바일 기본 레이아웃 보완과 파라미터 파싱 결함 수정이 함께 이뤄졌으나, 모바일 작업 시에는 정식 프로덕션 사이트 사용이 권장됩니다.
여기어때 서비스QA팀이 전시 화면 검증에서 예약·정산 업무로 이동하며 달라진 테스트 관점을 공유했다. 배치 실행 뒤 결과를 확인하고 정책·계산식과 상태 테이블을 준비하는 과정이 핵심이다. 화면의 정상 동작과 데이터 흐름의 정합성이 어떻게 다른 검증을 요구하는지 살펴본다.
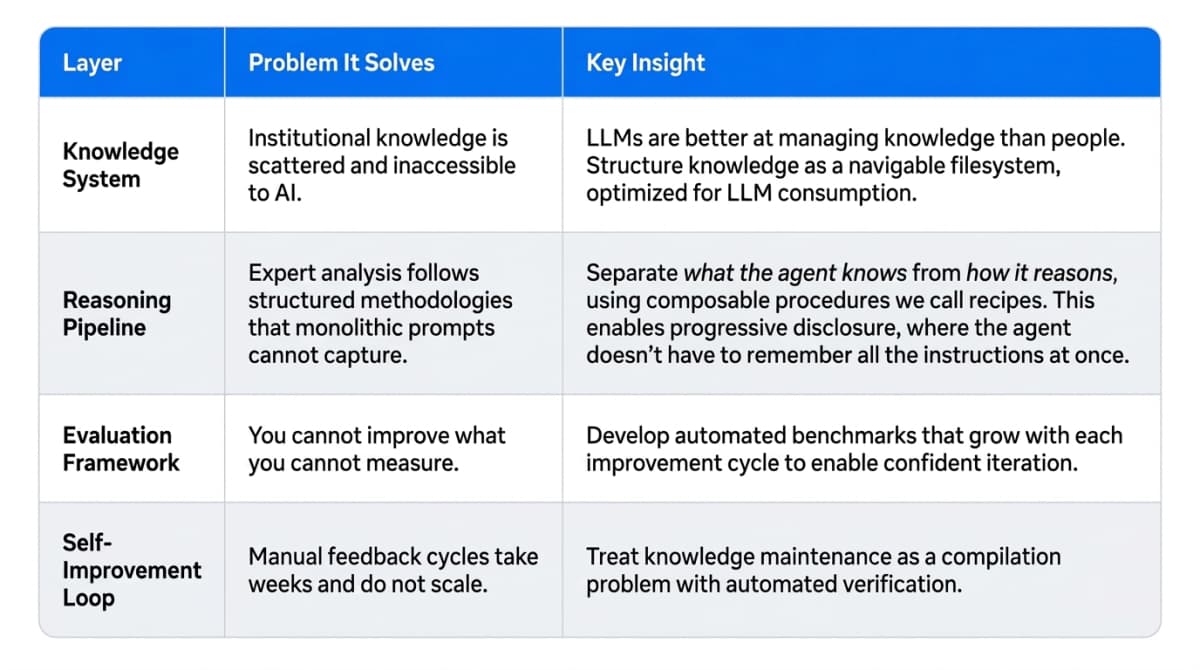
메타 엔지니어링 팀이 파운데이션 모델의 가중치 재학습 없이 사내 전문가의 지식과 판단 기준을 구조화된 파일로 축적하는 '조직 세컨드 브레인' 아키텍처를 공개했습니다. 지식과 추론 절차를 분리하고 회귀 테스트를 거쳐 전문가 피드백을 지속 반영하는 구조지만, 구체적인 정량 지표와 기반 모델 정보는 공개되지 않았습니다.
미드저니가 V8.2 기반 통합 편집 모델의 공개 테스트 시작 약 48시간 만에 긴급 품질 패치를 적용했습니다. 파편화된 개별 도구를 단일 모델로 묶어 최대 4개 참조 이미지를 제어하는 진전을 보였으나, 구체적 기술 사양 미공개와 변동성으로 인해 실무 파이프라인 도입에는 정밀한 검증이 요구됩니다.
미드저니가 2026년 8월 27일 자연어 지시 편집과 최대 4장의 이미지 참조 기능을 갖춘 V8.2 전용 편집 모델을 공개 테스트 형태로 선보였습니다. 기존 옴니 레퍼런스를 대체하고 인·아웃페인팅을 포괄하지만, 아키텍처 비공개와 기능 호환 제약 등 실무 도입 전 확인해야 할 과제도 함께 공존합니다.
피그마가 빠르게 생성된 시제품의 외관과 제품 방향 판단을 구분해야 한다는 개발 관점을 제시했다. 테스트와 명세, 디자인 시스템 맥락을 제공하고 최종 방향은 팀이 판단해야 한다는 설명이다.
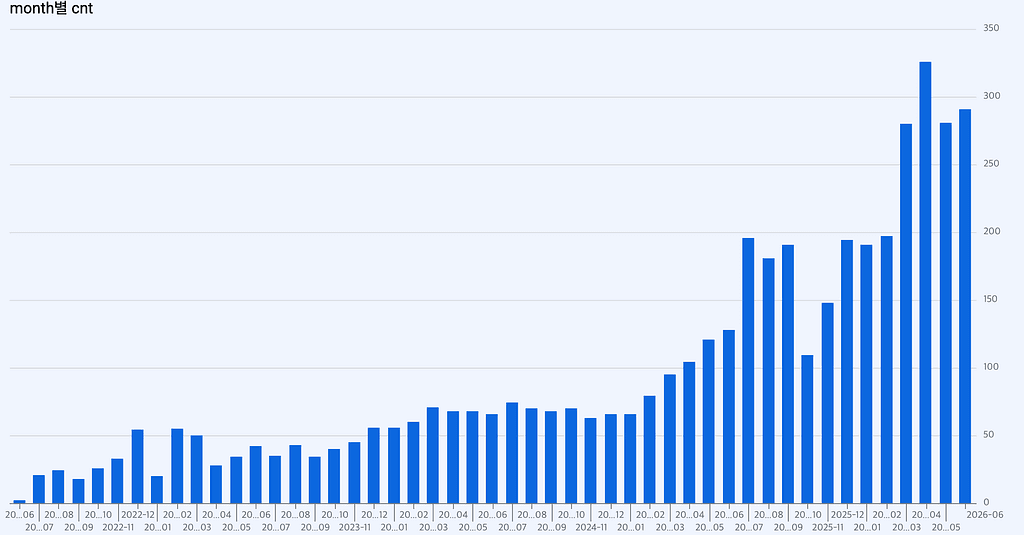
당근이 월 290여 건으로 급증한 A/B 테스트 환경에 맞춰 사내 실험 플랫폼을 개편했습니다. 깃허브 코드 기반 등록을 UI 셀프서브 방식으로 바꾸고 슬롯 및 레이어 기반 상호배제 그룹을 도입해 실험 간 간섭을 분리했습니다.
캐리 웹스터가 제시한 UX 투자 효과를 원자료와 비교해 검토했다. 널리 인용되는 다섯 명 테스트와 디자인 기업의 재무 수치는 반복 조사 절차와 퍼센트포인트 단위를 함께 살펴야 타당한 투자 근거가 된다.
Airbnb는 GraphQL 인프라, 제품 컨텍스트, LLM을 결합하여 새로운 지시문(@generateMock)을 사용해 설득력 있고 타입 안전한 mock 데이터를 생성하고 유지합니다. 이 솔루션은 엔지니어가 수동으로 mock을 작성하고 유지 관리할 필요성을 없애 제품 개발에 집중할 수 있도록 합니다. @generateMock과 @respondWithMock 지시문은 엔지니어가 서버 구현이 완료되기 전에 클라이언트를 구축할 수 있도록 지원하며, 쿼리가 발전함에 따라 mock 데이터가 동기화 상태를 유지하도록 보장합니다.