셰드, 알키 해변 주택의 주방과 식당을 바꿔 조망과 수납을 다시 짜다
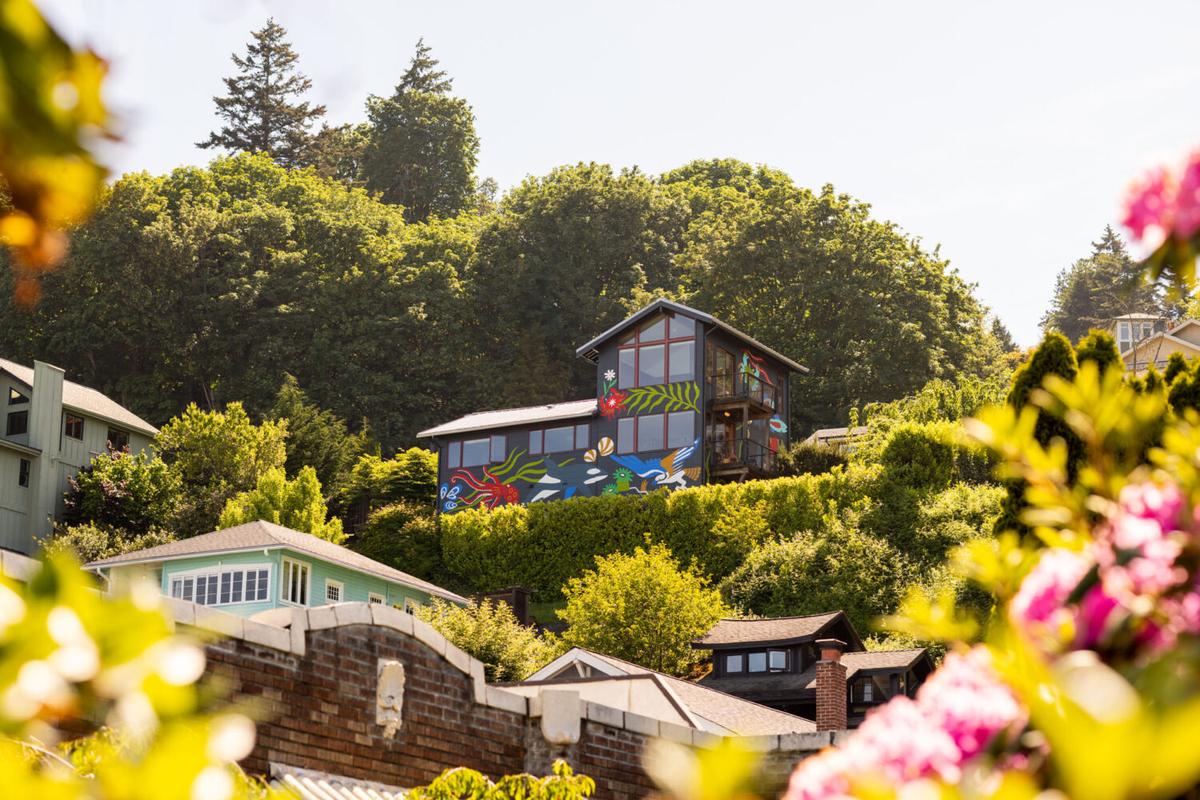
시애틀의 1910년 주택 알키 룩아웃은 강한 색채보다 먼저 식사하는 자리와 수납을 바꿨다. 창가 부스와 타일 벽, 침대 아래 서랍에 이어 외벽의 야생동물 벽화까지 살펴보면, 일상 동작을 정리한 공간과 가족의 취향이 연결되는 순서가 보인다.
시애틀의 1910년 주택 알키 룩아웃은 강한 색채보다 먼저 식사하는 자리와 수납을 바꿨다. 창가 부스와 타일 벽, 침대 아래 서랍에 이어 외벽의 야생동물 벽화까지 살펴보면, 일상 동작을 정리한 공간과 가족의 취향이 연결되는 순서가 보인다.
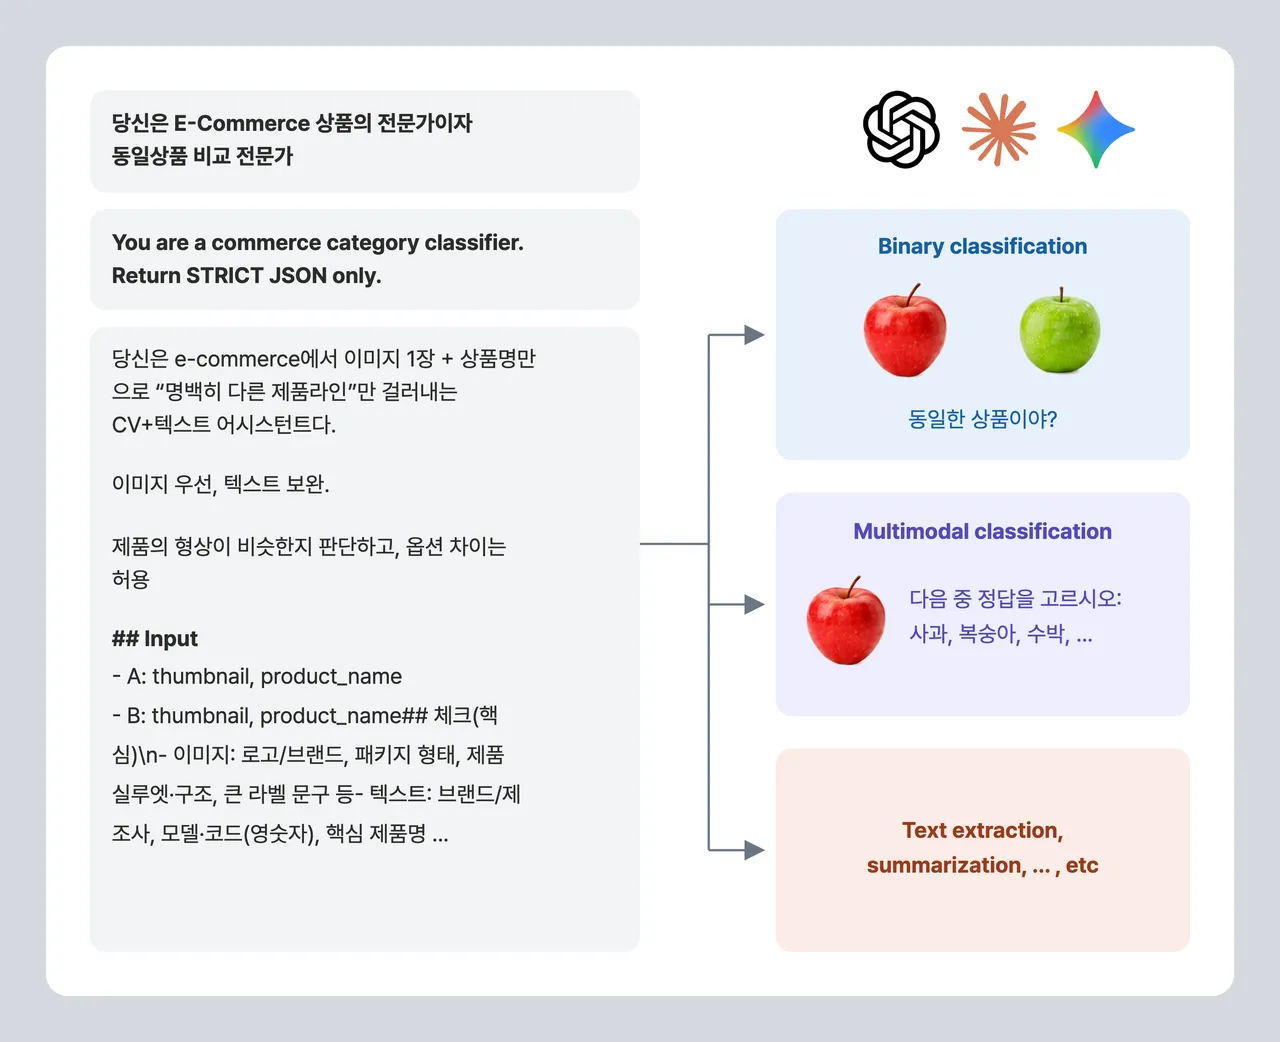
토스는 상품 판별 요청 중 검증 기준을 통과한 구간만 소형 모델에 맡겼다. 리퀴드AI는 텍스트·사진·음성 등 입력과 목적에 맞춰 작은 모델을 특화하는 예제를 공개했다. 두 자료를 함께 읽으면 모델 크기보다 먼저 정할 작업의 범위와 되돌아갈 경로가 보인다.
클라우드플레어가 GLM-5.3의 긴 입력에서 다른 요청의 자료가 응답에 섞인 사고를 공개했다. 9월에 수정한 사건을 운영사와 추론 엔진 팀의 기록으로 읽으면, 모델의 문맥 길이와 실제 메모리 용량, 성공 응답과 자료 격리가 만나는 지점이 드러난다.
당근은 모델을 바꾼 뒤 프롬프트 캐시가 작동하지 않아 비용이 늘어난 운영 문제를 겪었고, 다르마 AI는 자체 모델의 출력 어휘를 재구성해 실행 비용을 줄였다고 밝혔다. 두 사례는 단가 수치보다 입력과 출력 중 어느 단계의 반복을 다루는지에 따라 최적화 방식이 다름을 보여준다.
엔비디아가 RTX 스파크 노트북 판매 시작과 서울 등 여섯 도시의 체험 행사 결과를 소개했다. 최대 128GB 통합 메모리와 FP4 연산 수치는 실제 앱 성능과 구분해야 한다. 앞선 플랫폼 발표·행사 예고에 이은 판매 및 행사 결과 소식으로, 모델별 구성과 업무 도구의 호환성이 다음 확인 대상이다.
브라질 이타우가 자연어 대화 계층 ia.i와 내부 통제 플랫폼 IARA를 공개했다. 초기 30만 고객 단계와 장기 확장 계획을 엄격히 구분하고 공급사의 특정 업무 효율 수치와 은행 전반의 성과를 명확히 분리해 살펴야 한다.
허깅페이스가 리플렉션 빔의 가중치와 실행 경로를 소개했다. 총 5,010억 매개변수 중 토큰당 약 230억을 활성화하지만 전체 가중치를 보관할 자원은 필요하다. 100만 토큰 맥락과 여러 정밀도, 공급사 벤치마크를 실제 한국어 업무의 비용·성공률과 구분해 읽는다.
IBM Granite Switch는 공통 모델의 맥락을 재사용하며 대화·판단·위험 탐지와 음성 전사를 연결한다. 10월 소개 뒤 현재 4.1.1 모델 카드는 영어 등 7개 언어의 전사와 문장부호·대문자 출력을 안내한다. 음성 인식과 언어 모델은 분리된 단계이며 버전별 범위를 맞춰 읽어야 한다.
GitHub가 Copilot의 세 모델을 2026년 11월 16일 지원 종료한다고 예고했다. Opus 계열은 5.5, Terra는 GPT-6.1 Sol 또는 GPT-6 Luna를 대안으로 안내한다. 개인 연간 구독자의 Opus 4.8 예외와 기업의 모델 허용 정책은 별도로 적용된다.
엔비디아가 문서·영상 이해용 Nemotron 3.5 Super VL과 로컬 에이전트용 Bolt를 소개했다. Bolt의 24GB 목표는 특정 동시 요청 수와 문맥 길이, 정밀도를 전제로 한다. 모델의 최대 문맥과 실제 배포에서 사용할 문맥, 처리량은 구분해서 비교해야 한다.
엔비디아가 GeForce NOW의 DLSS 4.5 오버라이드 제어와 주간 게임 추가를 발표했다. 화질 관련 모델을 선택할 수 있지만 동적 다중 프레임 생성은 Ultimate의 RTX 5080 서버에서 최대 4배까지다. 지원 게임과 게임 내부 설정, 스트리밍 조건을 함께 확인해야 적용된다.
Hugging Face가 FLUX.3 Image Klein의 Diffusers 지원을 공개했다. 단일 모델로 텍스트 생성과 다중 참조 편집, 좌표 기반 요소 배치를 다룬다. 좌표는 위치를 유도할 뿐 주변 픽셀을 잠그지 않으며, 실행 파이프라인 구성과 면책 조건을 함께 살펴야 한다.
메타가 텍스트·이미지·음성·영상을 입력받는 Muse Spark Open 가중치를 공개했다. 총 816B 중 토큰당 약 42B를 활성화하는 구조지만 전체 가중치와 긴 맥락 캐시를 위한 대규모 메모리가 필요하다. 공개 모델 카드의 실행 조건과 이용 규정은 운영 환경에 맞춘 면밀한 배포 판단을 요구한다.
GitHub가 코파일럿의 HydraFusion에 단계별 추론 수준과 병렬 검토 구조를 적용하고 Max 옵션을 추가했다. 연구 프리뷰 상태로 운영되며 참여 모델별 요율이 부과된다.
Ai2가 100km 기후 모사와 3km 다운스케일링을 결합한 HiRO-ACEv2를 선보였다. 수치 모델의 극한값 통계를 저비용으로 재현하는 데 초점을 맞추며 바람과 해면기압을 함께 다루지만, 관측 기반 일기예보나 미래 온난화 시나리오에 곧바로 적용할 수 있는 체계는 아니다.
오픈AI가 공개한 Amp 사례는 기획·문서·디자인과 에이전트 조율로의 확장을 다룹니다. ChatGPT 구독 연동은 지원 모델 호출만 전환하며 orb와 음성 등 부가 비용은 별도로 발생합니다.
Google.org가 AI for Science 공모로 선정한 17개 조직에 총 3,600만 달러를 지원한다고 밝혔다. 기후·환경과 생명과학 과제가 포함되며 6개월 기술 지원 프로그램은 선택 사항이다. 기후 모델 MOSAIC의 공개 계획을 대조해 연구 지원과 이미 입증된 성과를 구분한다.
구글 딥마인드와 구글 클라우드가 유럽 과학 연구자 최대 200명에게 AlphaFold 3을 비롯한 과학 모델 직접 접근권과 총 300만 달러 규모의 연산 크레딧을 지원한다. 공공 이니셔티브와 연계된 현물 기여이며 무제한 현금 지원과는 성격이 다르다.
서드 모먼트 리서치는 동시 1만 개, 세션당 36~48시간 규모의 AI 에이전트 연구 운영 사례를 공개했다. 핵심은 모델 선택에 그치지 않고 백테스트 연산 병목 해소, 상위 실행 흐름의 중단 감독, 고객 승인 기반 실패 유형 평가를 통합한 환경 설계에 있다.
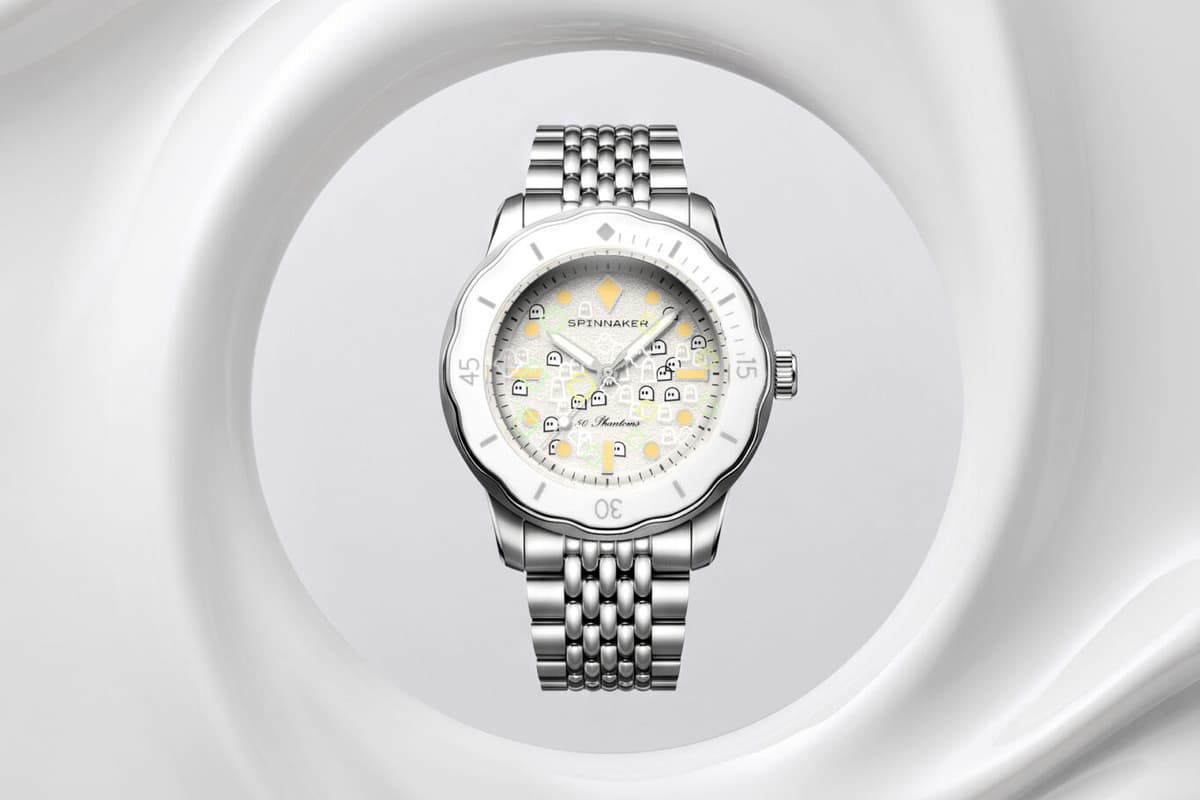
스피너커와 세콩드 세콩드가 50 팬텀스의 2026년 에디션으로 Crazy와 Quiet 두 가지 모델을 공개했다. 동일한 40㎜ 케이스를 바탕으로 유령 모티프의 노출 방식과 관찰 조건을 달리 구성했다.
GitHub가 Gemini 4 Argon을 Copilot에 정식 출시해 GA 상태로 전환했다. Pro+·Max·Business·Enterprise 플랜에 순차 배포되며, 조직 관리자의 모델 정책과 IDE 지원 버전이 실제 접근을 좌우한다. 100만 토큰당 입력 2달러, 캐시 입력 0.10달러, 출력 10달러의 한시 단가가 공시됐다.
리퀴드 AI가 24B 전체 파라미터와 약 2B 활성 파라미터, 131K 문맥의 LFM2.5-24B-A2B를 공개했다. 활성 연산량과 모델을 담는 저장·메모리 요구는 다르며, 단일 기기의 디코딩 속도와 서버 전체 처리량도 조건을 나눠 비교해야 한다.
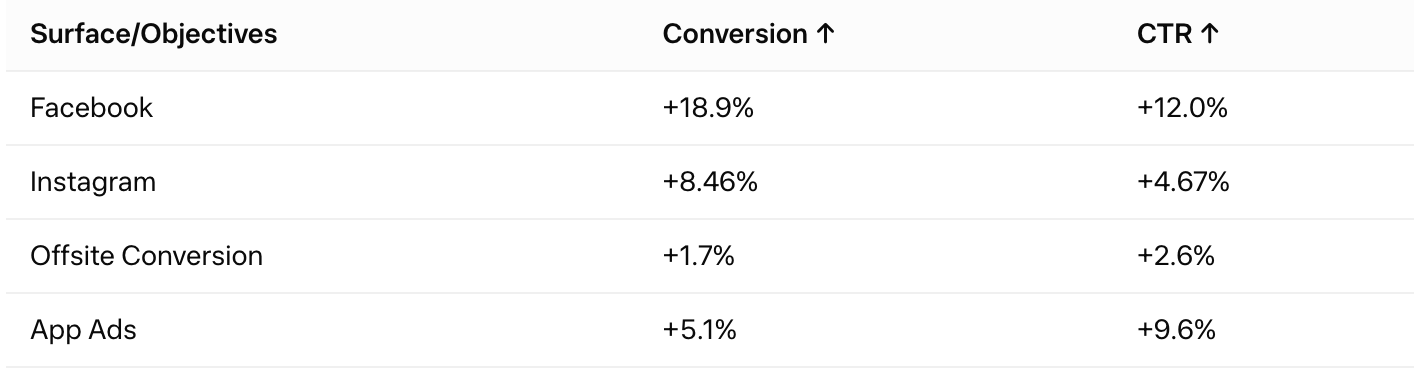
메타가 GEM의 2026 구조를 공개하며 광고 추천 기반 모델과 하위 모델 간 지식 전달을 설명했다. 회사가 밝힌 광고 성과 지표와 운영 맥락, 훈련 인프라 확장 역량은 서로 다른 배포 상태의 수치다. Kunlun, LoopFM, Solaris 등을 통해 실시간 응답 지연을 통제하고 연산과 전달 시점을 조정하는 방식을 함께 살핀다.
메타가 페이스북 피드와 릴스에 이용자가 관심사를 편집하고 자연어 문장으로 피드백을 전달하는 'Your algorithm'을 공개했습니다. 대규모 언어 모델을 랭킹 체계에 연동해 추천을 즉시 갱신한다고 설명하지만 기술 지표와 데이터 활용 범위는 명확하지 않습니다.