HTTP 200 뒤의 타인 자료, 클라우드플레어가 공개한 긴 입력 사고
클라우드플레어가 GLM-5.3의 긴 입력에서 다른 요청의 자료가 응답에 섞인 사고를 공개했다. 9월에 수정한 사건을 운영사와 추론 엔진 팀의 기록으로 읽으면, 모델의 문맥 길이와 실제 메모리 용량, 성공 응답과 자료 격리가 만나는 지점이 드러난다.
클라우드플레어가 GLM-5.3의 긴 입력에서 다른 요청의 자료가 응답에 섞인 사고를 공개했다. 9월에 수정한 사건을 운영사와 추론 엔진 팀의 기록으로 읽으면, 모델의 문맥 길이와 실제 메모리 용량, 성공 응답과 자료 격리가 만나는 지점이 드러난다.
허깅페이스가 리플렉션 빔의 가중치와 실행 경로를 소개했다. 총 5,010억 매개변수 중 토큰당 약 230억을 활성화하지만 전체 가중치를 보관할 자원은 필요하다. 100만 토큰 맥락과 여러 정밀도, 공급사 벤치마크를 실제 한국어 업무의 비용·성공률과 구분해 읽는다.
구글이 AI Mode와 AI Overviews에서 본문 인라인 링크와 관련 기사 캐러셀, 제작자 출처 연결을 강화한다. 일부는 확대 적용이고 공식 사이트 전용 구역과 프로필 연결은 시험 단계이며, 인용에는 기존 웹 색인 및 스니펫 자격이 유지된다.
엔비디아가 문서·영상 이해용 Nemotron 3.5 Super VL과 로컬 에이전트용 Bolt를 소개했다. Bolt의 24GB 목표는 특정 동시 요청 수와 문맥 길이, 정밀도를 전제로 한다. 모델의 최대 문맥과 실제 배포에서 사용할 문맥, 처리량은 구분해서 비교해야 한다.
오픈AI가 공개한 Amp 사례는 기획·문서·디자인과 에이전트 조율로의 확장을 다룹니다. ChatGPT 구독 연동은 지원 모델 호출만 전환하며 orb와 음성 등 부가 비용은 별도로 발생합니다.
구글이 2026년 핼러윈을 앞두고 Lens와 AI Mode를 활용한 준비 사례를 소개했다. 가진 옷으로 의상을 구상하고 행사·영화를 찾으며 음악 목록을 저장하는 흐름이다. 제안 이미지, 최신 행사 정보, 계정에 남는 결과는 확인 기준이 각각 다르다.
구글 딥마인드와 구글 클라우드가 유럽 과학 연구자 최대 200명에게 AlphaFold 3을 비롯한 과학 모델 직접 접근권과 총 300만 달러 규모의 연산 크레딧을 지원한다. 공공 이니셔티브와 연계된 현물 기여이며 무제한 현금 지원과는 성격이 다르다.
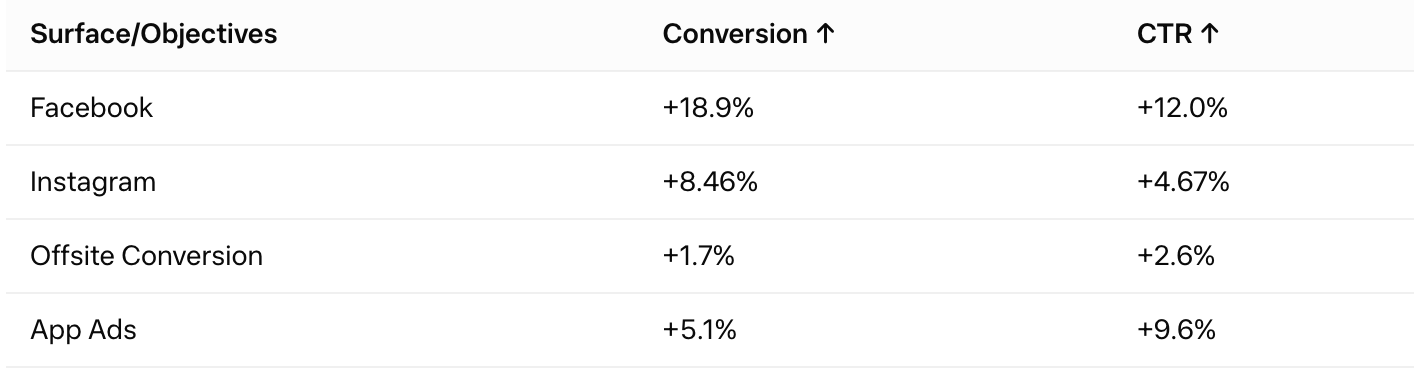
메타가 GEM의 2026 구조를 공개하며 광고 추천 기반 모델과 하위 모델 간 지식 전달을 설명했다. 회사가 밝힌 광고 성과 지표와 운영 맥락, 훈련 인프라 확장 역량은 서로 다른 배포 상태의 수치다. Kunlun, LoopFM, Solaris 등을 통해 실시간 응답 지연을 통제하고 연산과 전달 시점을 조정하는 방식을 함께 살핀다.
메타는 에이전트용 Muse Wonder와 Wonder Full을 공개했다. 일반 모델은 Meta Model API·Muse Code, Full은 Muse Code 구독자 경로로 안내됐다. 기억·장기 실행의 회사 평가와 실제 업무 완료, 현재 제공과 후속 확대 계획을 구별해 살핀다.
아사나가 브라우저 에이전트의 이력과 스크린샷 캐시를 재설계한 실험을 공개했다. 제시된 76배 비용 개선은 기존 Model B 구성과 최적화한 GPT-6.1 Sol 구성을 비교한 추정 모델 비용이며, 동일 모델 내부의 개선과 고유한 실험 조건을 분리해 파악해야 한다.
리퀴드 AI가 텍스트 생성을 배제하고 단일 순방향 연산으로 결정을 내리는 오픈 가중치 모델 Open d1 2종을 공개했다. 엣지 기기에서 수십 밀리초 단위 저지연 연산을 지원하지만, 자체 벤치마크 결과 의존도와 입력 사양 제한 등 실무 적용 시 확인할 과제도 명확하다.
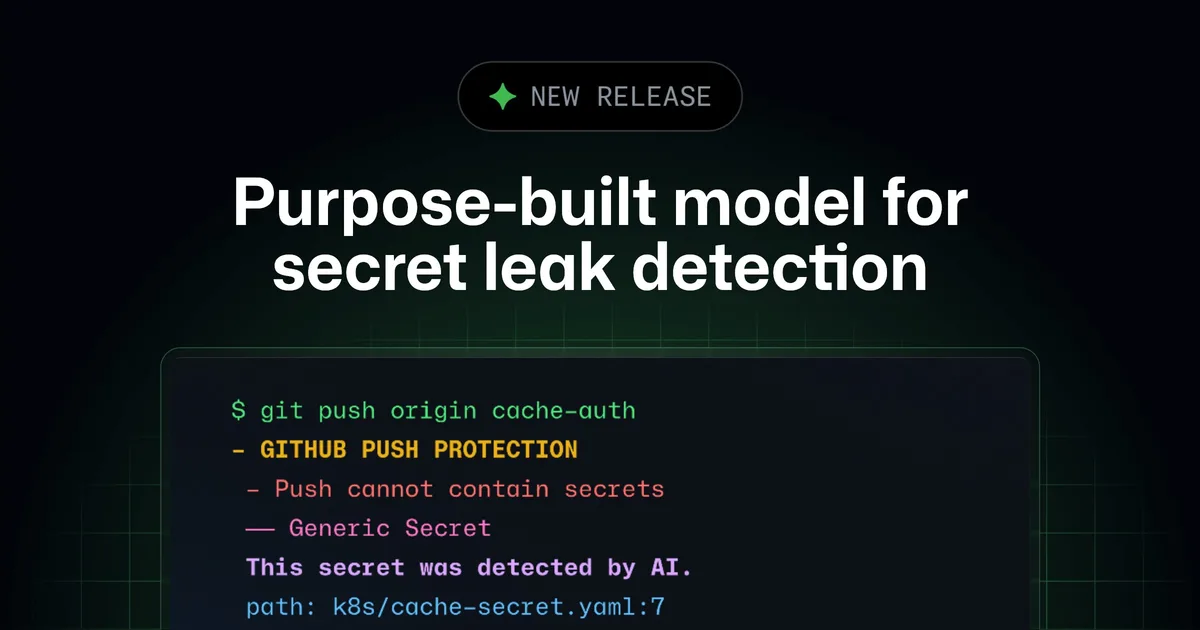
GitHub이 정형화된 토큰 형태가 없는 패스워드를 문맥으로 식별하는 전용 경량 AI 분류기를 도입했습니다. 사후 알림은 무상 자동 전환되지만 사전 예방 기능에는 GitHub AI 크레딧 과금이 적용됩니다.
GitHub Copilot CLI가 1.0.94-0 버전부터 로컬에 구동 중인 Ollama 모델을 자동으로 감지하고 세션에 즉시 연결하는 기능을 추가했다. 터미널 환경에서 모델 전환 편의성은 높아졌으나, 로컬 모델 선택이 오프라인 모드나 텔레메트리 차단을 의미하지는 않아 사내 보안 규정 검토가 요구된다.
구글이 텍스트·시각·음성을 768차원 단일 벡터 공간으로 결합한 오픈 웨이트 모델 임베딩젬마 2를 공개했습니다. 740M 모듈형 아키텍처와 컨텍스트 확장으로 온디바이스 검색 효율을 끌어올렸으나, 정밀도 제약과 벤치마크 해석을 둘러싼 실무적 점검 사항도 확인됩니다.
글로벌 통신사들이 폐쇄형 인공지능 의존에서 벗어나 통제권과 맞춤형 역량을 확보하기 위해 오픈 모델 도입을 확대하고 있습니다. 통신 특화 30B 모델과 파이프라인이 공개되면서 비용 절감과 데이터 거버넌스 수립이 본격화되는 추세입니다.
깃허브가 코파일럿 전반에서 제미나이, 키미, 클로드 계열의 구형 모델 4종 지원을 공식 중단하고 최신 모델로의 이전을 권고했다. 엔터프라이즈 환경에서의 정책 설정과 워크플로 갱신 요령을 짚어본다.
OpenAI가 GPT-6 계열의 모델 선택과 추론 수준, 지시문, 장시간 작업 운영을 정리한 가이드를 공개했다. Astra·GPT-6.1 Sol·Luna의 역할과 API 가격을 구분하며 대표 업무에서 품질·시간·비용을 확인하도록 안내한다. 단가와 전체 비용, 기능과 실제 운영의 차이를 살핀다.
앨런 인공지능 연구소(Ai2)가 과학 문헌 발췌문을 바탕으로 구조화된 인용 보고서를 신속히 작성하는 오픈 웨이트 모델 'AstaBrief 8B'를 공개했다. 기존 상용 다단계 파이프라인 대비 3.5배 빠른 생성 속도를 보였으나, 외부 벤치마크에서는 인용 정밀도 저하와 의미적 왜곡이라는 기술적 한계가 확인됐다.
클라우드플레어가 선택지별 확률을 반환하는 Clef와 Clef-flash를 Workers AI 및 공개 가중치로 제공한다. 자유로운 문장 생성 대신 정해진 스키마의 판단을 수행하며 맞춤 학습은 엔지니어와 함께 지원한다. 자체 평가의 속도·품질 차이와 향후 셀프서비스 학습 계획을 구분해 살펴본다.
OpenAI가 7월 관찰된 대규모 추론 추출 활동 차단 사실을 9월 30일 공개했다. 발표된 수치는 시도 요청 횟수일 뿐 실제 유출량이 아니며 특정 인물 귀속도 회사의 평가로 남아 있다.
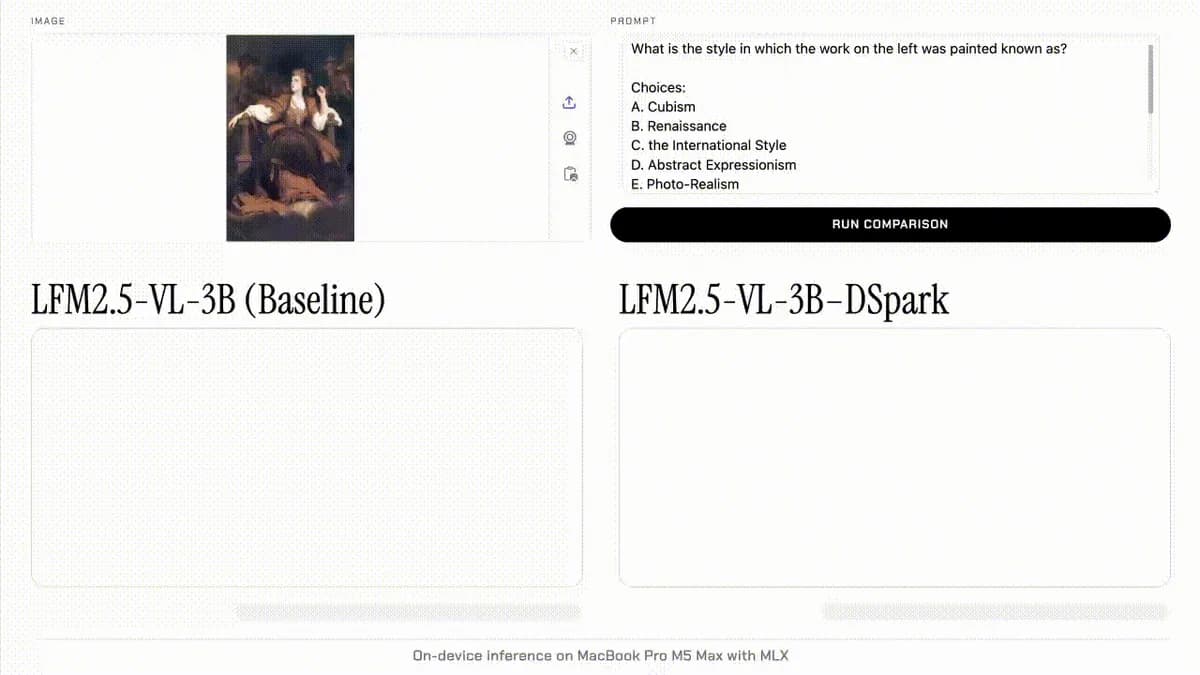
Liquid AI가 LFM2.5-VL-3B 모델을 위한 실험용 DSpark 초안 모델을 공개했다. 약2억8000만 매개변수가 추가되며 본 모델이 후보 토큰을 검증하는 방식이다. 특정 장비의 디코딩은 최대3.13배 빨라졌으나 이미지 처리와 입력 단계는 가속되지 않아 전체 처리 속도와 차이가 있다.
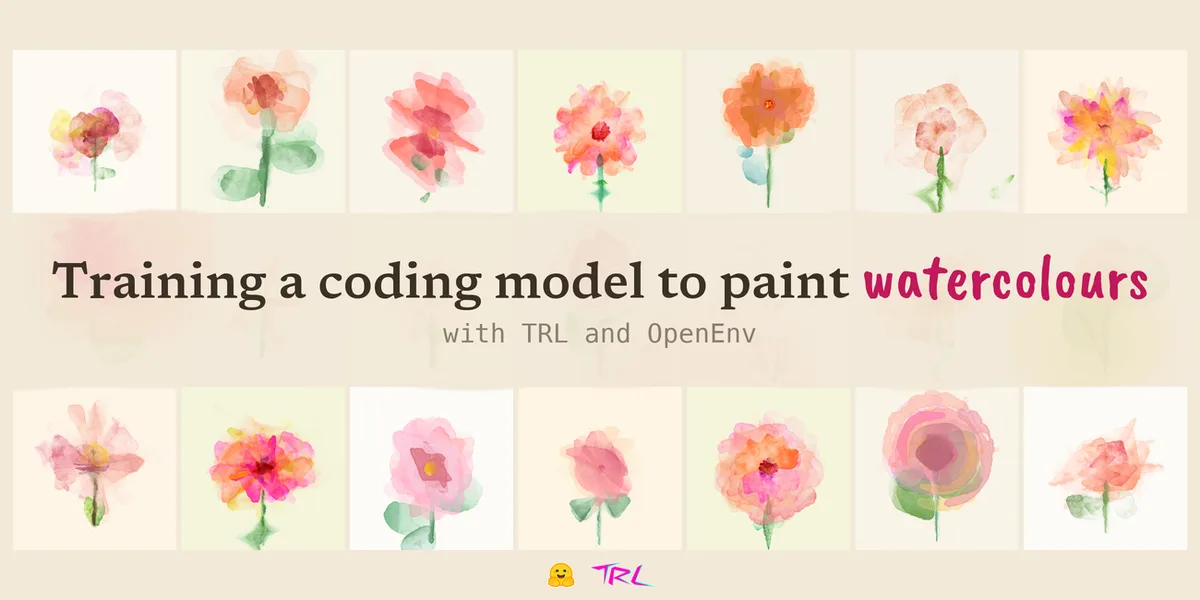
허깅페이스가 TRL과 OpenEnv를 활용해 코딩 모델이 수채화 표현을 생성하도록 학습시킨 실험을 공개했다. 사람이 분류한 178점의 참조 풀과 보상 설계를 비교하며 평가 기준과 재현 한계를 구체화했다.
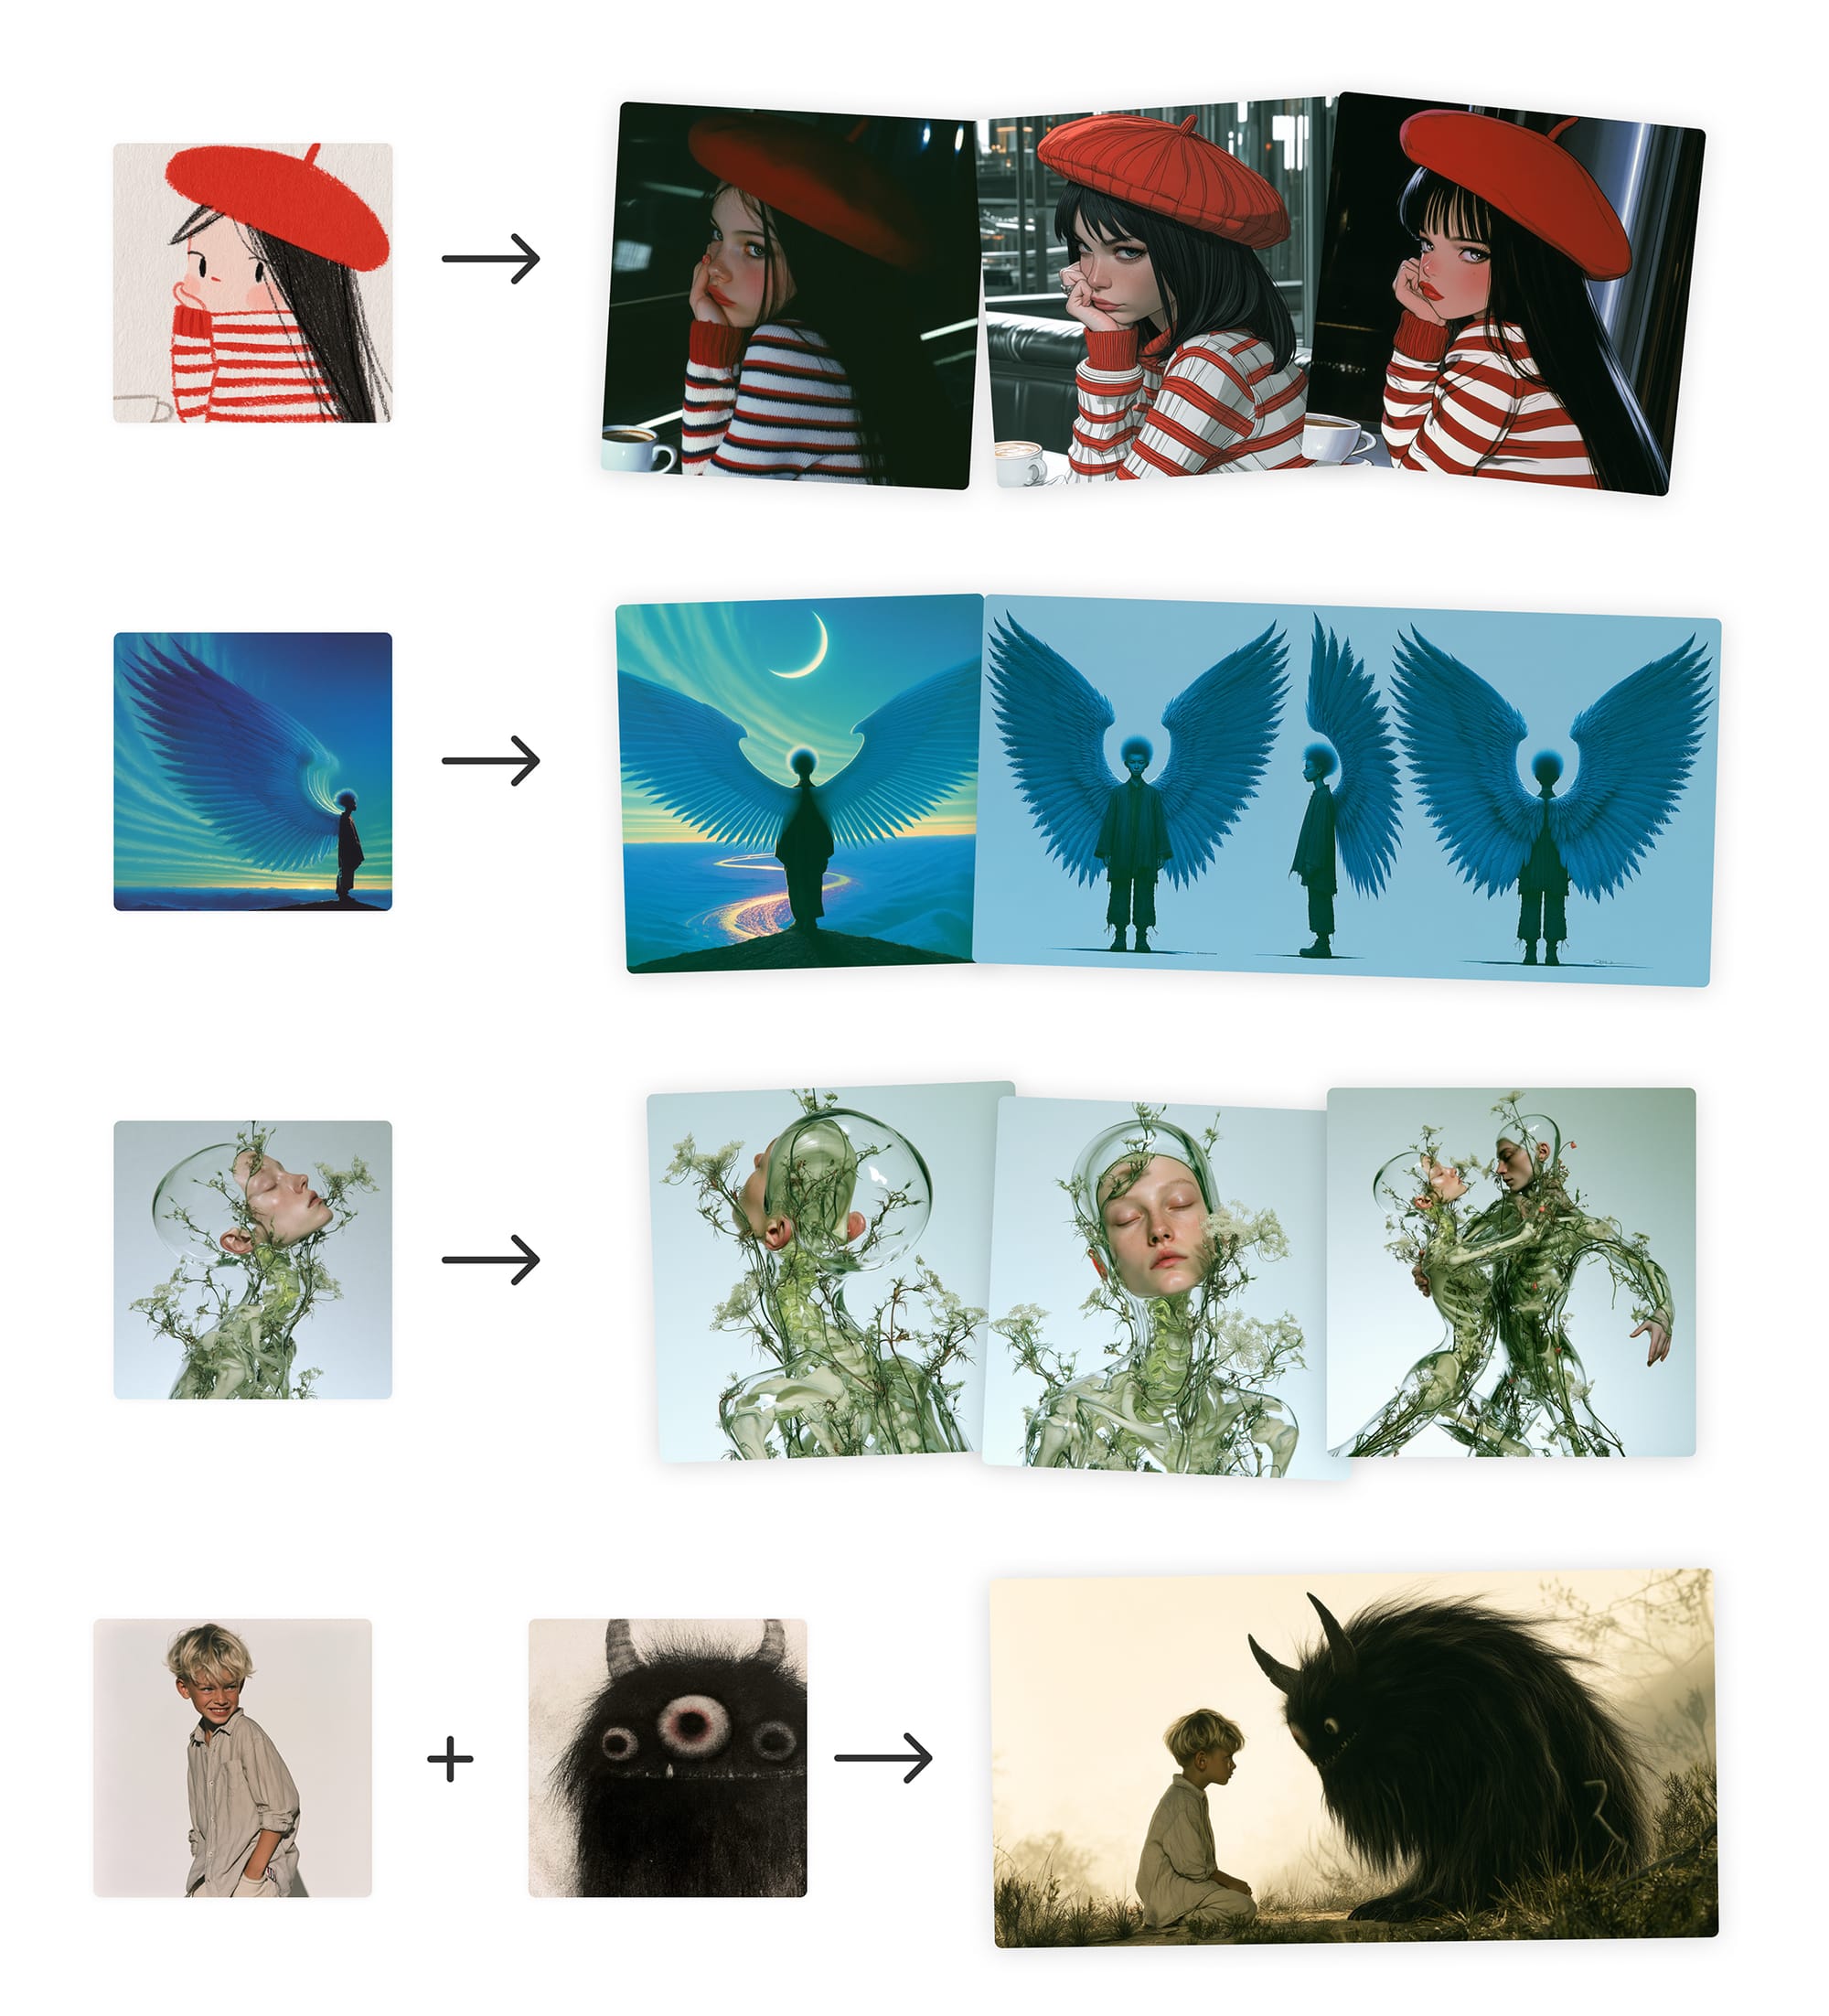
미드저니가 2026년 8월 27일 자연어 지시 편집과 최대 4장의 이미지 참조 기능을 갖춘 V8.2 전용 편집 모델을 공개 테스트 형태로 선보였습니다. 기존 옴니 레퍼런스를 대체하고 인·아웃페인팅을 포괄하지만, 아키텍처 비공개와 기능 호환 제약 등 실무 도입 전 확인해야 할 과제도 함께 공존합니다.